国自然生信实战20讲 · 第03讲 · 把问题和数据选对
系列目录:国自然生信实战20讲(当前第3讲)
- 第01讲:国自然里的生信从哪里开始?把研究方向拆成可分析的问题
- 第02讲:公共数据怎么选?找到与你的研究问题真正匹配的数据集
- 第03讲:下载数据后先做什么?表达矩阵、样本分组和基因编号整理(本篇)
- 第04讲:为什么有些数据不能直接分析?看懂异常样本与批次效应
- 第05讲:差异表达怎么做才有解释价值?从统计显著到生物学意义
- 第06讲:富集分析结果太多怎么办?从通路列表提炼研究主线
- 第07讲:哪些基因值得继续研究?把表达、功能和文献证据放在一起
- 第08讲:基因升高说明了什么?区分单个基因变化与功能状态变化
- 第09讲:换一批数据还成立吗?手把手做独立队列验证
- 第10讲:差异真的是疾病造成的吗?识别混杂因素与缺失信息
- 第11讲:换个阈值结论就变了?用敏感性分析检查结果稳定性
- 第12讲:两个队列结果不一致怎么办?从差异中发现研究边界
- 第13讲:为什么整体组织的变化还不够?用单细胞定位表达来源
- 第14讲:是细胞变多了,还是细胞内部表达变了?拆解两种解释
- 第15讲:关键细胞发生了什么变化?从细胞类型走向功能状态
- 第16讲:细胞之间可能如何影响彼此?把通讯线索变成可验证的问题
- 第17讲:从一堆图到一个科学假说:整理现有证据与关键缺口
- 第18讲:生信之后做哪些实验?把候选线索拆成逐步验证的任务
- 第19讲:样本量和验证队列怎么规划?用模拟看清研究可行性
- 第20讲:把整个项目串起来:形成可复现分析包和完整技术路线
点击目录按篇次顺序学习;文末复现包包含全系列代码与起始数据。
一张矩阵里最容易出错的是对应关系
表达矩阵看起来很简单:一行一个特征,一列一个样本,单元格里是表达值。真正危险的错误往往不来自复杂算法,而来自列顺序与分组表不一致。假设表达矩阵第一列属于对照,分组表第一行却属于患者,软件仍可能顺利拟合模型、生成漂亮火山图,结果却已经失去意义。因此,本篇先检查标识和尺度,再谈后续统计。
承接第02篇,我们已经确定发现队列的85个样本。本篇要准备两类标准文件:基因为行、样本为列的表达矩阵,以及每个样本一行的注释表。标准化的目标是让文件之间的对应关系清晰,不是把所有数据都变成同一种数值分布。请特别区分数据整理和统计归一化,这两个词常被混用,却会引出完全不同的操作。
先确认拿到的是哪一种表达值
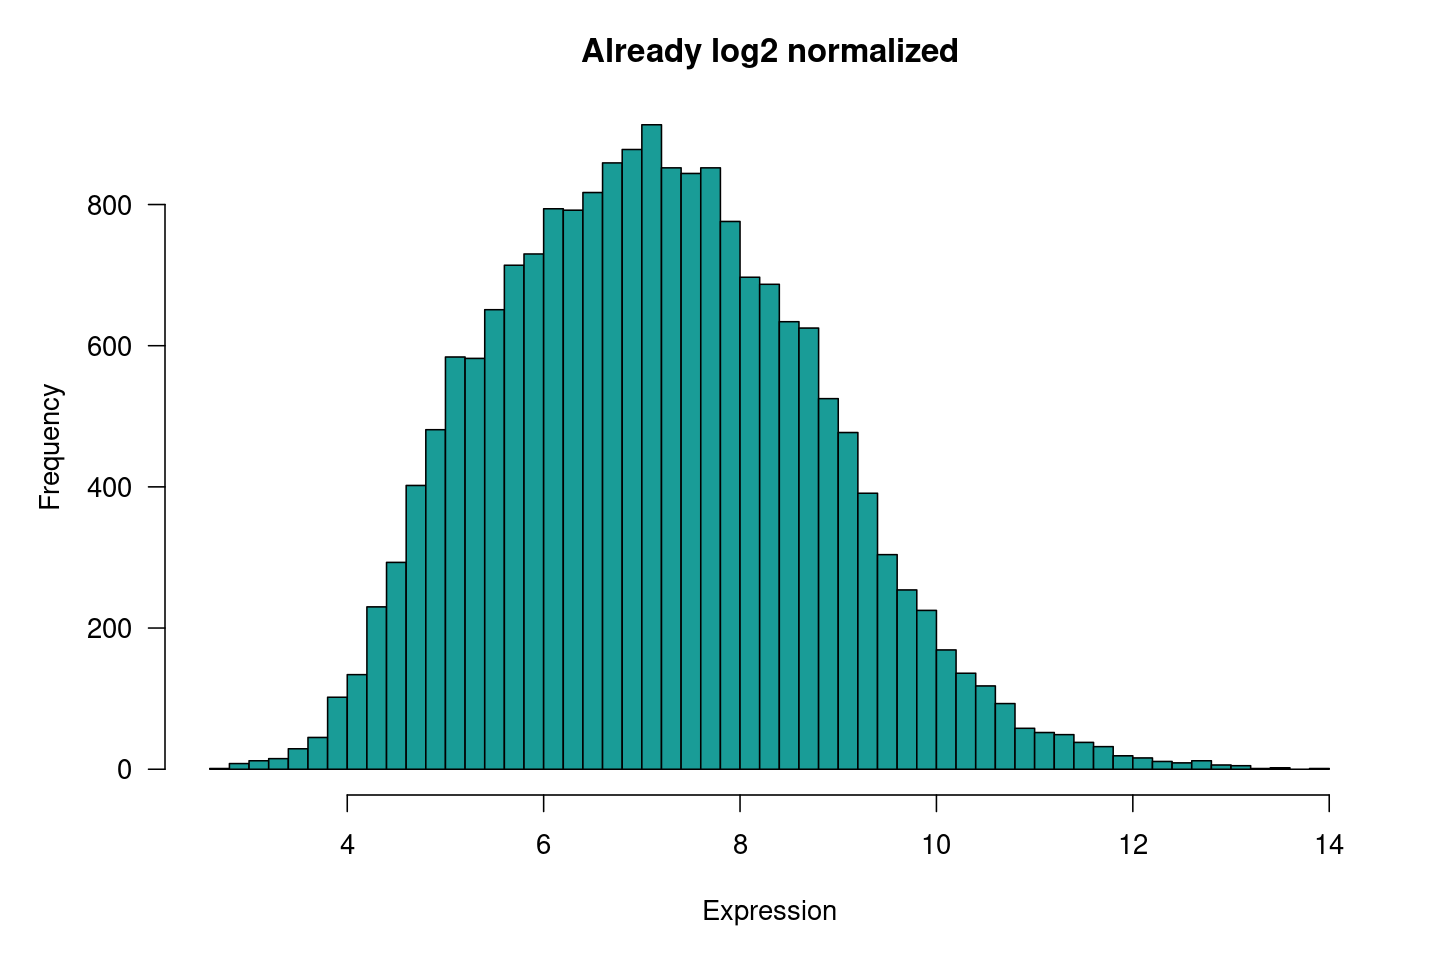
本系列两个组织队列都是芯片数据,提交者说明已经进行了RMA处理。GSE75214明确说明输出为log2表达值,实际数值范围也与这一说明相符;我们下载的GSE87466处理后矩阵同样按其说明和分布核对使用。对于这类数据,本教程不再次进行计数归一化,也不把小数四舍五入后送入面向原始测序计数的模型。
仅看最大值或是否有小数不能完全确认尺度,必须同时检查数据处理说明、平台与分布。重复取对数会压缩差异,直接把已对数化数据当作原始强度也会造成错误解释。最稳妥的做法是在数据字典里写明来源、处理过程和当前单位;若提交说明模糊,先追查原始论文及补充材料,而不是凭经验默认。
探针编号不能直接当作基因名
芯片矩阵原始行名往往是探针或转录本簇编号。平台注释提供它们与基因符号的映射。我们分别使用GPL6244和GPL13158的注释,不把一个平台的映射套到另一个平台。映射后会遇到无符号、一个探针对应多个基因、多个探针对应同一个基因等情况,每一种都需要明确规则。
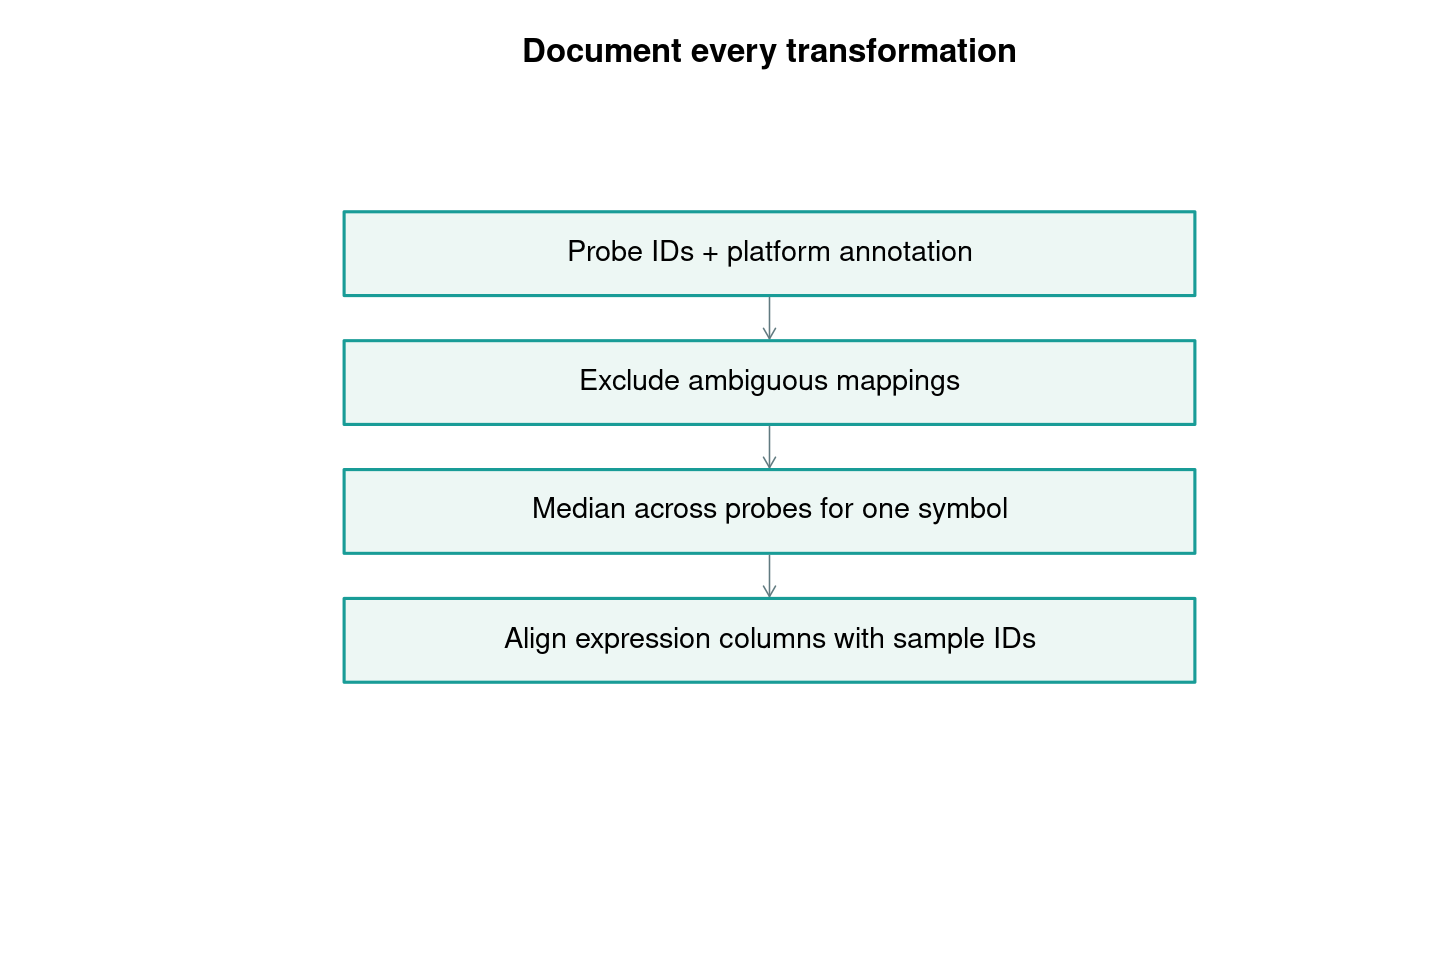
本教程采用一个透明的简化策略:排除缺失或不明确的符号映射;多个探针对应同一个明确基因符号时,在每个样本中取中位数。中位数是教学用汇总方案,并不保证在所有芯片项目中最合适。对于存在不同转录本、探针性能差异或基因特异性不足的重点候选,正式研究仍应回到探针层面检查,必要时采用更精细的注释及敏感性分析。
经过这一过程,发现队列得到19036个基因,验证队列得到21117个基因。两个数字不同是平台和映射范围不同的结果,不意味着较少的一组质量更差。后面做跨队列比较时,会明确使用共同测到的基因,不能把某个平台没有覆盖的基因记成表达为零,也不能把缺失测量解释成没有生物学作用。
| 文件或字段 | 表示什么 | 必须通过的检查 |
|---|---|---|
| 表达矩阵列名 | 样本唯一标识 | 无重复,能在注释表找到 |
| 注释表sample列 | 同一套样本标识 | 按表达列名重排后完全一致 |
| 表达矩阵行名 | 明确映射后的基因符号 | 无空值,汇总后无重复 |
| group字段 | 当前比较的组别 | 对照设为模型参照水平 |
| 数值单元格 | 已处理表达值 | 有限数值,尺度有来源说明 |
用名字匹配,别靠当前位置
很多表格软件会在排序后改变行序,因此我们不依赖“它们原来应该是一致的”。代码先检查两边样本集合相同,再用表达矩阵列名去匹配注释表的sample字段,最后检查重排后的顺序完全一致。集合相同只能说明没有缺样本;顺序一致才说明每一列使用了正确的分组。两个检查缺一不可。
同样,不应在没有理由时批量改写样本名称中的短横线、下划线或其他字符。有些软件会自动把名称转换成合法变量名,造成两个文件的标识形式不同。读入时保留原始列名,遇到差异时输出具体不匹配的名称,再判断是否存在可证明的转换规则。不要用“按顺序补回去”掩盖无法解释的对应问题。
用一个小错误检验流程是否可靠
建议复制样本表作为练习文件,随机打乱行序,然后仅根据样本名称恢复。恢复后应使用严格的一致性检查,而不是只看前几行似乎正确。接下来删去一个样本标识或制造重复,观察程序是否停止。如果流程仍然默默继续,说明它缺少必要保护。这个练习不用于制造正式结果,只用于理解为什么输入检查必须先于分析。
R中的矩阵取子集还容易遇到维度自动简化的问题。只剩一行或一列时,某些操作会把矩阵变成向量,后续函数可能得到意外输入。本系列在关键位置使用drop=FALSE保留维度。读者不需要一开始记住所有语法,但应学会在每一步检查对象的行数、列数和名称,确认它仍然代表预期的数据结构。
缺失值也要分清来源。表达文件中原本缺失、基因映射失败、样本匹配失败,分别指向不同问题。把它们全部填为零,会让未测量被解释成低表达;直接删除包含缺失的所有行,则可能改变背景基因范围。处理前先输出缺失位置和产生环节,才能选择有依据的方案。当前教学输入已经完成有限值检查,不要求读者再做未经说明的填补。
多探针汇总后,可以为重点候选额外保存一个探针到基因的对照表。若某基因不同探针方向相反,可能涉及特异性、转录本或质量问题,应回查后再解释。简单平均或中位数能给出一个数字,但不能替代判断。对于后续实验优先级最高的候选,这一步通常值得单独完成。
请把数据字典与矩阵一起交接。至少说明行列含义、当前尺度、参考组、基因映射规则和缺失处理。接手者不应依靠文件名猜测,也不应从数值范围推断全部处理历史。一个清楚的数据字典,能让后续所有章节建立在相同理解之上。
运行方法与输出检查
下载文末完整复现包后先解压,将R的工作目录切换到其中的workbook目录,再运行下方命令。不要只复制某一行分析语句,因为公共函数、输入文件和前序结果需要保持同一套目录关系。本篇读取发现表达矩阵和样本表;附件已包含这些起始文件,因此可以单独学习本篇,也可以按顺序运行全系列。
Rscript scripts/03.R
脚本会把本篇表格和三张图写入results/03目录。运行结束后先检查输出表中的样本标识、列名与正文说明,再打开图片核对坐标和分组。出现报错时保留原始输入,先查工作目录、文件完整性及依赖版本,不要通过改分组或填补不存在的数据来让代码继续。下载包内的版本记录来自实际验证环境,安装时请保持R与Bioconductor依赖相容。
下面提供本篇完整R脚本;它会载入scripts/common.R中的公共函数。共用函数、数据整理代码和逐步日志也包含在复现包中,便于检查每一步的输入与输出。
source("scripts/common.R")
o<-start(3);x<-read_expr("discovery");m<-read_meta("discovery")
stopifnot(!anyDuplicated(rownames(x)),!anyDuplicated(m$sample),setequal(colnames(x),m$sample),all(is.finite(x)))
m<-m[match(colnames(x),m$sample),];stopifnot(identical(colnames(x),m$sample))
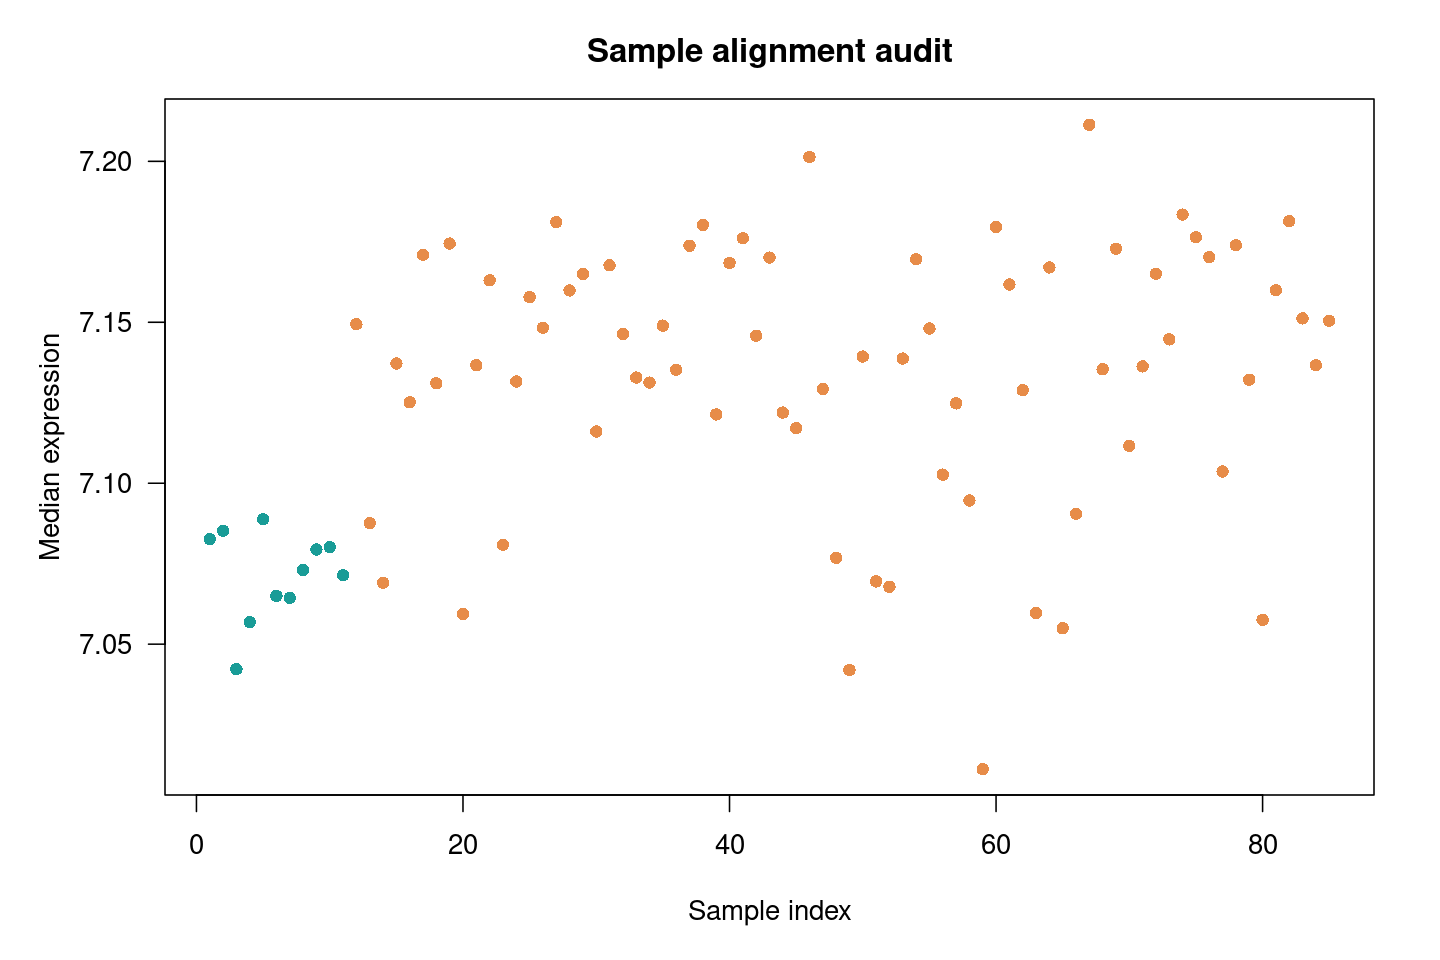
audit<-data.frame(sample=m$sample,group=m$group,median=apply(x,2,median),missing=colSums(is.na(x)))
save_table(audit,paste0(o,"/matrix_audit.csv"))
fig(paste0(o,"/fig1.png"),hist(as.numeric(x[,1]),breaks=50,col="#199C97",main="Already log2 normalized",xlab="Expression"))
fig(paste0(o,"/fig2.png"),plot(audit$median,pch=16,col=cols[m$group],xlab="Sample index",ylab="Median expression",main="Sample alignment audit"))
fig(paste0(o,"/fig3.png"),flow(c("Probe IDs + platform annotation","Exclude ambiguous mappings","Median across probes for one symbol","Align expression columns with sample IDs"),"Document every transformation"))
如何阅读本篇生成的检查图
第一张图展示一个样本的表达分布,帮助确认数据已经处于适合当前流程的尺度。第二张图展示每个样本的中位表达,颜色对应分组。它不是显著性检验,也不能仅凭一个点偏高就删掉该样本。它的用途是提示是否存在值得回查的分布异常,例如某列读入方式不同、文件混入其他类型数据,或者真实的样本质量问题。
第三张图把探针注释、歧义排除、重复汇总和样本对齐串起来。建议把它与原始文件一起保存,因为后续每个结果都依赖这些选择。若以后改变映射规则,应保留旧版与新版输出,比较候选结论是否受到影响。对于最终要进入实验验证的基因,检查具体探针的行为,比只看汇总矩阵中的一行更能发现问题。
四种报错值得主动触发
样本名称重复时,程序应该停止,先查清是技术重复、同一患者多个部位,还是复制错误;注释表缺少某列样本时,应该列出缺失名称;矩阵出现非数值字符串时,应追查原文件;基因映射为空时,应确认平台注释是否正确。这些报错不是需要被关闭的障碍,而是在阻止错误继续传播。随意删除报错行或把缺失值统一填零,可能让代码运行,却无法修复数据含义。
读者可以做一个小练习:把注释表随机打乱,再运行样本匹配步骤。正确的流程应该能够按名称恢复顺序。随后人为改掉一个样本名称,程序应当停止而不是继续。这比盯着一张已经生成的热图更能检验整理过程是否可靠。练习仅在副本上进行,不要修改原始下载文件。
完成本篇后,表达矩阵与样本注释已成为后续共用输入。下一篇将检查样本之间的结构、异常线索和潜在批次问题。即使本篇所有结构检查通过,也不代表样本质量与研究设计问题已经全部解决;它只保证我们开始讨论的是对应正确、尺度明确的数据。
代码、数据与继续阅读
下载完整复现包:20篇R脚本、整理输入、起始结果、运行说明与版本记录。包含公共数据教学子集;不包含任何实际实验结果。解压后先阅读README。
承接第02讲:公共数据怎么选?找到与你的研究问题真正匹配的数据集。
下一篇第04讲:为什么有些数据不能直接分析?看懂异常样本与批次效应。
数据与方法来源
数据与方法核查日期:2026年11月16日。本文为教学二次分析;具体适用范围见正文。
需要把方法用到自己的数据中?
如果你还在判断研究问题与公共数据能否匹配,可以准备疾病方向、取材位置和现有资料概况,沟通数据可行性与分析范围。 联系云生信,说明当前研究任务。


