国自然生信实战20讲 · 第17讲 · 转成可检验的研究设计
系列目录:国自然生信实战20讲(当前第17讲)
- 第01讲:国自然里的生信从哪里开始?把研究方向拆成可分析的问题
- 第02讲:公共数据怎么选?找到与你的研究问题真正匹配的数据集
- 第03讲:下载数据后先做什么?表达矩阵、样本分组和基因编号整理
- 第04讲:为什么有些数据不能直接分析?看懂异常样本与批次效应
- 第05讲:差异表达怎么做才有解释价值?从统计显著到生物学意义
- 第06讲:富集分析结果太多怎么办?从通路列表提炼研究主线
- 第07讲:哪些基因值得继续研究?把表达、功能和文献证据放在一起
- 第08讲:基因升高说明了什么?区分单个基因变化与功能状态变化
- 第09讲:换一批数据还成立吗?手把手做独立队列验证
- 第10讲:差异真的是疾病造成的吗?识别混杂因素与缺失信息
- 第11讲:换个阈值结论就变了?用敏感性分析检查结果稳定性
- 第12讲:两个队列结果不一致怎么办?从差异中发现研究边界
- 第13讲:为什么整体组织的变化还不够?用单细胞定位表达来源
- 第14讲:是细胞变多了,还是细胞内部表达变了?拆解两种解释
- 第15讲:关键细胞发生了什么变化?从细胞类型走向功能状态
- 第16讲:细胞之间可能如何影响彼此?把通讯线索变成可验证的问题
- 第17讲:从一堆图到一个科学假说:整理现有证据与关键缺口(本篇)
- 第18讲:生信之后做哪些实验?把候选线索拆成逐步验证的任务
- 第19讲:样本量和验证队列怎么规划?用模拟看清研究可行性
- 第20讲:把整个项目串起来:形成可复现分析包和完整技术路线
点击目录按篇次顺序学习;文末复现包包含全系列代码与起始数据。
图已经很多,科学假说为什么仍然不清楚
从差异表达到单细胞状态,前16篇已经产生不少图表。此时最容易出现的错觉是:图越多,研究基础越充分。实际上,多张图可能来自同一批数据,回答的也可能是同一个关联问题。要让分析真正服务于课题设计,需要把图重新组织为证据清单,明确哪些观察已经成立,哪些解释仍有竞争可能,哪些环节完全没有实验支持。
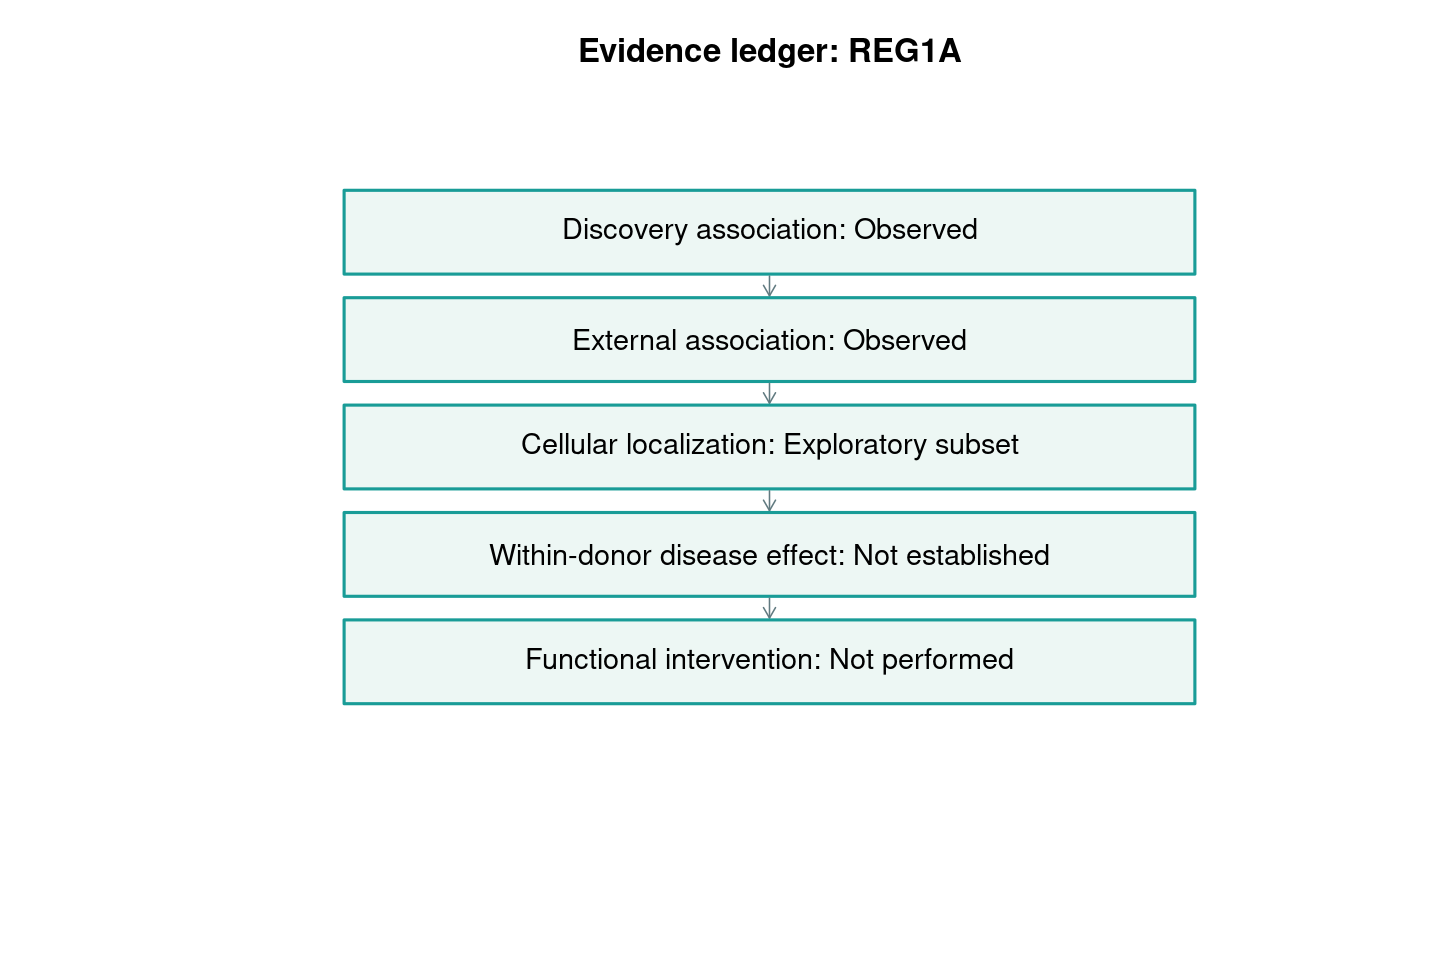
本篇围绕教学候选REG1A汇总现有结果。组织发现与外部验证支持当前样本范围内的表达关联;单细胞子集提供上皮状态相关的探索线索;供体配对与完整临床调整仍存在限制;功能干预尚未实施。把这些内容并列展示,比直接画一条从候选到疾病的实线箭头更能说明我们真正知道多少。
为每条证据写三个字段
证据表至少包括具体观察、来源和允许的判断。比如“发现集中REG1A在患者组更高”是观察,GSE75214及本次分析输出是来源,“支持组织层面的关联”是允许的判断。若再写成“促进屏障破坏”,就超出了该观察能够承担的范围。这个检查适用于每一张图,不只适用于候选基因。
还应该保留状态字段,例如已观察、探索性、尚未确证或未实施。未实施不意味着没有价值,它明确了后续研究需要完成的工作。不要为了让技术路线完整,就给空白环节配上模拟实验图而不标注。研究计划图可以展示预期逻辑,但图题和正文必须说明它是计划,不是结果。
为一张机制示意图规定箭头含义
建议把已经观察到的关联与待检验的作用关系使用不同线型,并在图注解释。实线也不应自动代表因果,应明确它对应的是测量关联、已完成干预还是文献背景。若一条箭头没有任何具体数据或来源,就把它标成假说,并列出未来哪项实验能检验。图的美观不能替代证据等级。
本案例中,组织关联可以连接候选与疾病分组,但尚不能直接连接候选与屏障损伤的方向。单细胞状态提供来源线索,却没有确证完整供体层级效应。通讯示例也没有建立REG1A的上游关系。因此,最终路线不把这些章节硬拼成一个已经闭合的分子通路,而是保留各自的作用范围。
请尝试删除一张图,问最终判断是否改变。如果删掉一张同源热图后结论完全不变,它可能主要用于展示,而不是增加独立证据。展示仍然可以有价值,但不应在证据数量中重复计数。相反,一个不利的外部队列结果可能只占一张小表,却对判断有更大影响。
证据台账也应记录时间和版本。候选名单改变、样本注释更新或分析规则修正后,相关结论需要回查。不要只更新最新图,而让旧的结论文字继续留在其他文档中。一个集中保存的台账能够帮助团队保持一致,尤其是在分析与实验由不同成员完成时。
最后,为最关键的缺口写出最小下一步。不是笼统的“开展机制研究”,而是能够在当前条件下判断是否继续的具体检查,例如确认模型表达、获得一组关键临床信息或完成独立定位。优先解决能改变决策的缺口,有助于把有限资源用在最重要的不确定性上。
运行方法与输出检查
下载文末完整复现包后先解压,将R的工作目录切换到其中的workbook目录,再运行下方命令。不要只复制某一行分析语句,因为公共函数、输入文件和前序结果需要保持同一套目录关系。本篇读取第09篇验证结果与教学候选;附件已包含这些起始文件,因此可以单独学习本篇,也可以按顺序运行全系列。
Rscript scripts/17.R
脚本会把本篇表格和三张图写入results/17目录。运行结束后先检查输出表中的样本标识、列名与正文说明,再打开图片核对坐标和分组。出现报错时保留原始输入,先查工作目录、文件完整性及依赖版本,不要通过改分组或填补不存在的数据来让代码继续。下载包内的版本记录来自实际验证环境,安装时请保持R与Bioconductor依赖相容。
下面提供本篇完整R脚本;它会载入scripts/common.R中的公共函数。共用函数、数据整理代码和逐步日志也包含在复现包中,便于检查每一步的输入与输出。
source("scripts/common.R")
o<-start(17);r<-read.csv("results/09/replication.csv");lead<-lead_gene();l<-r[r$gene==lead,]
e<-data.frame(evidence=c("Discovery association","External association","Cellular localization","Within-donor disease effect","Functional intervention"),status=c("Observed","Observed","Exploratory subset","Not established","Not performed"),source=c("GSE75214","GSE87466","GSE116222","Donor pairing not verified","Future experiment"))
save_table(e,paste0(o,"/evidence_ledger.csv"))
fig(paste0(o,"/fig1.png"),flow(paste(e$evidence,e$status,sep=": "),paste("Evidence ledger:",lead)))
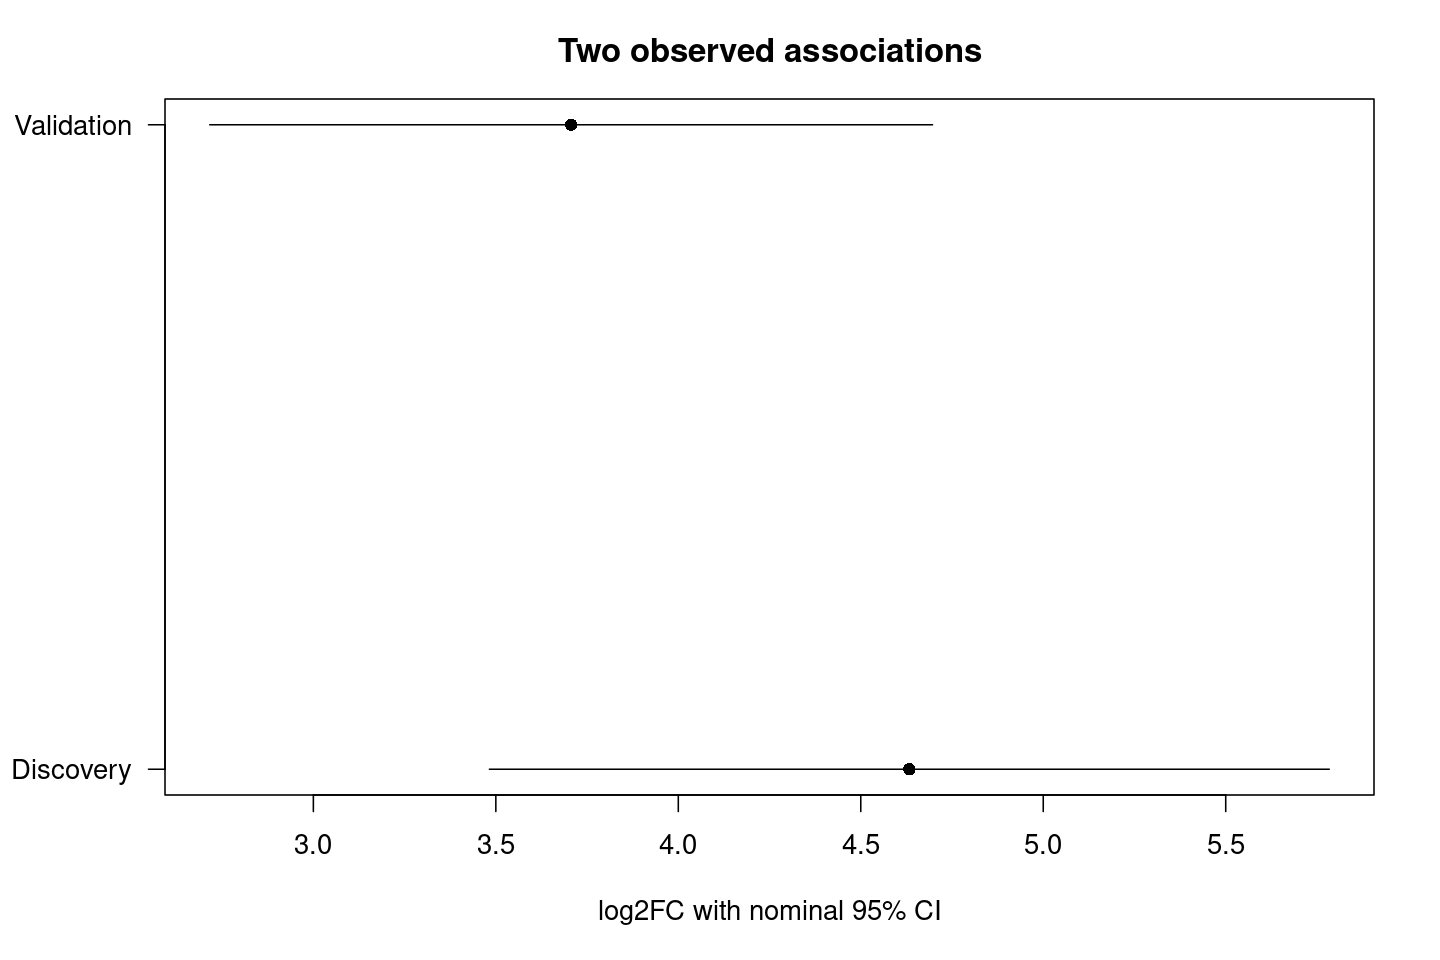
fig(paste0(o,"/fig2.png"),{plot(c(l$logFC_D,l$logFC_V),1:2,pch=16,xlim=range(c(l$CI.L_D,l$CI.R_D,l$CI.L_V,l$CI.R_V)),yaxt="n",xlab="log2FC with nominal 95% CI",ylab="",main="Two observed associations");axis(2,1:2,c("Discovery","Validation"));segments(c(l$CI.L_D,l$CI.L_V),1:2,c(l$CI.R_D,l$CI.R_V),1:2);abline(v=0,lty=2)})
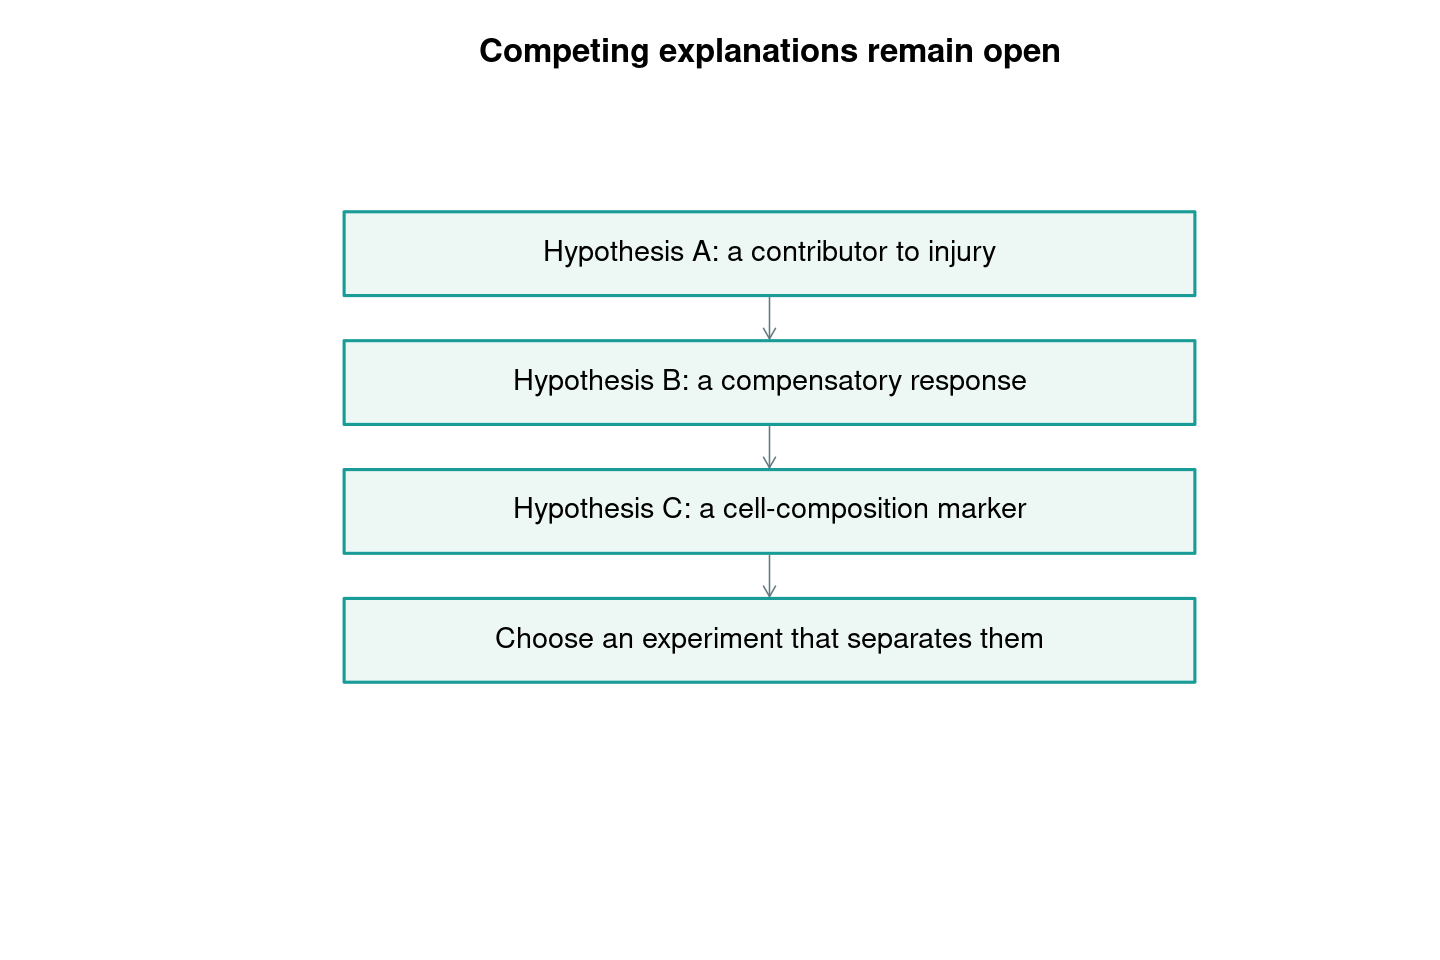
fig(paste0(o,"/fig3.png"),flow(c("Hypothesis A: a contributor to injury","Hypothesis B: a compensatory response","Hypothesis C: a cell-composition marker","Choose an experiment that separates them"),"Competing explanations remain open"))
| 证据项目 | 当前状态 | 能支持什么 | 还缺什么 |
|---|---|---|---|
| 发现队列关联 | 已观察 | 当前组织比较存在表达变化 | 更完整混杂信息 |
| 外部队列关联 | 已观察 | 变化方向获得另一研究支持 | 更匹配的临床验证 |
| 细胞来源 | 教学子集探索 | 候选可能出现的上皮状态 | 完整注释及供体层级分析 |
| 功能干预 | 未实施 | 只能提出实验计划 | 模型、对照、主要读数 |
| 救援与机制 | 未实施 | 只能列为待检验环节 | 特异性和机制证据 |
两项组织关联如何放在一起
第二张图并列显示REG1A在发现与验证队列中的效应及区间。它保留了两项研究各自的信息,没有把它们压成一个未经充分可比性评估的综合效应。两边同向说明这一观察值得继续研究,但共同存在的细胞组成、取材与临床信息限制并未消失。重复的是组织关联,尚不是功能机制。
这一点对写作非常重要。可以准确描述“公共队列二次分析发现并在另一队列中观察到同向变化”,但不能称作自己完成的组织实验,也不能把外部数据作者的样本采集当作本团队的前期工作。研究基础的来源清晰,才能让后续计划真正建立在可核验的信息上。
保留至少三个竞争解释
对于候选升高,我们可以暂时保留三种解释:它可能参与损伤过程,可能是组织对损伤的补偿反应,也可能主要反映某种细胞状态比例变化。当前证据尚不能唯一选择其中一个。把竞争解释写出来,并不会削弱研究兴趣,反而能帮助设计能区分它们的实验。
例如,如果候选是损伤促进因素,适当降低其作用后可能改善预先定义的表型;如果它主要参与补偿,降低它可能使表型更差;如果它只是状态标记,表达干预可能不产生预想功能变化。这里描述的是有条件的实验预期,不是已知事实。干预效率、模型适用性和非特异毒性也需要一起考虑。
一个好的假说应该允许明确的反证
“候选与疾病有关”太宽,几乎任何表达变化都能被解释为有关。更好的假说应明确模型、条件、作用方向和主要表型。例如,在确认模型表达候选之后,提出某种干预是否会改变特定屏障读数,并规定什么结果支持、什么结果削弱该解释。具体分子机制还需要额外证据,不能仅因已有通路富集就直接填进去。
反证不只是得到一个不显著P值。若干预确实改变目标、主要读数测量可靠、实验有足够信息量,却没有观察到假说预期的效应,这才对假说形成更直接的挑战。如果目标根本没有被有效干预,则主要说明实验操作没有达到检验条件。第18篇会将不同结果对应的行动列入设计表。
怎样判断还缺哪一类证据
先问现有结论最容易被哪种替代解释推翻。如果是细胞组成,优先补充定位和数量;如果是临床混杂,优先完善样本资料与设计;如果是候选特异性,优先设计多个独立干预或救援;如果是模型缺乏相关状态,先验证模型是否适用。证据缺口不同,资源投入也应该不同,不能每个项目都机械加同一套实验。
有时候最重要的缺口并不需要昂贵新技术。例如,核实取材位置、确认候选在模型中表达、检查一个关键探针的特异性,都可能改变整个研究判断。生信分析的价值之一,是帮助把这些低成本但影响大的问题提前发现,而不是把所有不确定性留到大规模实验之后。
从证据表走向技术路线
技术路线应当体现问题如何被逐步检验,而不是把软件名称按顺序排成长条。可以把每个步骤写成“输入什么信息,回答什么问题,达到什么条件后继续,失败时如何调整”。这样路线既有主线,也有合理的停止条件。实际执行时,团队能够据此判断下一步,而不只是按预先画好的箭头一路往下走。
本篇的输出是证据台账和竞争解释示意。下一篇以这些缺口为依据安排表达验证、功能干预和救援等任务。整个系列不预设REG1A一定成为最终课题;它只是帮助读者学会将公共数据观察转化为可检验问题的贯穿案例。
代码、数据与继续阅读
下载完整复现包:20篇R脚本、整理输入、起始结果、运行说明与版本记录。包含公共数据教学子集;不包含任何实际实验结果。解压后先阅读README。
承接第16讲:细胞之间可能如何影响彼此?把通讯线索变成可验证的问题。
下一篇第18讲:生信之后做哪些实验?把候选线索拆成逐步验证的任务。
数据与方法来源
数据与方法核查日期:2026年11月16日。本文为教学二次分析;具体适用范围见正文。
需要把方法用到自己的数据中?
如果需要把分析结果整理成可复现材料与后续验证任务,可以准备研究目标、已有结果和实验条件概况,沟通具体交付内容。 联系云生信,说明当前研究任务。


