国自然生信实战20讲 · 第19讲 · 转成可检验的研究设计
系列目录:国自然生信实战20讲(当前第19讲)
- 第01讲:国自然里的生信从哪里开始?把研究方向拆成可分析的问题
- 第02讲:公共数据怎么选?找到与你的研究问题真正匹配的数据集
- 第03讲:下载数据后先做什么?表达矩阵、样本分组和基因编号整理
- 第04讲:为什么有些数据不能直接分析?看懂异常样本与批次效应
- 第05讲:差异表达怎么做才有解释价值?从统计显著到生物学意义
- 第06讲:富集分析结果太多怎么办?从通路列表提炼研究主线
- 第07讲:哪些基因值得继续研究?把表达、功能和文献证据放在一起
- 第08讲:基因升高说明了什么?区分单个基因变化与功能状态变化
- 第09讲:换一批数据还成立吗?手把手做独立队列验证
- 第10讲:差异真的是疾病造成的吗?识别混杂因素与缺失信息
- 第11讲:换个阈值结论就变了?用敏感性分析检查结果稳定性
- 第12讲:两个队列结果不一致怎么办?从差异中发现研究边界
- 第13讲:为什么整体组织的变化还不够?用单细胞定位表达来源
- 第14讲:是细胞变多了,还是细胞内部表达变了?拆解两种解释
- 第15讲:关键细胞发生了什么变化?从细胞类型走向功能状态
- 第16讲:细胞之间可能如何影响彼此?把通讯线索变成可验证的问题
- 第17讲:从一堆图到一个科学假说:整理现有证据与关键缺口
- 第18讲:生信之后做哪些实验?把候选线索拆成逐步验证的任务
- 第19讲:样本量和验证队列怎么规划?用模拟看清研究可行性(本篇)
- 第20讲:把整个项目串起来:形成可复现分析包和完整技术路线
点击目录按篇次顺序学习;文末复现包包含全系列代码与起始数据。
样本量没有脱离问题的标准答案
“每组做几个样本够用”是研究设计中常见的问题。它不能仅靠经验数字回答,因为不同主要终点、效应大小、变异程度和实验结构需要的信息量不同。公共表达队列里的样本量也不能直接照搬到细胞实验或临床验证。本篇用一个明确标注假设的模拟,让读者看到这些因素怎样共同影响检出能力。
本篇所有功效曲线与招募量都是教学计算,不是对溃疡性结肠炎项目的真实样本量建议。我们假设两组独立、结局近似正态、组内标准差相同,并使用双侧检验。真实项目若涉及配对、重复测量、计数、比例、时间结局或多中心结构,需要重新定义模型和参数,不能直接复制这里的数字。
从主要终点和最小重要差异开始
样本量应围绕预先定义的主要终点规划。第18篇如果确定一个屏障相关读数为主要终点,就需要讨论多大的差异具有研究意义,以及该读数在合适模型中的变异。这里的“重要”不等于统计显著,而是与生物学或实际目标相关。只追求能够检出任意微小差异,可能需要大量资源却难以回答有价值的问题。
效应量可以用原始单位表达,也可以除以组内标准差得到标准化效应。标准化形式便于教学比较,但会隐藏原始读数的含义。两个实验都出现0.5的标准化效应,不代表生物学意义相同。正式规划应同时保留原始单位、变异来源和参数依据,而不是只报告一个抽象数字。
先看理论曲线,再看模拟
第一张图展示不同标准化效应假设下,独立样本数与理论功效的关系。功效描述在指定真实效应和模型假设成立时,检验达到预设显著性条件的概率。它不是研究假说为真的概率,也不是未来论文发表概率。曲线只在我们设定的条件下有意义,条件变化,答案也会变化。
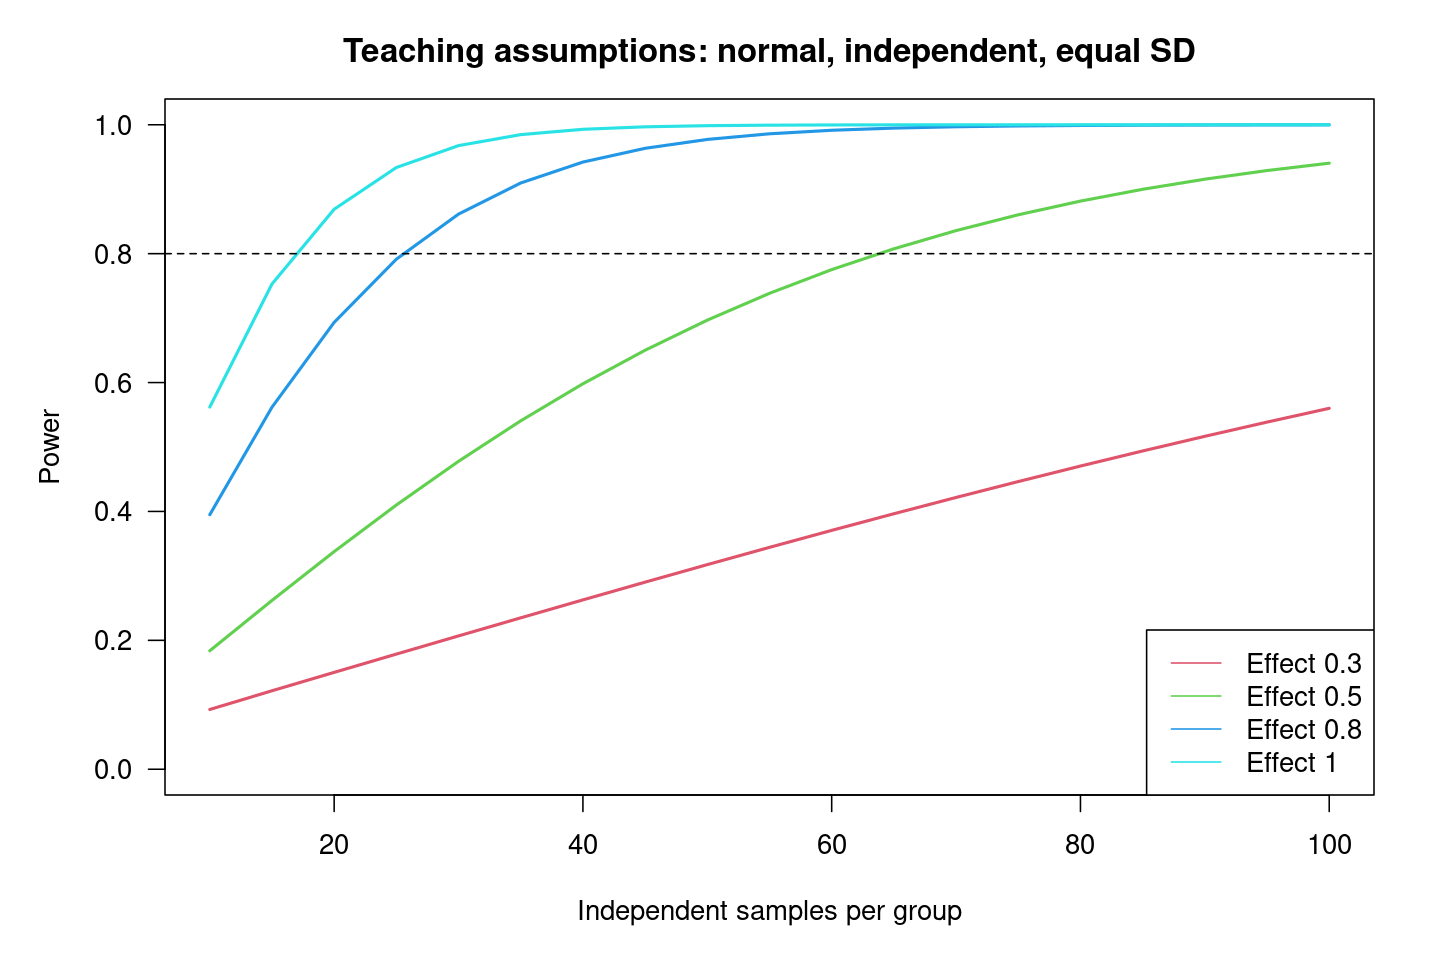
本篇选择0.3、0.5、0.8和1作为教学效应情景,没有把它们当作本案例真实可期待的效果。公共数据中筛选出来的最大变化可能受到选择偏差和人群差异影响,直接用于新实验规划容易过于乐观。较好的方法是结合预实验、可比研究和保守情景,展示一段可能范围,再说明预算和可行性约束。
看清模拟参数与真实项目之间的距离
本篇模拟把标准差设为一,因此输入差异直接等于标准化效应。若自己的实验使用原始单位,必须同时提供差异和标准差,不能把原始差值直接当作标准化效应。单位混淆会让样本量估计相差很大。计算之前,先写清每个参数的测量单位和来源。
当预实验很小时,标准差本身也有较大不确定性。只用一个点估计可能过于乐观,建议比较较大变异和较小效应的保守情景。若不同情景下所需资源差异很大,这正是需要进一步预实验或缩小研究问题的信号。模拟的价值是暴露这种依赖,而不是输出一个看起来精确的整数。
图中的蒙特卡洛误差线描述1000次模拟造成的估计波动,不包含真实效应未知、分布假设错误或选择偏差。增加到更多模拟可以减少计算波动,却不能修复错误假设。对于复杂设计,应优先让模拟结构贴近真实数据层级,再考虑增加计算次数。
若研究有两个主要终点或多个核心比较,应事先讨论错误控制策略。直接为每个比较使用相同阈值,再分别计算功效,可能无法描述整个研究的成功标准。还要明确成功是任意一个终点达到要求,还是所有关键终点都达到要求;这两种目标的规划并不相同。
预算有限时,可以用情景表比较不同方案的信息价值:增加独立样本、改善测量精度、采用合理配对设计或缩小主要问题。并非所有改进都依赖扩大样本量。更稳定的测量和更匹配的对照,有时能减少不必要变异,但任何设计改变都应根据实际条件和科学问题评估。
运行方法与输出检查
下载文末完整复现包后先解压,将R的工作目录切换到其中的workbook目录,再运行下方命令。不要只复制某一行分析语句,因为公共函数、输入文件和前序结果需要保持同一套目录关系。本篇使用代码中明确声明的教学参数进行模拟;附件已包含这些起始文件,因此可以单独学习本篇,也可以按顺序运行全系列。
Rscript scripts/19.R
脚本会把本篇表格和三张图写入results/19目录。运行结束后先检查输出表中的样本标识、列名与正文说明,再打开图片核对坐标和分组。出现报错时保留原始输入,先查工作目录、文件完整性及依赖版本,不要通过改分组或填补不存在的数据来让代码继续。下载包内的版本记录来自实际验证环境,安装时请保持R与Bioconductor依赖相容。
下面提供本篇完整R脚本;它会载入scripts/common.R中的公共函数。共用函数、数据整理代码和逐步日志也包含在复现包中,便于检查每一步的输入与输出。
source("scripts/common.R")
o<-start(19);effects<-c(.3,.5,.8,1);ns<-c(10,20,40,80);grid<-expand.grid(n_per_group=ns,standardized_effect=effects)
# Teaching simulation: independent normal outcomes, equal SD, two-sided Welch test.
B<-1000;grid$power<-mapply(function(n,d)mean(replicate(B,t.test(rnorm(n,d,1),rnorm(n,0,1))$p.value<.05)),grid$n_per_group,grid$standardized_effect)
grid$mc_se<-sqrt(grid$power*(1-grid$power)/B);save_table(grid,paste0(o,"/simulated_power.csv"))
theory<-expand.grid(n_per_group=seq(10,100,5),standardized_effect=effects);theory$power<-mapply(function(n,d)power.t.test(n=n,delta=d,sd=1,sig.level=.05,type="two.sample",alternative="two.sided")$power,theory$n_per_group,theory$standardized_effect)
fig(paste0(o,"/fig1.png"),{plot(NA,xlim=c(10,100),ylim=c(0,1),xlab="Independent samples per group",ylab="Power",main="Teaching assumptions: normal, independent, equal SD");for(i in seq_along(effects)){s<-subset(theory,standardized_effect==effects[i]);lines(s$n_per_group,s$power,col=i+1,lwd=2)};legend("bottomright",paste("Effect",effects),col=2:5,lty=1);abline(h=.8,lty=2)})
fig(paste0(o,"/fig2.png"),{plot(grid$n_per_group,grid$power,col=match(grid$standardized_effect,effects)+1,pch=16,xlab="Independent samples per group",ylab="Simulated power",ylim=c(0,1),main="1000 simulations per scenario");arrows(grid$n_per_group,pmax(0,grid$power-1.96*grid$mc_se),grid$n_per_group,pmin(1,grid$power+1.96*grid$mc_se),angle=90,code=3,length=.03)})
dropout<-c(0,.1,.2,.3);enroll<-ceiling(40/(1-dropout));save_table(data.frame(dropout,needed_per_group=enroll),paste0(o,"/attrition_scenarios.csv"))
fig(paste0(o,"/fig3.png"),barplot(enroll,names.arg=paste0(dropout*100,"%"),col="#199C97",xlab="Assumed loss fraction",ylab="Recruitment per group",main="Teaching target: 40 analyzable independent samples"))
模拟为什么不是每次都一模一样
代码在每个样本数与效应组合下生成1000次独立模拟,使用双侧Welch检验,统计达到阈值的比例。由于模拟本身存在随机误差,这个比例不是精确常数。我们固定随机种子便于重复,并计算蒙特卡洛标准误,图中误差线反映模拟估计自身的不确定性,而不是实际生物实验效应的置信区间。
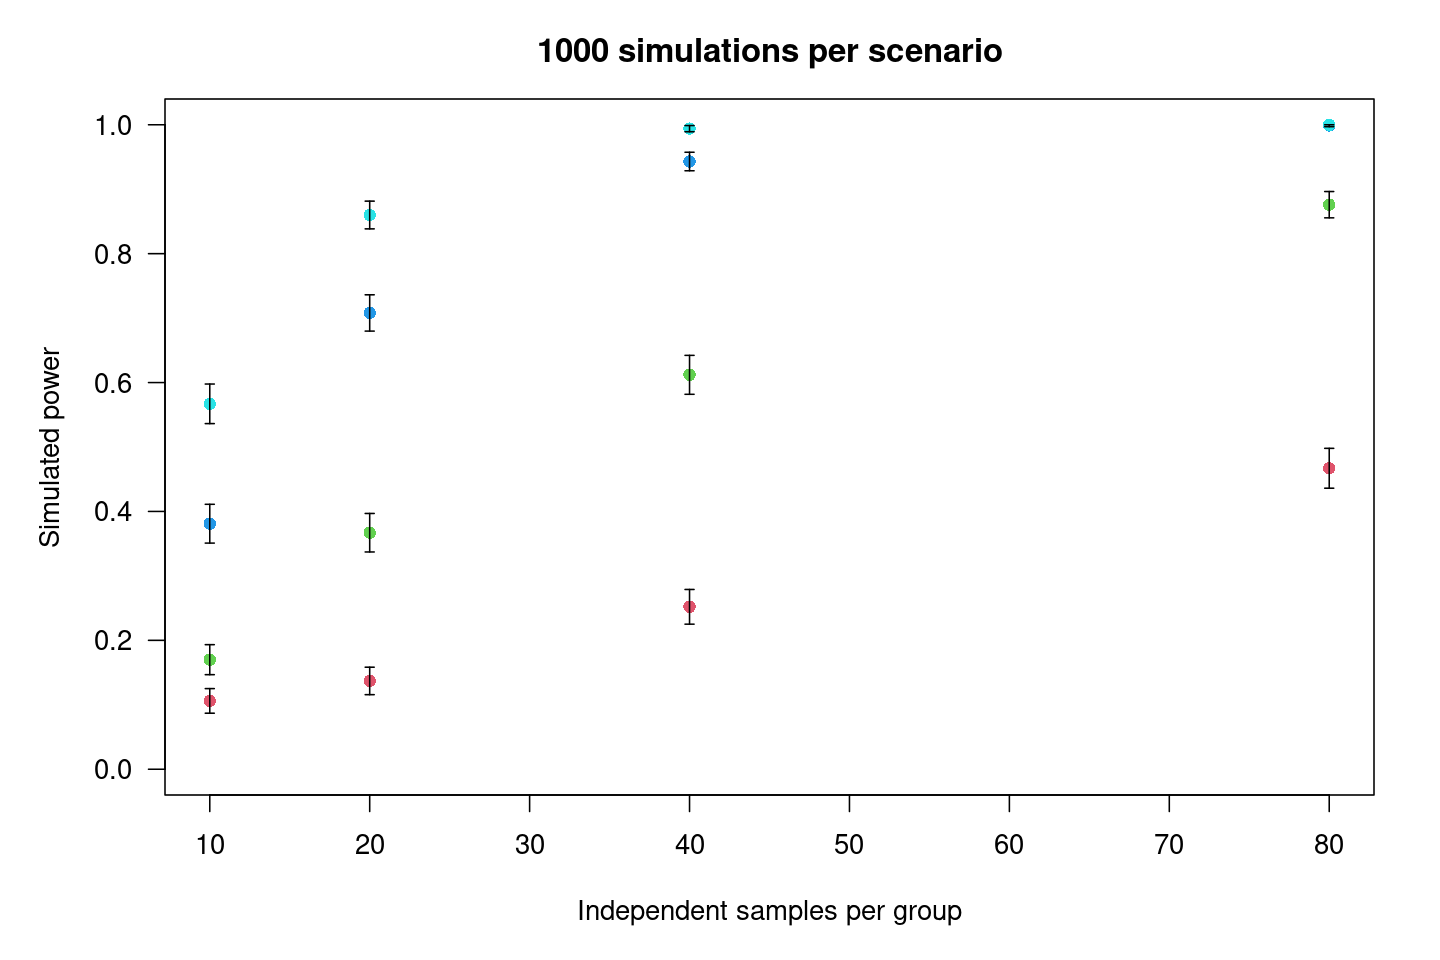
理论曲线与模拟采用的检验细节并非完全相同,有限模拟次数也会产生差异,因此不要求每个点严格落在理论线上。读者应关注总体规律,以及当变异和效应假设改变时资源需求如何变化。若发现结果与常识明显冲突,先检查两组是否真的独立、差异与标准差单位是否一致,再增加模拟次数。
| 规划因素 | 对结果的影响 | 应从哪里获得依据 |
|---|---|---|
| 最小重要差异 | 越小通常越难检出 | 科学问题与实际意义 |
| 组内变异 | 越大通常需要更多信息 | 可比预实验或可靠文献 |
| 独立单位数量 | 决定有效信息量 | 真实实验与采样结构 |
| 失访或质量失败 | 减少最终可分析样本 | 既有流程记录与保守情景 |
| 多个主要比较 | 改变错误控制要求 | 事先确定的研究计划 |
技术重复不能替代独立样本
同一患者的多次测量、同一培养批次的多个孔、同一组织的多个切片,可能帮助降低测量误差,但不能简单相加成独立样本数。若数据存在嵌套或配对,应通过合适模型或模拟保留这种结构。忽略相关性通常会高估信息量,让计划看起来比实际更有把握。
一个实用练习是画出数据层级:最上层是什么独立来源,下面有哪些重复测量,最后有哪些技术读数。然后问功效计算里的n究竟对应哪一层。本篇n表示每组独立单位,不能直接替换成细胞数或孔数。把这一点提前说清,能避免很多实验完成后才发现无法按原计划推断的情况。
质量失败和失访如何纳入情景
第三张图假设希望最终每组获得40个可分析的独立样本,比较不同损失比例下需要预留的数量。计算采用目标数量除以预计保留比例并向上取整,是直观的情景演示。它没有处理失访与结局相关、不同组损失不同或批次相关失败等复杂情况,这些都可能需要更细设计。
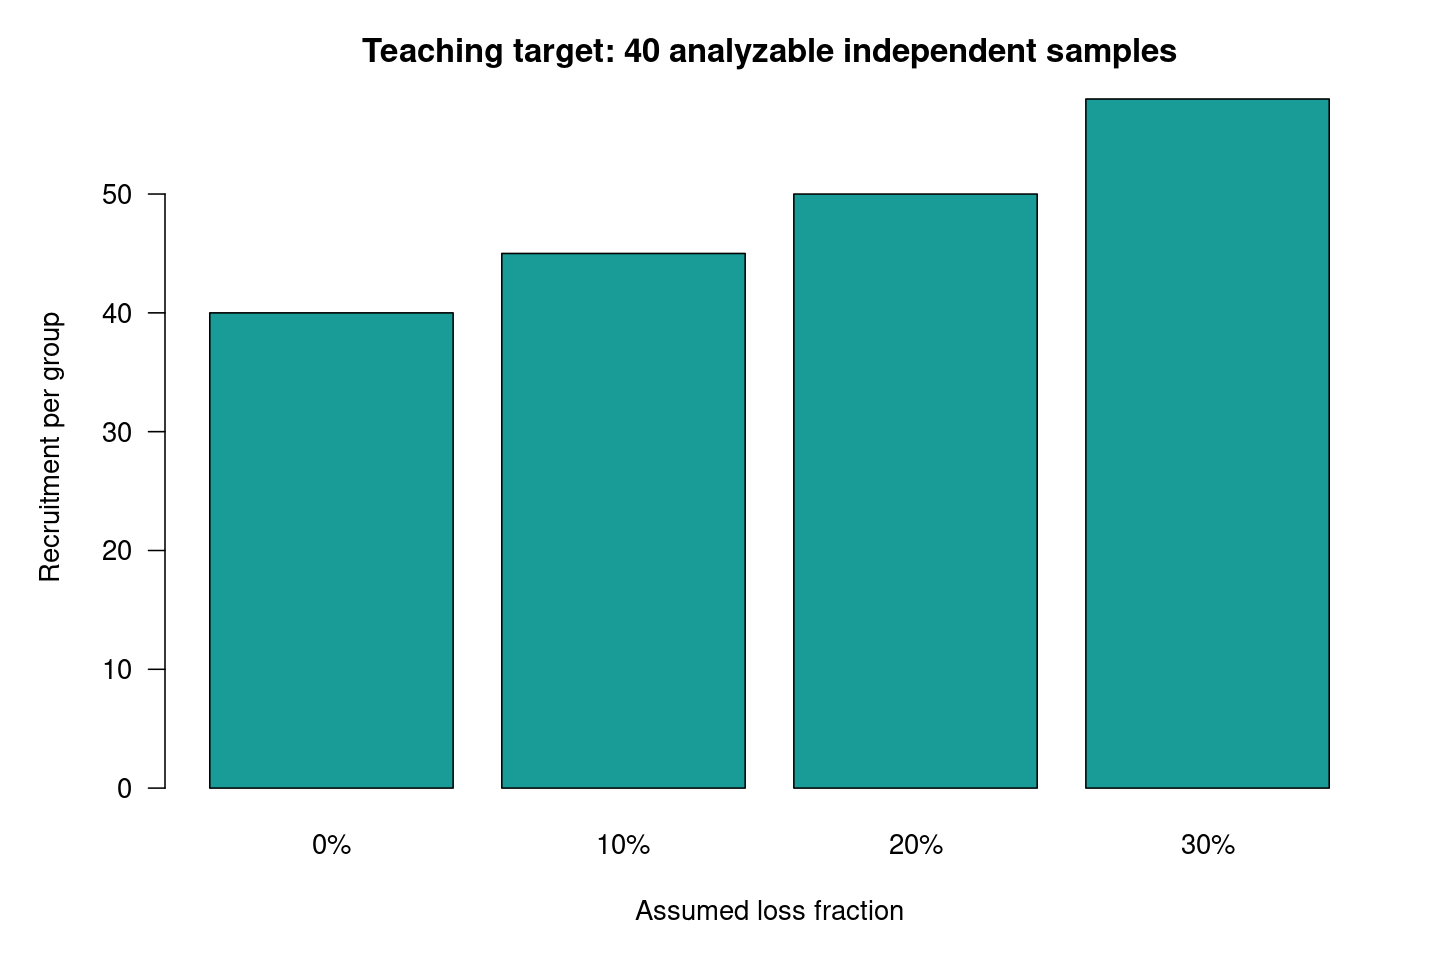
扩大招募量也不能解决所有质量问题。若某一组系统性处理失败,即使总体样本多,也可能形成选择偏差。更好的流程同时关注样本质量标准、失败原因记录、组间处理一致性和缺失机制。样本量规划不是单独的一张计算表,而是与采样和测量流程连接在一起的研究设计。
把规划写成情景,而不是承诺
建议保存保守、中间和较乐观的参数情景,说明每种情景的依据、可实现样本量以及剩余风险。如果资源不足以覆盖所有目标,应调整主要问题或研究阶段,而不是偷偷提高预期效应来让计算结果变小。一个范围清楚的小问题,往往比多个信息不足的大目标更可执行。
本篇输出模拟功效表、参数情景和损失预留表。它们用于理解设计关系,不应直接充当具体项目的统计方案。最后一篇将把数据、代码、图表、版本与证据清单组织成完整复现包,让读者能够从第一步追踪到最终研究判断。
代码、数据与继续阅读
下载完整复现包:20篇R脚本、整理输入、起始结果、运行说明与版本记录。包含公共数据教学子集;不包含任何实际实验结果。解压后先阅读README。
承接第18讲:生信之后做哪些实验?把候选线索拆成逐步验证的任务。
下一篇第20讲:把整个项目串起来:形成可复现分析包和完整技术路线。
数据与方法来源
数据与方法核查日期:2026年11月16日。本文为教学二次分析;具体适用范围见正文。
需要把方法用到自己的数据中?
如果需要把分析结果整理成可复现材料与后续验证任务,可以准备研究目标、已有结果和实验条件概况,沟通具体交付内容。 联系云生信,说明当前研究任务。


