
把一批新样本加进已有的群体结构图,看起来只需要重新运行主成分分析。但重新拟合坐标轴,与把新样本投影到固定坐标轴上,回答的是两个不同问题。前者允许新样本参与定义最大变异方向,后者希望保留参考体系。若两种结果混在一起比较,图上的移动可能来自坐标系改变,而非样本关系改变。
本文实际安装 EIGENSOFT 9.0.0 发行包,运行其中的 smartpca。程序日志记录的内部版本为 18725,我们同时保留发行包摘要与这条版本信息。实验使用原创合成基因型,设计六十个参考样本、二十个目标样本和一千个位点,并另设一组技术缺失对照。所有结果用于检查分析行为,不代表真实人群的祖源结构或方法准确率。
一、先分清三个文件怎样共同描述一份数据
EIGENSTRAT 文本输入由基因型、位点和个体三类文件共同组成。基因型文件按位点写行,行内各个字符对应输入个体的顺序。个体文件保存样本标识、性别标记和群体标签,位点文件则提供变异标识、染色体、遗传位置、物理位置及等位基因信息。单独检查其中一份文件,不能证明整个矩阵对应正确。官方格式说明
本例用零、一、二表示指定等位基因的计数,用九表示缺失。九绝不能作为一个比二更大的连续数值送入普通矩阵运算,否则缺失会被解释成极端基因型。转换格式时,应检查每行的字符数与样本数一致,基因型行数与位点数一致,再检查标识是否唯一、顺序是否被意外改变。
群体标签也不自动成为监督学习答案。是否用某组样本估计坐标轴,取决于具体参数。标签可以用于展示、统计和选择参考群体,但不能因为文件里已经写了某个群体名称,就认为软件在任何模式下都固定使用该群体作为参考。应在日志中核对实际参与拟合的样本数。
基因型的编码方向需要保留到下游。如果从另一种格式转换后改变了等位基因顺序,应该同时记录对应关系。虽然某些整体编码翻转不改变样本间距离,但跨文件合并、载荷解释和投影使用的是成套的坐标与位点定义,不能依赖这种特殊不变性来省略核验。
二、建立一个能区分投影与重拟合的实验
我们让两组参考样本各有三十人,前两百个位点具有不同的生成频率,其余八百个位点的参考频率相同。二十个目标样本在后一部分位点上具有另一种频率模式。这样的设计会让目标样本带来新的主要变化方向,便于观察它们是否影响参考坐标。
同一输入进行了三种主要运行。第一种只使用六十个参考样本,作为基线。第二种输入全部八十个样本,但通过群体清单指定只有两个参考组参与定义坐标轴。第三种不提供该清单,让全部八十个样本共同拟合。另一个投影对照改变目标样本的基因型,保留所有参考样本不变。
安装命令和可重复的输入生成脚本见练习包。固定容器摘要可以避免后续拉取到不同构建。正式运行采用单线程,并关闭自动离群样本剔除,使这次实验中的样本集合保持固定。关闭剔除是实验控制条件,不是对所有研究的默认建议。
docker pull quay.io/biocontainers/eigensoft@sha256:af848e6833c5c1f3a05231930de107fea5bd12ecf3753a16f3c90e4306a43840
python3 198-eigensoft/run.py output-eigensoft

# 下面的参数文件由脚本生成
smartpca -p reference.par
smartpca -p project.par
smartpca -p joint.par
投影参数文件包含下面这些实际使用的设置。输入路径和输出路径各自明确,避免误读上一次运行的文件。群体清单一行一个群体名称,必须与个体文件中的标签完全对应。
genotypename: full.geno
snpname: full.snp
indivname: full.ind
evecoutname: project.evec
evaloutname: project.eval
poplistname: refs.poplist
numoutevec: 3
numoutlieriter: 0
numthreads: 1
hiprecision: YES
lsqproject: YES
shrinkmode: NO
blgsize: 0.001
三、固定参考投影时,参考坐标应保持什么关系
正常投影产生八十行样本坐标,参考基线产生六十行。我们按样本标识取出共同的六十人,再逐个主成分比较。前三个主成分的相关系数都是一,按方向对齐后的最大绝对坐标差都为零。改变目标基因型后,参考坐标仍与基线一致。
与此同时,目标样本本身的位置发生了变化。例如 S61 的前三个投影坐标从 (-0.002813, 0.046809, 0.039547) 变为 (0.004927, -0.050356, -0.043820)。参考轴不动、目标坐标随输入变化,正是这个对照希望核验的关系。完整输出保留在结果文件中,没有把四舍五入后的显示值当作独立证据。
| 运行方式 | 输出样本数 | 参考 PC1 与基线的相关 |
|---|---|---|
| 只拟合参考样本 | 60 | 基线 |
| 全部输入,仅参考组定义坐标 | 80 | 1 |
| 改变目标后仍固定参考组 | 80 | 1 |
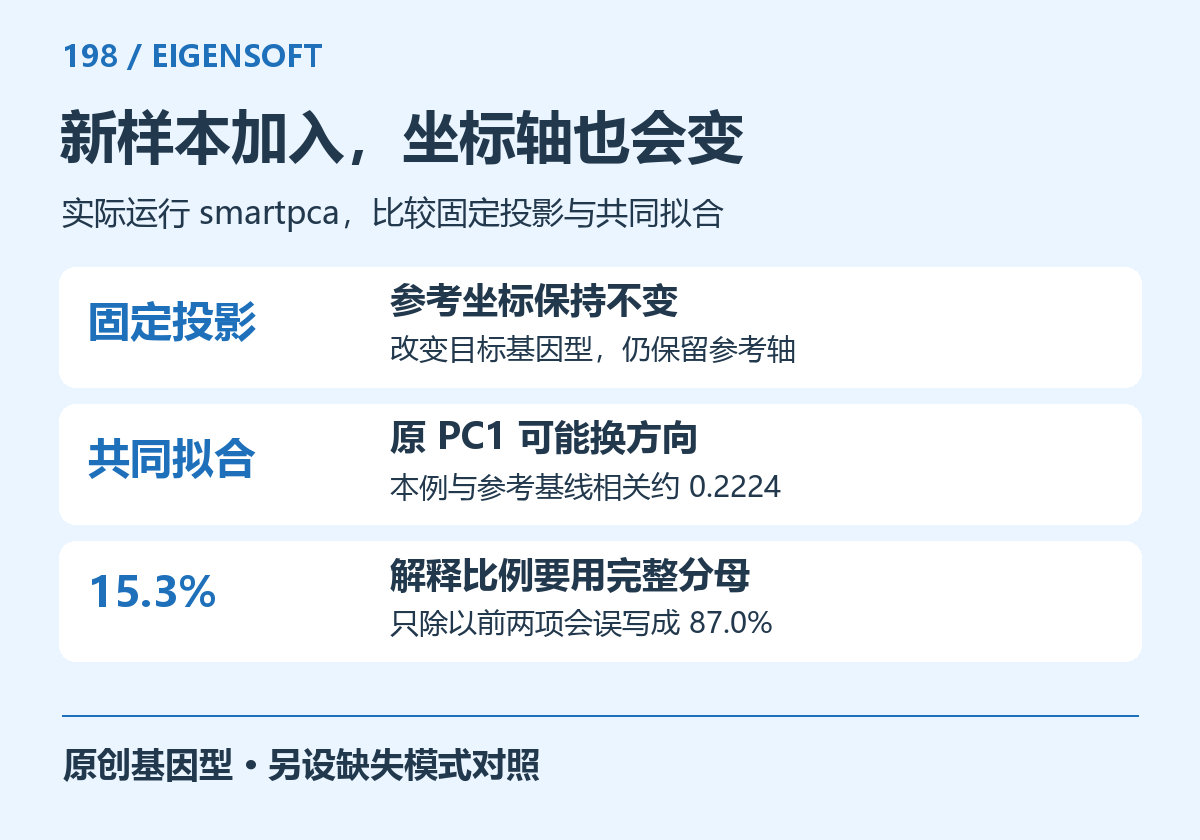
| 全部样本共同重新拟合 | 80 | 约 0.2224 |
这类对照也适合作为实际工作流的检查。如果声称使用固定参考体系,但仅更改待投影样本就导致参考坐标明显改变,应检查是否漏传群体清单、是否改变了共同位点集合,或者是否在合并时重新执行了依赖全体样本的过滤。坐标轴固定依赖完整处理链,而不仅是一项参数。
在真实数据里,新样本的缺失模式与参考可能不同。最小二乘投影是官方提供的相关处理方式,但不意味着投影误差自动消失。缺失覆盖了哪些位点、参考能否代表目标、保留了多少有效信息,仍决定结果可以解释到什么程度。smartpca 参数文档
四、共同重拟合后,原来的 PC1 未必还是那个方向
让全部样本参与拟合后,六十个参考样本的新 PC1 与原 PC1 的相关系数约为零点二二二四。第二、第三主成分也没有保持原来的逐轴对应。数据没有因此损坏,而是新样本参与决定了怎样的方向解释更多变异。共同重拟合与固定投影的区别,在这组设计数据上被清楚地放大了。
因此,不能只拿两张图的横坐标相减,就把差值解释成群体之间遗传距离的变化。不同拟合可能发生轴方向翻转、排序变化,甚至在相近特征值对应的空间内发生旋转。先检查分析集合、中心化与标准化条件是否相同,再决定应该比较单轴、子空间还是样本间关系。
即使只发生整体符号翻转,所有样本的相对结构也可以完全不变。一个特征向量及其相反数描述同一个方向,所以脚本先看相关系数的符号,再计算对齐后的坐标差。把正负号本身当作群体属性,或者根据左右位置给成分作固定命名,都会带来不必要的误读。
PCA 提取的是输入矩阵的主要变化方向,并不会保证每一条方向都对应某个单独的历史事件。原始方法论文讨论了用特征分析研究群体结构的统计基础,但具体图形仍需要与采样、标记和技术信息一起解释。群体结构与特征分析论文
五、15.3% 与 87.0%,只差在用了哪个分母
这次参考基线的第一特征值约为九点零二九四,全部六十个输出特征值之和约为五十九。用第一特征值除以全部特征值之和,得到的解释比例约为百分之十五点三零。若只把前两个特征值相加作为分母,就会得到约百分之八十七点零四。
两个数字都可以通过计算得到,但它们的含义完全不同。后者只描述前两条轴之间的相对分配,不能直接标成第一主成分解释全部变异的比例。图上只画两条轴,不表示其他方向的变异已经不存在。绘图程序若只读取前两行特征值,就很容易在这个步骤出错。
本次只要求输出三列样本主成分坐标,但特征值文件仍保留了完整列表。脚本分别检查两种文件的结构,没有把坐标列数误当成全部特征值数。读者可以用同样方法审阅自己的绘图数据,先确认分母来自哪里,再在坐标轴标题中写百分比。
对于缺失处理、不同标准化或不同标记集合得到的结果,即使百分比计算都正确,也不宜把它们当作完全相同基准下的量。比较之前,应说明哪些输入条件发生改变。一个比例变大可能来自某个方向更突出,也可能来自其他方向的信息减少,需要结合完整特征谱判断。
六、把缺失与非缺失单独做一次 PCA
第二组原创数据没有人为设置两批样本之间的等位基因频率差异,而是让前四十个样本主要在前半段位点缺失,后四十个样本主要在后半段缺失。这样可以把技术覆盖模式与基因型生成模型分开,检查程序是否能够把缺失结构单独揭示出来。
在 missingmode: YES 下,程序分析缺失与非缺失模式。第一主成分与预先设定的批次标签的相关系数绝对值约为零点九九九七五,几乎完全反映这两种覆盖模式。同一份带缺失数据按普通基因型模式运行时,其第一主成分与批次的相关系数绝对值约为零点零四四。
这个结果不意味着任何真实数据的缺失都不会影响普通 PCA,也不表示只要做一次缺失分析就能排除批次问题。它证明的是,本例中存在很强的技术覆盖差异,而专门分析缺失模式能把这种差异显示出来。两种分析对象不同,不能把缺失模式图中的分组直接命名为生物学结构。
实际项目中,可以把主成分与测序批次、平台、缺失率和深度等信息交叉检查。若技术因素与研究分组重合,应先查清设计和处理过程。仅凭图上有两个清晰点云,并不足以确认群体差异,尤其不能通过删除不符合预期的样本来让图形变得更整齐。
七、这次实跑中遇到的两个具体问题
第一个问题出现在输入已经完成 PCA 计算之后。小范围合成数据配合默认遗传分块设置,在后续分块估计阶段出现区块数不足的错误。我们检查日志,确认问题位于附带的统计阶段,再为这一千个位点的构造范围设置更小的分块尺寸,程序最终记录十一个区块并完整退出。
这个调整仅用于让小型流程练习完成。真实研究中的分块尺寸关系到相关性和不确定性估计,不能为了消除报错就任意缩小。也不能看到主成分数值已经打印出来,就忽略最后的失败状态。应同时核对最终退出、输出完整性和每个统计阶段是否满足条件。
第二个问题来自输出读取。特征向量文件首行包含特征值说明,行首还可能有空白。解析时若只判断第一个字符是不是井号,就可能把带前导空格的说明行当成一个样本。我们的检查曾因此发现行数多一行,修正为先去除行首空白,再识别说明行。
这种错误很容易被绘图步骤隐藏,因为多出来的记录可能在转换数值时被自动丢弃。更可靠的办法是在读表后立即比较输出样本集合与预期集合,而不只统计行数。任何额外或缺失的标识,都应在进入作图之前得到解释。
八、将结果交给别人时,保留坐标轴的定义
可复用的 PCA 结果应包含最终样本清单、位点清单、编码说明、参数文件、完整特征值和运行日志。若做投影,还应明确哪些样本定义了参考轴,哪些仅被投影。这样后续加入样本时,才能判断需要延用既有体系,还是有理由重新拟合。
练习包中的脚本会生成全部输入,完成六组实际运行,并核对参考坐标、目标变化、缺失模式和解释比例。它适合用来验证环境和读表程序,不能替代真实数据的亲缘检查、标记质量控制或研究设计。把这些边界写清楚,结果才方便复查和比较。
当固定参考投影、批次核验和多批样本结果管理需要形成稳定流程时,可了解云生信生物信息学分析环境与计算服务。


