
系统发育分析的偏差不一定从建树算法开始。日期怎样处理、序列质量怎样定义、不同地区如何抽样,以及哪些样本被强制保留,都会先改变进入分析的数据集合。最后得到一棵结构清楚的树,也不能说明前面的样本选择已经合理。
本文实际安装 Nextstrain Augur 34.3.0,围绕筛选命令设计十五条人工元数据和十五条人工序列。我们逐项比较质量过滤、日期歧义、分组抽样、优先级和强制纳入,最后得到一个容易漏查的结果,元数据留下六条,序列却只有五条。
先把筛选规则与研究问题连起来
不同地区测序力度不同,直接把所有可下载序列放进同一棵树,可能让某些地区占据大量叶节点。按地区和月份抽样可以改变这种表示方式,但也会改变样本构成,因此必须明确抽样是为了什么。
如果目的是查看各地区主要分支的背景,适当均衡抽样可能便于观察。若目的是估计某类样本在总体中的比例,均衡后的样本数就不能直接作为总体频率。抽样方案应该服务于具体问题,而不是只服务于一张更好看的树。
Augur 提供了把元数据和序列规则组合起来的筛选入口。官方筛选说明列出当前参数。本次实际运行其中一部分,用人工对照检查参数组合后的行为,没有把整个 Nextstrain 分析流程都写成已经完成。
人工数据为什么要故意放入问题记录
正常记录分布在两个地区、两个月份,每个组合有两条序列,共八条。每条正常序列长三百个字符,全部由标准核酸碱基组成,日期明确到日。
我们另外加入日期只知道月份的记录、日期只知道年份的记录、一条短序列、一条含很多未知碱基的序列、一条含非法字符的序列,以及一条早于时间范围的记录。最后再加入只有元数据和只有序列的两个不匹配对象。
元数据总行数和序列总条数都为十五,但两边的名称集合并不完全相同。这个设计提醒我们,总数相等并不保证一一对应。即使两个文件都显示一千条,也可能各自缺少不同的样本。
所有序列都由脚本生成,地区名称是教学标签,日期也不对应真实采样。它们只用于观察软件规则,不用于研究地理传播、群体比例或生物学差异。
固定版本并检查真正使用的依赖
我们在 Linux 中使用固定镜像摘要运行命令,完整记录版本、输入、参数和日志。容器限制为两个逻辑处理器和四吉字节内存,这只是隔离环境的设置,不是为实际项目推荐的资源配置。
当前版本处理 FASTA 还依赖序列处理程序,因此安装主命令后仍应跑一个小输入确认整个链路可用。仅看到版本号,并不能证明读取序列、筛选和写出文件所需的组件全部正常。
首次试运行时,我们尝试在普通固定分组抽样中直接输出分组目标大小,程序报错,指出该输出参数只适用于带分组权重的用法。最终脚本改为从实际输出元数据重新计数,没有把自己计算的组大小伪装成原生命令文件。
这个经验很具体。帮助页上的参数名称不一定完整表达所有组合限制。遇到冲突应保存完整命令和错误信息,再检查所用版本,不能为了让任务返回成功而随意删掉影响抽样含义的设置。
质量筛选中的长度,究竟在数什么
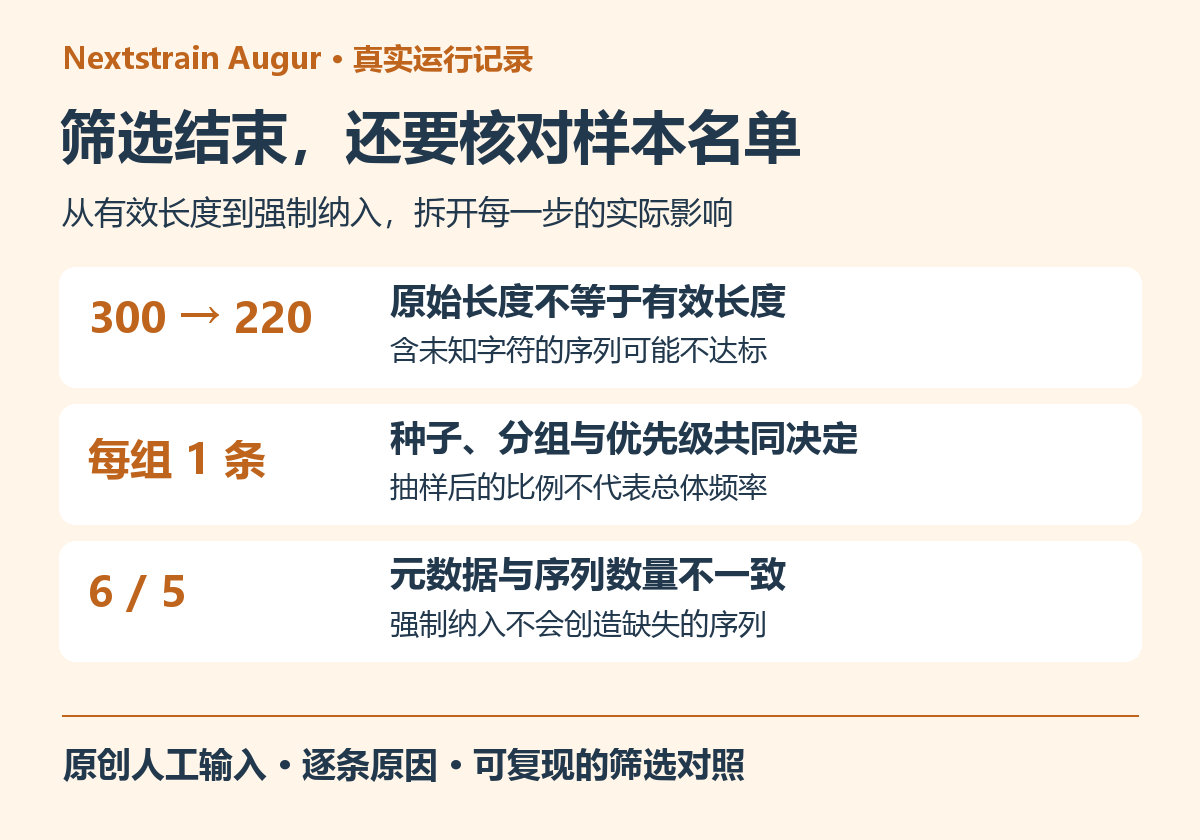
本例设置最低有效长度为二百五十,并排除非法字符。那条含未知碱基的序列原始长度为三百,其中只有二百二十个标准核酸碱基,其余八十个为未知字符。它最终因长度条件被排除。
另一条序列含二百九十九个标准碱基和一个非法字符。它拥有足够的标准碱基数量,但仍然被非法字符规则排除。两个失败原因不同,不能统一写成“长度不够”。
| 人工记录 | 原始字符数 | 标准碱基数 | 本次处理 |
|---|---|---|---|
| 正常序列 | 300 | 300 | 可进入后续筛选 |
| 多个未知字符 | 300 | 220 | 有效长度不足 |
| 含非法字符 | 300 | 299 | 字符规则排除 |
| 短序列 | 100 | 100 | 有效长度不足 |
本例中的有效长度可以直接用标准碱基数量核对,因为数据设计非常简单。真实输入还可能包含缺口、其他歧义字符或不同类型的序列,不能把这里的核酸规则未经检查地套用到蛋白质数据。
做质量汇总时,建议把原始长度、有效长度、未知比例和非法字符数量分开保存。只保留一个长度字段,会让后续复查无法解释为什么一条看似完整的序列没有通过筛选。
日期不完整,是否一定要删除
先采用最严格的日期歧义设置,要求日期各部分都明确。再限制时间范围为二〇二四年的一月至二月,并应用前面的序列质量规则,最终保留八条正常记录。
augur filter \
  --metadata metadata.tsv --sequences sequences.fa \
  --min-length 250 --exclude-invalid \
  --min-date 2024-01-01 --max-date 2024-02-29 \
  --exclude-ambiguous-dates-by any \
  --output-sequences quality_any.fa \
  --output-metadata quality_any.tsv \
  --output-strains quality_any.txt \
  --output-log quality_any.reasons.tsv
日期只知道月份的那条记录在这里被明确排除。但如果研究只按月份分组,缺少具体哪一天未必妨碍分组。下一组实验不采用这个全面删除日期歧义的参数,而是直接检查按月份分组时的行为。
结果中,只知道月份的记录能够进入相应月份的候选集合,随后因为抽样名额限制没有被选中。只知道年份的记录则因月份不明确而跳过。两者最终都没有出现在输出,但原因完全不同。
如果只根据最终名单反推“所有日期不完整的记录都被质量过滤”,就会得到错误描述。应查看逐条原因,区分没有资格参与和参与后未抽中。这种区别还会影响以后更换随机种子时对名单变化的预期。
不要为了让软件接受日期而自行补上月初或年初。填入一个具体日期会增加原始记录没有提供的时间精度,应保留不确定性,并根据分析需要选择处理方式。
四个组各留一条,不等于随机取四条
接着按地区、年份和月份分组,每组最多保留一条,随机种子设为二百一十八。实际命令如下。
augur filter \
  --metadata metadata.tsv --sequences sequences.fa \
  --min-length 250 --exclude-invalid \
  --min-date 2024-01-01 --max-date 2024-02-29 \
  --group-by region year month \
  --sequences-per-group 1 --subsample-seed 218 \
  --output-sequences grouped.fa \
  --output-metadata grouped.tsv \
  --output-strains grouped.txt \
  --output-log grouped.reasons.tsv
最终四个组合各有一条,因此总数为四。但这个总数依赖实际存在的分组。如果某个月份没有合格记录,该组合不会凭空产生一个样本,也不能因为设置每组一条就保证所有地区的覆盖完整。
抽样前应先查看合格候选分布,再查看抽样后分布。本例原来各组正常记录数量相等,现实数据往往并非如此。一个地区从几千条中留下十条,另一个地区原本只有十条,输出数量虽然相同,信息背景并不相同。
年份和月份由日期字段参与确定。若另有手工标注的月份分类,应确认自己要用的是日期含义还是业务标签,避免同名字段让分析者误以为使用了手工分组规则。
相同随机种子,先比较集合再比较文本
我们对完全相同的输入重复执行相同分组命令,两次选中的样本集合一致。最终结果记录保留了每一条名称,读者不需要依赖一句“可重复”来判断。
在前一次排查中,单独输出的样本名单出现了行序不同,但集合一致的情况。最初按文本行列表直接断言相等会误报失败,随后把验证改为集合比较,并另外记录行序是否相同。
这不是说任何顺序差异都可以忽略。元数据和序列若被某个下游程序按行号强行对应,就仍然可能产生错误。稳妥的方法是使用唯一名称关联,同时检查重复名称,而不是假设两个文件的第十行永远属于同一个样本。
固定随机种子也只约束相应输入和运行条件。增加候选记录、改变排序、修改分组规则或升级软件后,都应重新核对名单,不应把种子看成独立于数据的永久抽样编号。
优先级改变的是组内选择
我们为每个正常分组的第二条记录赋予较高分数,其余记录赋予较低分数,再保留相同的每组一条规则。结果四个分组都选中较高优先级的记录,组大小仍然是一。
# 在相同的分组命令中增加
--priority priority.tsv
这说明优先级可以明确改变组内保留对象,但它本身不是测序质量,也不是生物学重要性的自动度量。分数从哪里来、如何处理并列、是否偏向某个实验批次,都应在分析方案中解释。
如果用覆盖度作为优先级,可能系统性偏向某类保存条件更好的样本。如果用采样日期较新作为优先级,可能压缩同组内较早时期的信息。选择没有天然中立的分数,需要判断这种偏向是否符合研究目的。
因此,建议在交付时同时保留原始优先级表和最终组内名单。只留下一条命令,无法让后续人员知道为什么某个样本始终被选中。
强制纳入可以越过你刚设置的门槛
最后,我们在分组命令中额外指定一个强制保留名单,名单包含短序列和只有元数据的记录。
# 在相同的分组命令中增加
--include include.txt
输出元数据有六条,样本名单也有六条,但 FASTA 只有五条。短序列被重新纳入,尽管它没有达到有效长度门槛。只有元数据的记录同样回到名单,但程序无法为它创造不存在的序列。
对应地区和月份的元数据数量达到三条,其中一条来自正常抽样,两条来自强制纳入。这表明每组一条并不是覆盖所有最终输出的绝对上限,强制名单可以改变最终组大小。
这个功能适合保留有明确理由的重点样本,但也可能让常规质量保证失效。使用时应单独列出例外样本及原因,并核对它们将进入哪些下游步骤。重点样本没有序列时,可以保留元数据记录,却不能直接假定它已经具备建树输入。
检查名单差集,比核对总数更可靠
下面的简单核对可以用于本次输出。它读取元数据名称和 FASTA 标题,分别检查两边缺少什么。
import csv

with open("forced.tsv") as handle:
    metadata_ids = {
        row["strain"]
        for row in csv.DictReader(handle, delimiter="\t")
    }

with open("forced.fa") as handle:
    sequence_ids = {
        line[1:].split()[0]
        for line in handle
        if line.startswith(">")
    }

print("metadata_without_sequence",
      sorted(metadata_ids - sequence_ids))
print("sequence_without_metadata",
      sorted(sequence_ids - metadata_ids))
本例前一个差集包含那条只有元数据的记录,后一个差集为空。这个结果比“两个文件差一条”更有用,因为它直接给出需要核实的名称。
真实数据还应先检查名称是否唯一。集合会合并重复值,因此集合一致不能排除重复记录。可以同时比较原始条数、唯一名称数和两边差集,三个检查分别回答重复、数量和匹配问题。
原因日志不是一张简单的失败名单
强制纳入实验的日志中,同一个样本既有早期过滤原因,又有后续强制保留记录。例如短序列先因长度不足被排除,再因为名单要求回到最终结果。
因此,不能把原因日志中出现过的所有名称都汇总成“最终删除样本”。它记录了筛选过程,最终状态还需要与输出名单对照。忽略这一点会导致报告中的剔除数量与实际建树样本数量对不上。
比较两套规则时,最好同时保存最终差集和过程原因。这样才能区分质量门槛变化、分组名额变化和人工例外变化,也更容易定位某个重点样本为什么没有出现在结果中。
优点、限制与可复用的经验
Augur 筛选的优势是能把多个规则放进统一命令,并输出序列、元数据、名单和原因记录。我们能够通过小对照直接定位长度、日期、抽样和强制纳入的作用,而不用从最终树倒推前处理过程。
它的限制是不会自动替研究者决定合理的样本设计。均衡抽样不能自动消除采样偏差,优先级不能自动代表质量,强制纳入也不会自动补齐序列。参数组合运行成功,仍然需要研究问题和数据来源的支持。
对于反复筛选同一份较大序列文件,官方索引说明提供了预先统计序列组成的方式。索引应与实际序列文件一致,文件更新后不能继续沿用旧统计并期待结果可靠。
下载脚本并复查自己的规则
下载本组三篇复现包,在新的工作目录运行下面的入口。脚本会生成全部人工输入,执行五组筛选并保存原始日志、最终名单和组大小统计。
python3 218-augur/run.py /tmp/augur-demo
把自己的研究规则代入前,可以先明确需要保留哪些时间精度、如何定义质量、是否允许例外,以及最终各类文件是否必须完全对应。将这些要求写成可检查的名单和计数,往往比继续增加筛选参数更有帮助。
当筛选方案需要在多批数据间持续复用,并与后续比对和建树衔接时,可通过云生信生物信息学分析服务器保存统一环境与完整流程记录。


