
同一个扫描编号在结果表里出现两行,能否说这张谱里同时有两条肽?仅凭行数不能得出这个结论。搜索引擎可以把同一份碎片信号交给多个候选评分,两个序列也可能共享部分理论碎片。排名第二说明还有一个候选值得查看,并不自动等于识别出了第二个共同碎裂的分子。
Sage 提供混合谱搜索选项,能在第一轮匹配后去掉已分配的峰,再寻找剩余信号的解释。本文实际安装并运行官方可执行文件,构造单肽与混合谱对照,比较“多报告一名”和“扣峰后再搜索”。重点是学习如何解释结果,以及如何发现统计模型在小例子里没有正常建立。
先把候选竞争与混合谱分开
设想两条不同序列拥有相同的氨基酸组成。它们的前体质量一样,但序列内部的排列不同,会产生一部分不同的碎片。在只有第一条肽的谱里,第二条仍可能凭借共享碎片获得一定分数。如果允许输出前两名,这两条就可能同时写进结果表,即使输入根本没有第二条肽。
混合谱的情况则是前体隔离与碎裂过程中存在多个贡献者,观测峰同时来自不同序列。排查它需要寻找第一名无法解释、却能被另一条肽连续而有规律地解释的信号。这个判断不仅与候选得分有关,还与隔离窗口、候选前体是否可能共同进入、碎片误差和剩余峰的结构有关。
Sage 的混合搜索会在匹配后扣除相应峰,再对余下信号搜索。启用开关的同时,还需要允许报告不止一个匹配。本篇对这两个设置分别控制,避免将“开关已打开”误认为结果一定已经发生了额外搜索。混合搜索与输出数量说明
安装记录要同时保留下载标签和程序自报版本
我们从官方 v0.14.7 发布页下载 Linux x86_64 musl 文件。在本次下载中,程序的版本命令实际报告 0.14.6。两者都被写入实跑记录。复现时应同时核对下载资产和可执行文件校验值,不能只根据压缩包名称推定程序内部版本。
curl -L --fail \
  https://github.com/lazear/sage/releases/download/v0.14.7/sage-v0.14.7-x86_64-unknown-linux-musl.tar.gz \
  -o sage.tar.gz
tar -xzf sage.tar.gz
find . -type f -name sage
/path/to/sage --version
sha256sum /path/to/sage
本次可执行文件 SHA256 为 19e71e219e9ee0a94af36dd7acb83bfcad3bb06b5ed8f8b7eb30e7fd989f69ec。执行环境为 Ubuntu 22.04、Python 3.10.12。通过线程环境变量限制为两个线程,并关闭运行遥测。这里关注结果解释,不报告与其他软件的速度比较。官方发布文件 · 配置与环境变量
Sage 的配置以文件形式保存,适合批量运行和记录实验条件。它也包含重评分与错误发现率相关处理,因此不能把“生成了结果表”当作每个统计步骤都已经成功。下面的小实验恰好出现了这一点,日志中的提示比退出状态更能说明结果的适用范围。
构造三组有真值的谱
实验使用两条自编序列,分别记为甲和乙。二者氨基酸组成相同、顺序不同,前体质量一致。这样就把“质量不在搜索窗口里”这个因素排除,让比较集中在碎片层面。数据库另加三百条随机背景序列,并生成诱饵,所有组都使用相同数据库。
输入共有三十张谱。前十张只有甲,中间十张只有乙,最后十张为甲乙混合。混合时乙的理论峰按甲的约六成强度生成,共享质荷比位置的强度相加,再加入固定随机种子的低强度杂峰。所有谱的真实组成都写在结果文件中,便于逐个扫描核对,而不是仅比较输出总数。
这些谱使用理想化的单电荷碎片,没有真实仪器的全部误差和强度结构。它们适合展示共享峰怎样产生竞争候选,却不能测试实际样本中的混合谱检出率。数据库也只有两条真正用于生成信号的序列,三十张谱不是三十个独立生物学样本。
本实验关闭保留时间预测与定量,因为生成的时间只是记录顺序,没有实验洗脱信息。前体与碎片窗口固定为正负十个 ppm,最少匹配峰数设为五,所有组都保持不变。这个较小的门槛是为了让共享碎片候选可见,不能直接当成复杂真实数据的推荐阈值。碎片预处理设置
四组搜索得到的差别
| 搜索方式 | 只含甲的十张谱 | 只含乙的十张谱 | 混合的十张谱 |
|---|---|---|---|
| 普通搜索,只报第一名 | 10 行 | 10 行 | 10 行 |
| 开混合搜索,只报第一名 | 10 行 | 10 行 | 10 行 |
| 普通搜索,报告前两名 | 20 行 | 20 行 | 20 行 |
| 混合搜索,最多报告两名 | 10 行 | 10 行 | 20 行 |
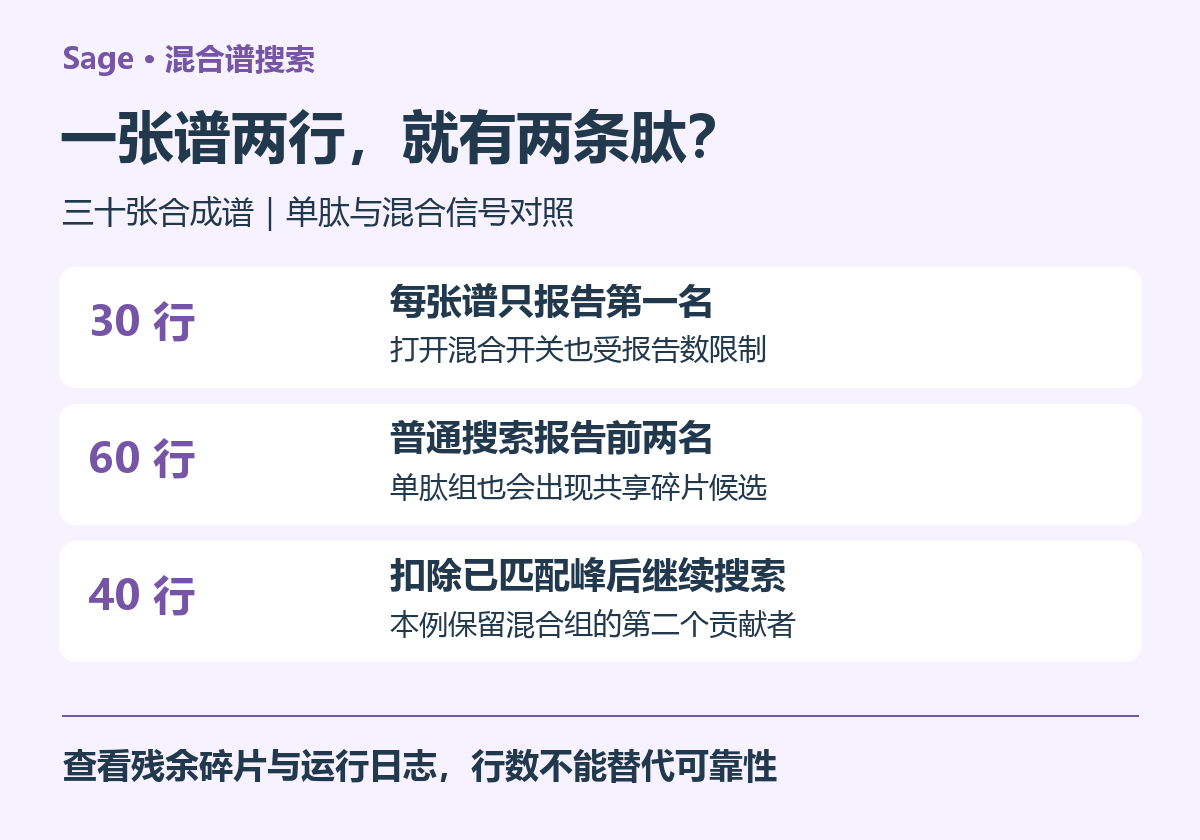
普通搜索只报第一名时,每张谱得到一行,混合谱的第二个贡献者不会出现在表里。只打开混合开关、仍限制报告一名,结果保持三十行。这个对照验证了一个实际配置问题,若报告数量没有一起调整,开关本身不足以让读者看到第二个匹配。
普通搜索报告前两名后,总数增加到六十行。但两个单肽组也各自多出了十个候选。这些新增行不代表输入多了一条肽,只说明第二条序列利用共享碎片进入了候选列表。若直接把六十行当作六十次独立鉴定,就已经改变了结果的含义。
使用扣峰后的混合搜索,结果为四十行。两组单肽谱各保留十行,混合组保留二十行,并且每个扫描报告的序列集合与本例生成真值一致。这是此次受控实验的结果,不应外推成混合搜索总能剔除错误第二名,或者四十行就全部达到发表所需的鉴定标准。
打开同一张谱,第二名究竟用到了什么
以第一张只含甲的谱为例。普通前两名搜索中,甲匹配十二个理论碎片,乙也匹配到六个。乙的匹配强度比例约为百分之四十九点五,但输入真值明确没有乙。这六个命中来自两条序列之间共享的碎片。因此,命中峰数、强度解释比例和序列真实性不能脱离谱图结构单独解读。
再看第二十一张谱,它确实包含甲和乙。普通搜索里,乙匹配十二个碎片,匹配强度比例约为百分之六十八。混合搜索扣除甲已匹配的峰后,乙只剩六个匹配碎片,但对应比例反而升到约百分之九十二。乍看像是证据减少、解释力却提高,实际原因是分母已经改变。
核对本版实现可以看到,扣峰之后会重新计算剩余峰的总强度,后续匹配的比例使用这个更新后的总量。因此第二轮的百分之九十二指向残余谱,不能和第一轮对完整处理后谱的比例直接相加。将两个百分比相加后说“解释了超过百分之百的信号”,属于混用了分母。本版评分与扣峰实现
另一个版本细节是,本次实现中 ms2_intensity 写入的是该匹配所对应的碎片强度和。第二十一张谱在不同候选下这个字段不同,不能把它一概当成整张原谱固定不变的总离子流。遇到列名、在线说明与实际数值不一致时,应结合当前版本实现和同一扫描的输出复核,而不能靠列名猜测。
为什么不能根据结果行数挑选最佳设置
本例三种输出规模分别为三十、六十和四十行。最多的一组含有我们明知不存在的单肽组第二名,最少的一组又不会报告混合谱的第二个贡献者。因此,用“哪组行数最多”来选择搜索条件,既没有控制候选重复,也没有检验额外结果是否有独立碎片支持。
在实际项目中,可以把变化拆成三个问题。哪些扫描增加了第二名,第二名能解释哪些第一名未解释的峰,以及新增匹配经过同样的质量控制后还剩多少。对于不同条件共同存在的匹配,也要核对它们的排序、质量误差和打分是否发生系统变化,而不只看新增列表。
共享碎片越多,扣峰就越可能同时移走第二条肽本来拥有的信号。本例中的乙从十二个匹配减少到六个,正好把这个代价展示出来。如果第二条肽太弱或剩余独有碎片不足,扣峰后的搜索也可能找不到它。没有第二名输出,不等于样本中绝对不存在第二个贡献者。
日志提示模型失败时,结果还能用来做什么
四组运行都正常退出并产生结果表,但日志明确提示线性模型拟合失败,随后采用启发式判别分数。本文保留了这条提示,没有把运行成功包装成统计模型训练成功。输入过于简单且候选分布特殊,不适合据此建立真实蛋白质组的重评分与错误率结论。
输出中的谱图层级数值也说明行数不能替代可靠性。普通前两名组的谱图 q 值约为零点零一六七,混合前两名组约为零点零二五,其他两个组约为零点零三三三。肽段与蛋白层级 q 值均为一。这些是当前小实验实际输出的字段值,不是我们对真实错误率的估计,也没有任何一行达到百分之一的谱图 q 值筛选条件。
读真实数据时,应分别理解目标与诱饵标记、候选排名、谱图层级与肽段层级结果。筛选某一层级的阈值,只回答那一层级的问题。得到一个候选序列、认为这张谱的匹配可信、再将证据汇总到蛋白,是连续但不同的判断。结果表字段说明
把筛选规则应用到我们已知真值的合成谱,也不意味着软件失效。统计方法依赖输入分布和足够的证据范围,这个小实验有意牺牲了现实复杂度来隔离搜索机制。它适合检验参数是否真正改变了行为,不能承担对总体错误率进行校准的任务。
自己复跑时重点比较哪些文件
下载本篇合成谱实验与预期输出,解压后进入工具目录运行以下命令。脚本会生成三组谱、数据库和四份完整配置,保存日志及原始结果表,并检查输出行数以及混合搜索后的序列集合。它不会调用在线分析服务,也没有使用私人样本。
RAYON_NUM_THREADS=2 \
python3 run.py sage_practice /absolute/path/to/sage
比较结果时,优先按文件名、扫描编号和候选序列匹配,不能依赖结果表行顺序或匹配编号。多线程执行可能改变输出排列,而同一张谱的证据仍然相同。预期结果文件保留了原始数值,脚本中的断言核对有解释意义的集合与数量,不要求日志时间完全一致。
还要把候选排名与文件中的行位置分开检查。后续判别分数和表格排序可能让某个第二名出现在文件前面,不能用每个扫描遇到的第一行替代其排名字段。若要统计混合匹配,应明确保留哪些排名以及怎样处理同一扫描的多行,并同时报告独立扫描数。这样才能避免一项设置改动让表格行数增加,却被误写成检测到更多独立质谱观测。
Sage 的优势在于配置集中,并把搜索及后续处理放入相连的工作流,适合需要批量审阅匹配结果的研究者。相应的使用成本是要识别每个阶段的输出边界,尤其不要把候选表、重评分成功和最终鉴定混成一个状态。本文提供的单肽对照、混合对照和日志检查,可以作为正式分析前的小型行为验证。
当这类验证需要扩展到多批质谱文件,并由课题组共同维护软件版本、数据库及结果记录时,可带上文件规模和流程说明了解云生信的生物信息分析服务器。


