
搜库结束后,一张结果表有九千多条目标匹配,日志却只报告一千多条高置信匹配。同事用百分之一的 q 值筛完,另一位又按百分之一的后验错误概率筛选,两人交出的数量仍然不同。遇到这种情况,先不要判断哪个脚本算错了。需要先问清每一行表示什么、阈值作用在哪一列,以及结果是在训练、后处理还是最终输出阶段统计的。
本文实际安装 Percolator,使用官方仓库提供的固定测试输入,分别执行默认后处理与显式目标诱饵竞争,再检查删除全部诱饵会怎样。重点是学会审阅重评分输出。这里没有重新搜索原始质谱,也没有把官方测试文件当作一个新队列来验证生物学结论。
Percolator 接收的是候选匹配及其特征
一条肽谱匹配通常写作 PSM,表示某张谱与某个候选肽段之间的一次匹配。原始搜索可以为它提供搜索得分、第一名与其他候选的分差、质量偏差、肽长或酶切相关特征。Percolator 利用这些信息学习新的排序方式,再估计结果的错误率。它不能凭空补回根本没有进入候选集合的正确肽段,因此搜库参数和参考数据库仍然影响后续分析能回答什么问题。
方法采用半监督学习。诱饵匹配提供负例,目标匹配中的一部分高分候选被用于建立正例集合,再迭代调整分类器。这里“来自目标数据库”不等于“已经证明正确”,也不能把全部目标行当作人工核验的真阳性。理解这一点,才能看懂软件为什么既需要目标行,也需要诱饵行。Percolator 原始方法论文
输入中的标签列用于说明目标与诱饵来源,不能再次复制成普通预测特征。若特征直接泄露了标签,模型可能轻易分开两类,却没有学到谱图证据与肽段正确性之间的关系。同样,不能先把所有低分候选删光,再期待重评分结果仍代表最初完整的搜索集合。应保存上游转换脚本,让每个特征的计算方式可查。
先核对输入,避免把方向设置当成一条谱
本次使用官方仓库 rel-3-09 标签下的测试 PIN 文件,并固定下载文件的 SHA-256。除表头外,它包含一行默认评分方向和一万九千六百七十四条实际候选记录。其中目标记录九千八百五十二条,诱饵记录九千八百二十二条,扫描编号共有三千六百四十种。一个扫描可以对应多个候选或前体条件,因此候选行数明显多于扫描数。
文件中的 DefaultDirection 行给出初始评分方向,不是一条额外的质谱。若把它算入数据行,会得到多一条的错误计数,若把整张表未经检查直接转成数值矩阵,里面的横线和缺失字段也可能造成类型转换失败。读表时应先识别表头、可选方向行与真正的候选记录。
PIN 的标签用一表示目标、负一表示诱饵。扫描编号、肽段与蛋白标识也有明确位置。蛋白标识部分可能包含多个条目,不能把所有行都强行解释成固定数量的普通数值特征。实际接收转换后的文件时,建议先核对几条原始搜索记录,再确认对应的标签、扫描、肽序列和特征值是否保持一致。官方 PIN 接口说明
安装经验|先确认能加载,再讨论分析参数
实跑环境为 Ubuntu 22.04。我们先解包了官方发布的 Linux 二进制包,但启动时提示缺少指定版本的 Boost 文件系统库。这说明程序还没有进入分析阶段,修改错误率阈值或输入肽段解决不了问题。随后通过独立的 Conda 环境安装软件及配套依赖,才正常运行。
包管理器中的版本写作三点九,程序实际报告版本为三点零九点零。本文保留了包清单、二进制校验值和运行日志,避免只凭下载文件名判断实际使用的程序。下面的安装与调用方式适用于本篇测试环境,正式项目也应记录最终解析出的依赖组合。
micromamba create -y -p ./percolator_env \
  --override-channels -c conda-forge -c bioconda percolator=3.9

./percolator_env/bin/percolator \
  --seed 37 --num-threads 2 --no-analytics \
  --results-psms target.psms.tsv \
  --decoy-results-psms decoy.psms.tsv \
  --results-peptides target.peptides.tsv \
  --decoy-results-peptides decoy.peptides.tsv \
  --weights weights.tsv input.pin
这次固定随机种子三十七,使用两个训练线程,未启用蛋白推断。输出中同时保存目标与诱饵的 PSM 表、肽段表和模型权重。对照运行只增加目标诱饵竞争开关,其余输入和主要设置保持一致。比较两次结果时,保留同一份输入文件比手工复制若干列更可靠。
输出文件生成了,不代表每一行都通过阈值
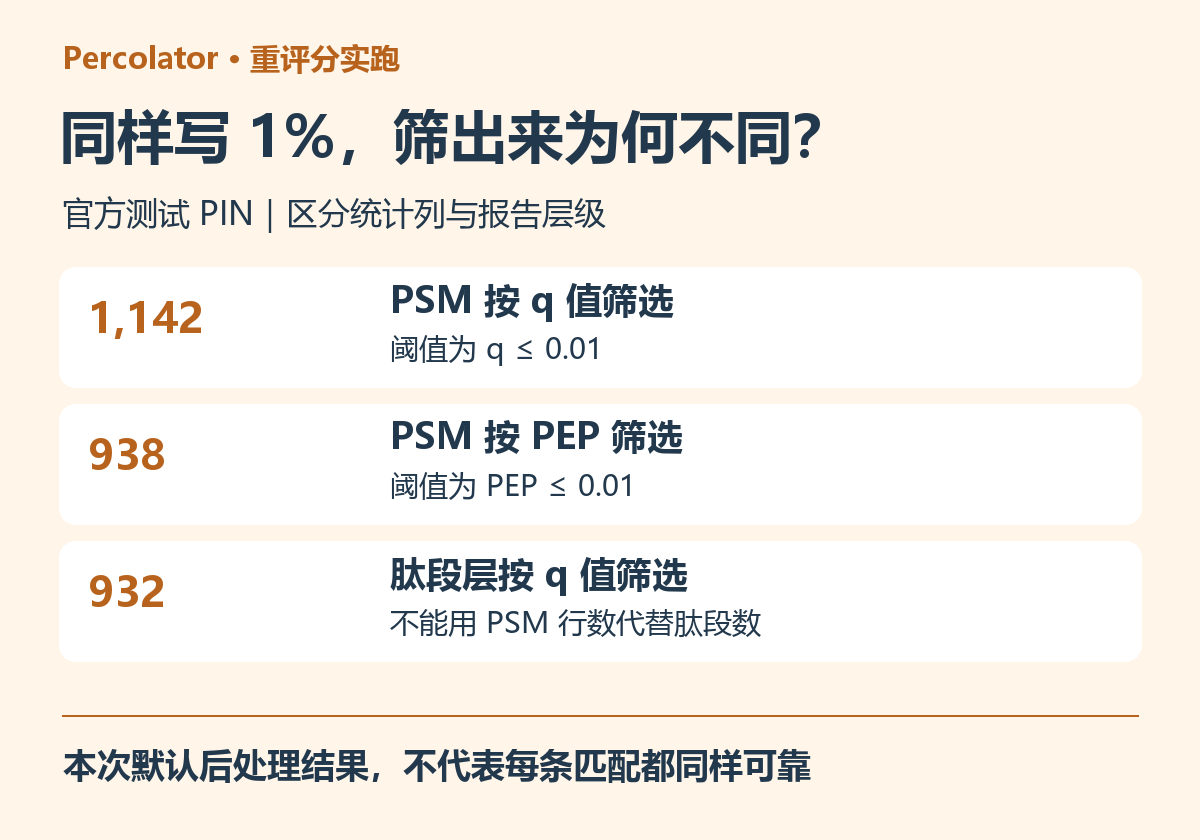
默认运行识别输入来自分开的目标与诱饵搜索,并在日志中明确说明使用 mix-max 后处理。最终目标 PSM 表仍有九千八百五十二行,其中只有一千一百四十二行满足 q 值不超过零点零一。也就是说,生成结果表和完成阈值筛选是两个步骤,不能直接把文件行数写成高置信鉴定数。
下面对比默认后处理与显式加入 --post-processing-tdc 的运行。每个数字都来自对应的最终结果表,阈值统一使用小于或等于零点零一,未把表头计入数量。
| 最终结果项目 | 默认后处理 | 目标诱饵竞争 |
|---|---|---|
| 目标 PSM 总行数 | 9852 | 5859 |
| 通过 q 值阈值的目标 PSM | 1142 | 1147 |
| 通过 PEP 阈值的目标 PSM | 938 | 971 |
| 通过肽段层 q 值阈值的条目 | 932 | 938 |
目标表的总行数明显减少,而通过阈值的数量略有增加,并不矛盾。竞争步骤先改变保留的候选集合,后续错误率估计也随之改变。这个例子只说明两套后处理的行为不同,不能据此宣称某个开关在所有数据上都更准确。应先确认上游是合并数据库搜索还是分开搜索,再选择匹配的处理方式。官方后处理参数
q 值与 PEP 回答的是不同问题
q 值把某条匹配放在一份按得分筛选的结果列表中解释,可以理解为让它进入结果时所对应的最低错误发现率水平。PEP 则估计这条具体匹配出错的后验概率。两者相关,但作用对象不同,因此不能把一列换成另一列后仍声称采用了完全相同的筛选规则。q 值与后验错误概率的方法解释
默认运行的实际结果中,有二百零四条 PSM 通过百分之一的 q 值筛选,但其 PEP 大于百分之一。例如一条匹配的 q 值约为零点零零一七四四,PEP 约为零点零一零零七九。把两个数换成百分数,分别约为百分之零点一七四与百分之一点零零八。小数、百分数以及对应的列名,都应在交付说明里写清。
这个现象不表示概率列互相冲突。一份总体错误比例较低的筛选列表,仍可能包含个别风险相对较高的条目。如果后续要挑选少数候选做昂贵的实验验证,应该逐项检查这些候选的证据与 PEP,而不是只说它们来自一份通过整体阈值的列表。反过来,也不能把同一个数值的 PEP 门槛当成 q 值门槛的同义写法。
筛选脚本最好直接保留列名和比较方向,避免在电子表格里用肉眼挑行。下面是针对已经生成的目标 PSM 表进行读表的方式。它没有重新训练模型,也不改变原始输出。
import csv

with open("target.psms.tsv") as handle:
    rows = list(csv.DictReader(handle, delimiter="\t"))
q_pass = [r for r in rows if float(r["q-value"]) <= 0.01]
pep_pass = [
    r for r in rows
    if float(r["posterior_error_prob"]) <= 0.01
]
print(len(rows), len(q_pass), len(pep_pass))
一千条谱匹配不能直接写成一千条肽段
同一个肽段可以在多张谱中被反复匹配,也可以以不同条件出现在多个候选记录里。因此 PSM 数量与肽段数量本来就不同。默认运行得到一千一百四十二条通过 q 值阈值的目标 PSM,而肽段层结果只有九百三十二条通过自己的 q 值阈值。报告中应分别列出所采用的层级,不能只写“鉴定到多少条”。
竞争运行还给出了一个更细的对照。通过 PSM 层 q 值筛选后,按输出肽段表示去重得到九百三十九种,但在肽段层表中按同样数值筛选,得到九百三十八条。简单去重与肽段层错误率估计并非同一个操作,哪怕某次默认运行碰巧得到相同数量,也不能把两种方法永久视作等价。
去重时还要写明是否保留修饰。本文的读表检查去掉肽段两端的侧翼标记,保留主体中的修饰表示,没有把所有修饰形式合并成裸氨基酸序列。若研究问题改为统计不考虑修饰的序列种类,计数规则也必须随之改变。这个变化属于结果汇总口径,不应悄悄藏在去重函数里。
本篇没有运行蛋白层推断。PSM 表中出现某个蛋白编号,只说明该候选肽段被关联到这个条目,不足以证明已经获得受控的蛋白层错误率。共享肽段、蛋白组归并和蛋白层阈值需要相应步骤,不能由一张 PSM 表自动代替。
去重为什么还需要文件名和前体信息
显式竞争运行在日志中报告,按文件、扫描与实验前体质量的组合保留高分候选。官方说明也强调了这些字段的作用。若只用扫描号合并多次进样,两个文件里相同的扫描数字可能被错误当成同一对象。若一个扫描对应多个不同前体,又要检查相关质量字段是否足以区分它们。竞争与 PSM 去重规则
本次测试输入没有多文件字段,我们只在它自身的标识范围内做对照,没有把它扩展成多进样合并实验。真实队列合并前,可以先用文件名、扫描号和前体信息统计重复组合,再决定如何编码唯一标识。不要只看到结果行数下降,就认为软件成功删除了所有“多余数据”。
日志中的训练过程与最终输出也需要分开。本次迭代日志出现过一千一百九十七条的估计,后续测试集合日志为一千一百四十一条,而最终目标 PSM 表按本文阈值统计是一千一百四十二条。这些数字来自不同阶段,不能挑最大的一个写进结果部分。本文核对过最终表中的严格小于与小于等于计数相同,所以这一条差异也不能简单归因于阈值是否包含等号。
删掉诱饵以后,软件给出了明确错误
最后一个对照只保留目标记录,其他列与方向设置仍然保留。实际调用后程序以非零状态退出,说明没有提供诱饵 PSM。这个结果非常适合检查数据交接流程。有时上游为了“清理结果”先删掉诱饵,再把剩余表格交给重评分工具,反而移走了估计错误所需要的信息。
遇到此类问题,应回到未经这种清理的搜索或转换结果,恢复与目标匹配采用相应搜索条件的诱饵记录。不能简单把一部分目标标签改成负一,也不能复制目标行伪造数量相等的诱饵。数量平衡并不等于诱饵设计合理,随意改标签会改变模型所依据的错误参照。
Percolator 的优势在于联合利用多个搜索特征,并为不同层级输出可检查的统计量。它的局限也很具体,输入特征、目标诱饵设计及候选集合会影响结果,数据量过小或特征失真时不能仅凭程序完成就认定结果可靠。需要核实某条争议候选时,仍要回看原始谱图与匹配证据。
下载本篇官方测试输入复跑与读表核验包。脚本按固定地址下载输入并校验摘要,分别保存两套完整输出及缺少诱饵的错误日志。解压后从工具目录执行下面的命令,输出目录必须尚不存在。包中附有本次预期结果,可逐项对照。
python3 run.py percolator_practice \
  "$PWD/percolator_env/bin/percolator"
当单次重评分进入多批队列处理,最有价值的交付是原始候选、版本、完整日志和统一的层级筛选规则。团队需要共同复跑这些流程时,可了解云生信的生物信息分析服务器。


