
筛选结束后,把结果表按最低分排序,复制前三行准备实验,看起来已经完成了候选选择。但这三行可能来自同一个化合物的不同姿势,也可能来自不常见的质子化状态。还有一些输入没有产生姿势,早已从结果表中消失。如果没有先理清一行究竟代表什么,后面的排名即使算得完全正确,也可能回答了错误的问题。
本文以 Glide 结果审阅为背景,解释分数列、母体化合物、准备后的化学状态和对接姿势之间的关系。配套 Python 练习已经实际运行,使用作者构造的六条姿势记录演示汇总与检查。没有安装或运行 Glide、LigPrep、Epik,没有生成真实分子或对接构象,所有示例分数均为教学值。
从母体到状态,再到姿势
一个待筛母体在结构准备阶段可能对应多个质子化或互变异构状态,同一准备状态又可能输出多个对接姿势。因此,至少需要区分三个层级,原始候选是谁,实际对接的是哪个状态,这一行又是哪一个空间摆放。三者不应挤在一个随意拼接的名称里,再靠删除后缀恢复关系。
建议分别保存母体标识、状态标识和姿势标识,同时保留原始结构记录的来源。如果同一个文件名曾在不同批次重复使用,还应加入准备批次。连接表格时依靠明确的键,而不是文件排列顺序,可以减少把某个分数接到另一个状态上的风险。
这里的母体分组也需要化学上合理。不同立体异构体可能是不同的实验候选,不能因为共享一段名称就自动合并。去盐、质子化和互变异构处理同样应有记录。本文只用 A、B、C、D 表示人为设定的母体关系,并未执行任何化学标准化或状态枚举。
Emodel 与候选排序的分数各有用途
Glide 输出中可能同时包含 GlideScore、DockingScore 和 Emodel。它们不能因为都是数值就任意互换。官方说明将 Emodel 用于同一配体的姿势选择,而将 GlideScore 用于化合物排序。实际工作还要结合准备状态和所启用的评分修正,明确最后使用哪一列。官方对接与评分说明
读表时可以先在同一个准备状态内部比较姿势,保留选中姿势对应的各项属性,再进行状态和母体层面的整理。不要从第一行取最低分,从第二行取最好接触,从第三行取最好几何,拼成一个实际上不存在的“最佳姿势”。同一行或同一个姿势键,是连接这些证据的基础。
原创练习中,A 的同一状态有两个姿势,Emodel 分别为负五十五和负六十,按照本例规则保留后者。它的 DockingScore 为负九点二。这两个数仍属于同一个姿势,不能把它的 Emodel 与另一个状态的负十一分直接拼接,随后声称某个单一构象同时具备两项优势。
另外,练习给 C 设置了全表最负的 Emodel,数值为负一百,但它并不是后续母体排名第一的候选。这是故意构造的提醒,不能把用于同一配体姿势比较的量,无条件提升成不同化合物之间的唯一排序标准。
状态罚分是为了回答另一个问题
一个状态在口袋中获得很有利的相互作用评价,并不意味着这个状态在进入口袋之前同样容易形成。相关状态罚分用于考虑采用某种质子化或互变异构状态的代价。官方支持文档说明,在相应准备和选项启用时,这类罚分会参与最终 DockingScore。状态罚分与 DockingScore
本文练习明确约定,没有其他评分修正,DockingScore 等于 GlideScore 加状态罚分。这只是该人工数据集的算术定义,不是宣称所有版本、模式和选项下都必须严格满足同一简单公式。面对真实输出,应查看实际配置和字段说明,再判断有哪些项已经计入。
在这个约定下,A 的状态 a1 原始分数为负十一,状态罚分为三,合成后为负八。B 的状态 b0 原始分数为负九点五,罚分为零,合成后仍为负九点五。若只看原始分数,会优先注意 A 的 a1,把本例规定的罚分纳入以后,B 的 b0 更靠前。
| 人工准备状态 | GlideScore 与状态罚分 | 本例 DockingScore |
|---|---|---|
| A 的 a1 | -11 加 3 | -8 |
| B 的 b0 | -9.5 加 0 | -9.5 |
| B 的 b1 | -10.5 加 2 | -8.5 |
最常见的整理错误之一,是导出的 DockingScore 已经包含罚分,表格公式又加了一遍。练习对 A 的 a1 故意执行这一步,得到负五,而正确结果是负八。检查程序发现该值不满足事先约定的算术关系,明确拒绝。对真实输出也应先追踪字段定义,不能看到一个“罚分”列就再加一次。
罚分缺失也不能一律当作零。它可能意味着该记录没有经过相应准备流程,或者字段在导出时丢失。零表示一个明确的数值,缺失表示信息尚不完整,两者含义不同。如果确实采用了不使用该项的流程,应在元数据里说明,而不是靠填零掩盖来源差异。
前三行为什么只有两个候选
练习共有四个母体、六个准备状态。其中五个状态成功产生姿势,一个状态没有姿势。因为 A 的 a0 有两个姿势,最终仍得到六条姿势记录。直接数结果行,看起来与输入状态数量相同,但两者并不是同一批对象的一一对应关系。
把六条姿势按本例 DockingScore 从低到高排列,前三条分别是 B 的 b0、A 的 a0 第二姿势,以及 A 的 a0 第一姿势。它们只有两个不同母体。如果实验预算允许检测三个化合物,复制这三行并没有得到三个独立候选。
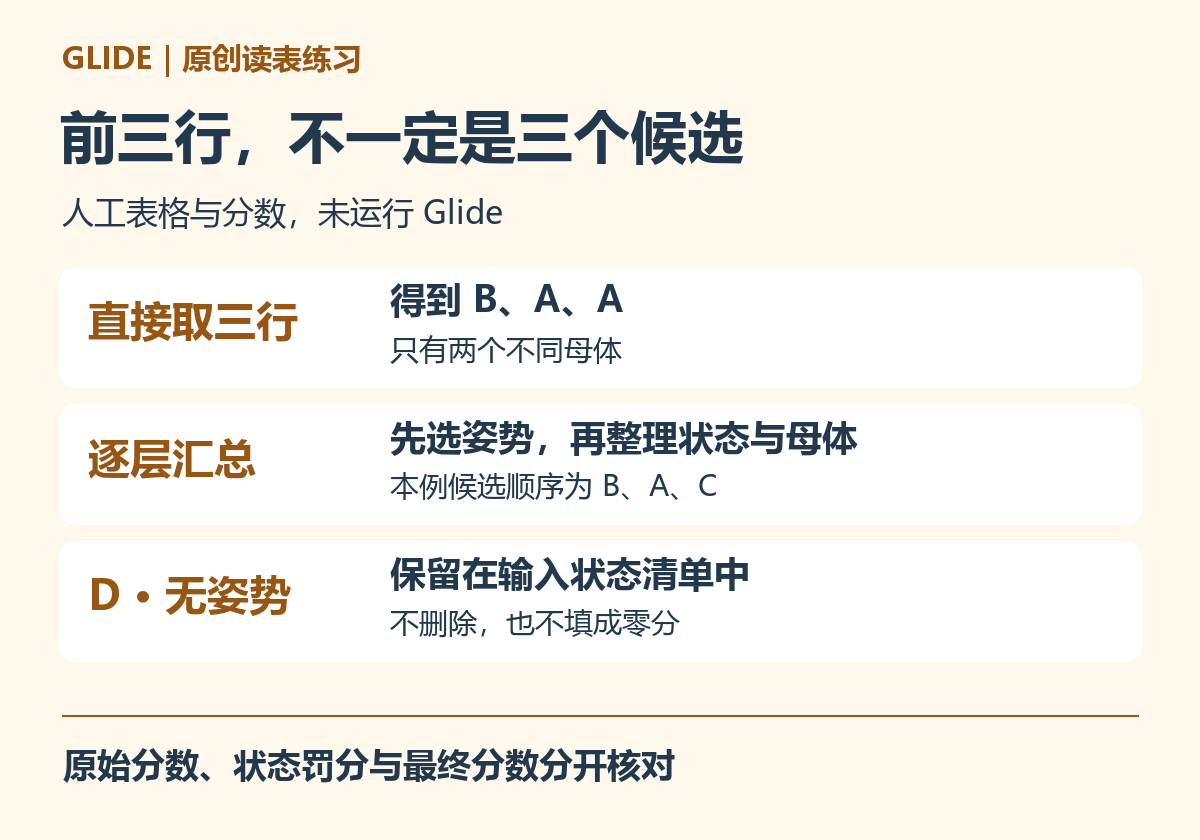
本例先在同一状态内部按 Emodel 选择姿势,再为每个母体保留 DockingScore 最低的状态代表,最后得到 B、A、C 的顺序。对应分数为负九点五、负九点二和负八。这是明确声明的候选整理规则,而不是对所有筛选任务都有效的化学结论。
| 汇总层级 | 本例数量 | 应保留的信息 |
|---|---|---|
| 输入母体 | 4 | A、B、C、D 的来源 |
| 输入准备状态 | 6 | 每个状态所属母体 |
| 成功输出状态 | 5 | 成功状态与失败去向 |
| 姿势记录 | 6 | 状态、姿势与对应分数 |
| 有代表姿势的母体 | 3 | B、A、C,另列 D 无姿势 |
如果某个母体准备了远多于其他母体的状态,取最小值也会受到搜索机会数量的影响。更多候选状态提供更多获得极端分数的机会,并不自动表示这个母体更可靠。除了最终代表值,还应报告状态数、保留规则和准备条件,必要时审阅排名是否主要由少见状态驱动。
也不要为了消除这种差异,未经方法依据就把不同状态或不同姿势的分数做普通平均。它们不一定是等概率、相互独立的观测,更不是一组实验重复。状态整合涉及什么问题,应先在分析方案中明确,再选择与之相符的方法。
没有姿势不等于不结合,也不能补成零分
练习中的 D 保留在输入清单中,状态标记为没有姿势,但不进入有数值的候选排序。这样既不会把它从项目分母中删除,也不会凭空给它一个零分。零分会被后续统计当作真实评价,而该任务实际上没有产生可比较的姿势结果。
真实任务没有输出可能发生在多个阶段,例如结构准备不完整、构象生成未成功、约束无法满足,或者后续筛选没有留下结果。应该回到对应阶段的日志确认原因。只有知道失败发生在哪里,才能决定修复输入、调整有依据的设置,还是接受当前流程没有给出候选这一事实。
批量筛选尤其需要一张覆盖所有输入的状态清单。输出结果表适合看成功模型,但它通常不能独立回答哪些输入没有完成。用输入清单连接各阶段记录,可以分别统计准备成功、提交成功、产生姿势以及最终通过筛选的数量,让完成率和候选数量有清楚分母。
还应区分一个母体已有部分结果,与它的所有计划状态都已完成。如果某个状态先返回,另一个状态仍在计算,提前给母体确定最终排名可能遗漏后来结果。批次完成判断可以依靠状态清单逐项核对,而不是看到输出文件存在就认定整个候选已经处理完毕。重试任务也要记录替代关系,避免同一状态的两次成功结果被重复统计。
不同网格或不同精度的分数别直接混排
Glide 支持不同筛选模式和流程安排,适合在大规模候选整理中逐步深入检查。但某一阶段的分数与另一阶段的分数不能只因为列名相同就放进一个总排序。受体构象、网格设置、结构准备和评分选项的变化,都可能改变比较条件。Glide 官方产品与流程介绍
练习给所有有效记录固定了同一个网格、SP 标记和准备批次。随后分别把一行的网格改成另一份,把一行的精度标记改成 XP,检查程序都拒绝进行统一排序。它做的是元数据一致性检查,没有运行这些模式,也没有比较它们的计算表现。
多受体构象筛选当然可以成为合理设计,但需要提前规定跨构象如何汇总,不能临时从每个受体结果中挑一个最负值,然后假定它们处于完全相同的标尺。保留受体与网格标识,至少能够让后续读者知道某个候选的优势来自哪种结构条件。
分数看起来精确,不代表结论同样精确
软件可以输出多位小数,这主要反映输出精度,不直接等于模型对实验亲和力的预测精度。官方对评分单位的说明也强调,经验评分中的分项经过参数化处理,不能把每个分项都当作独立、定量的热力学能量解释。评分单位与分项解释
因此,两个候选相差零点一或零点二时,不宜仅凭这点差距安排完全不同的实验优先级。还应结合输入化学状态、姿势合理性、关键接触、明显冲突以及实验可行性审阅。本文没有提供任何实验活性数据,人工排名也不代表某个化合物更可能成功。
更稳妥的交付是一张候选层级清楚的表,既显示母体代表,也能展开到状态和姿势明细。所有主张都应指回具体姿势和配置。这样出现分数争议时,可以检查字段含义和汇总步骤,而不是重新打开一堆名称相似的文件猜测来源。
选出代表记录不意味着其余姿势应被删除。若几个姿势分数接近但关键接触不同,保留备选及选择理由有助于后续验证。候选摘要用于快速浏览,明细用于复核,两者应通过稳定标识连接,而不必把所有信息压成一个没有上下文的最低分。
把四项检查留在结果整理脚本里
本次实际运行的脚本拒绝了重复姿势键、混用网格、混用精度以及重复加罚分四种错误。它输出每个母体的代表记录、原始前三行与独立母体数量,并保留 D 没有姿势这一事实。输入采用简化表格,不能直接代替 Maestro 原生文件解析,也不会检查真实分子的价态或立体化学。
把脚本连接到真实导出表之前,应先核对实际列名、数值缺失、版本和修正项,再按项目约定调整检查条件。Glide 的便利在于能组织准备、对接与筛选流程,而可靠的候选选择仍需要明确每个数字的对象、来源和用途。读表不是简单找最小值,而是把数值放回它所属的分析层级。
下载原创审阅练习与核验结果(ZIP)。按本文工具名称选择目录,Python 标准库即可运行,使用新的工作目录保存结果。包内逐项说明人工输入与实际检查范围,不包含对应软件程序或模型。
当候选汇总规则已经明确,需要组织多批配体和不同受体条件的计算时,可了解云生信生物信息分析服务器,按软件许可、任务规模和结果保存需求沟通环境。


