一个单细胞基础模型能把细胞分得更准,是否就更懂细胞受到基因扰动后会发生什么?
这是两个经常被放在同一张“虚拟细胞”路线图上的问题,却需要不同证据回答。11月11日电子发表、11月13日进入PubMed的 scREFINE,提供了一个值得细读的例子:它说明预训练表示可以针对聚类任务继续调整;它没有检验模型能否预测未见过的干预响应。
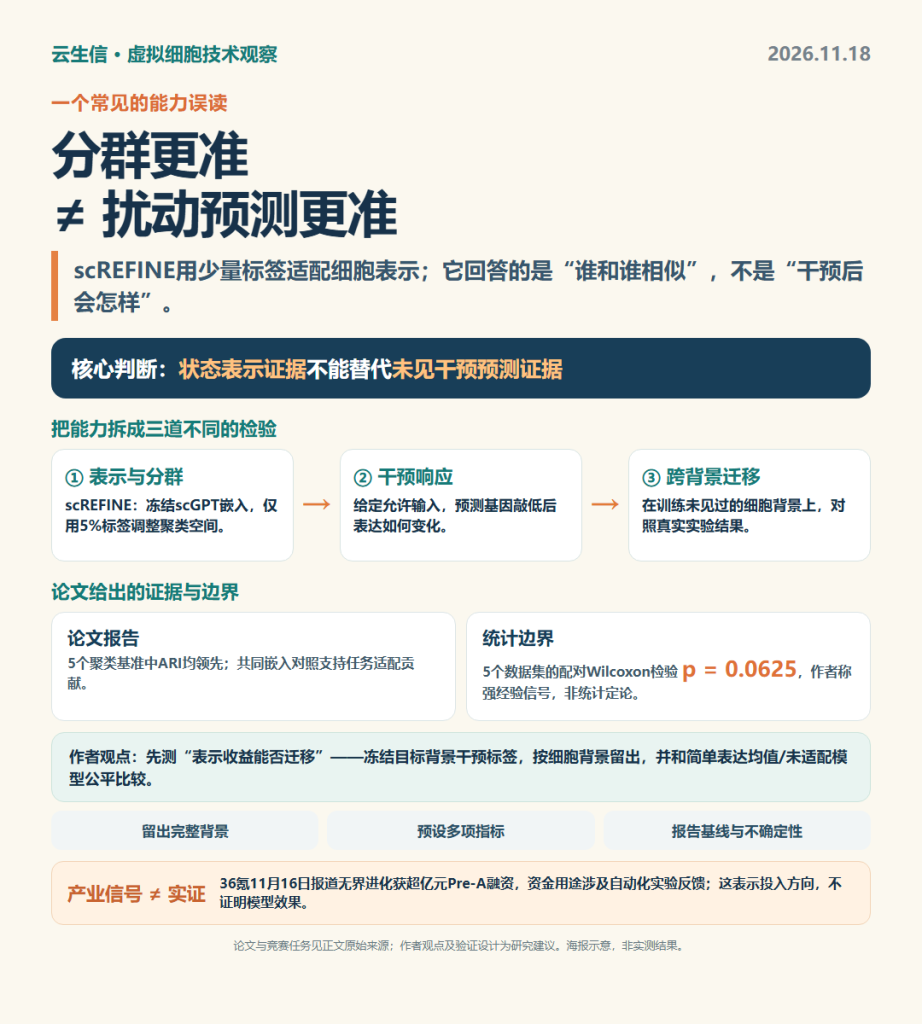
我的判断是:虚拟细胞的评估不能用“细胞表示更好”代替“干预预测更可靠”。前者是建立状态地图,后者是预测地图上的状态如何因干预而改变。两者有联系,但能力边界不同。
scREFINE做了什么?
scREFINE以冻结的 scGPT 表示为输入,不微调整个基础模型,而是在其上增加轻量的任务适配层。训练时只用5%的细胞标签,其余细胞保持未标注;模型再利用局部细胞邻域结构,以软约束吸收未标注数据中的关系信息。
作者在5个单细胞数据集上比较了聚类结果。摘要报告,在其统一、无标签泄漏的评估协议下,scREFINE在每个数据集都取得最高ARI;共同嵌入对照也显示,改进主要来自任务适配,而不是单独使用预训练嵌入。可是,5个数据集上的配对Wilcoxon检验为 p=0.0625。作者据此把跨数据集的一致结果解释为强经验信号,而不是统计上已经定论的证据。这不等于没有改进;但只有5个数据集时,跨数据集检验的信息量有限。更稳妥的阅读方式,是同时看每个数据集的结果和标签抽样变化,并等待更多独立队列复核,而不是把“每组都领先”直接写成已证明的普遍优势。PubMed摘要与论文信息;期刊论文页面
这里最有价值的不是一句“只需5%标签”,而是研究把两个贡献拆开了:通用表示提供起点,任务适配决定表示是否适合当前问题。如果只将模型的预训练规模当成能力代理,就看不到这一步适配的作用。
聚类表现好,和预测扰动响应仍是两道题
聚类问的是:在当前测量到的表达空间里,哪些细胞彼此相似、可归为相近群体?扰动预测则问:给定干预前可获得的信息,改变一个基因或加入一种处理后,细胞状态会怎样改变?
前一个问题主要检验状态表示与分群结构;后一个问题需要模型预测干预造成的变化,并在独立的实验读数上评估。高质量的状态表示可能帮助扰动建模,但它本身并不证明模型学到了干预与响应之间可迁移的关系。
手机阅读可左右滑动查看完整表格。
| 证据层级 | 典型任务 | 能支持的结论 | 不能单独推出 |
|---|---|---|---|
| 状态表示 | 细胞嵌入、降维、聚类 | 表达状态可被组织或区分 | 未测干预下的因果响应 |
| 标签效率 | 少量标签辅助聚类/注释 | 标注稀缺时能否利用已有结构 | 零样本跨细胞系泛化 |
| 扰动响应预测 | 预测基因敲低/药物处理后的表达变化 | 特定数据与终点下的响应预测能力 | 新组织、新平台或临床疗效 |
| 实验闭环 | 按模型排序候选并做盲法实验 | 是否能改变实验选择并命中验证 | 对所有疾病或药物的普遍有效性 |
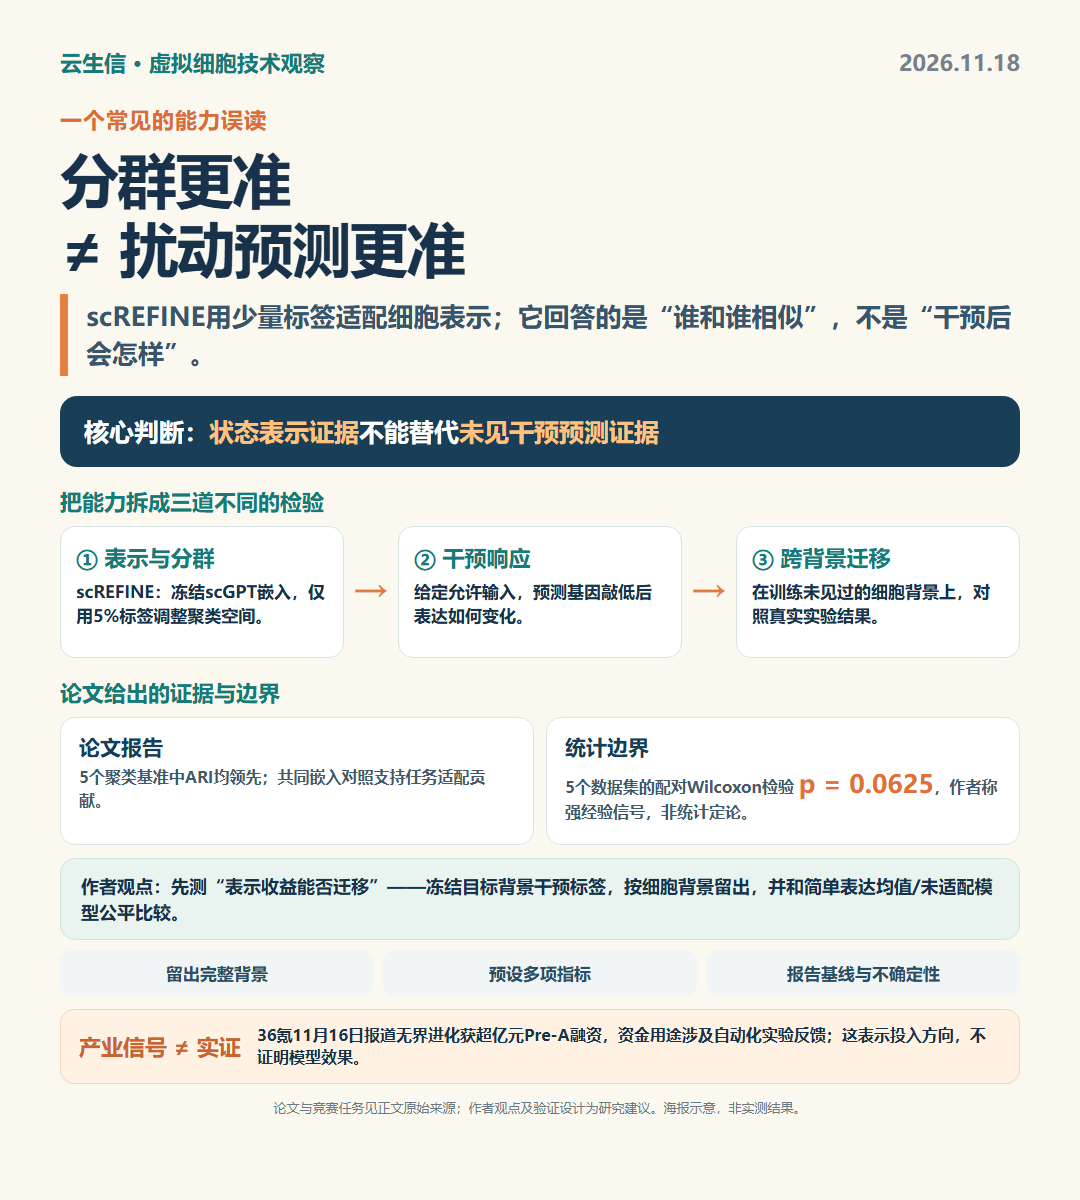
这个区分与当前基准设计有关。Arc Institute 的2026 Virtual Cell Challenge把重点放在未见细胞背景的零样本泛化:参与者基于未扰动对照预测CRISPRi响应,验证与最终测试包含不同的干预集合;官方页面说明最终榜单与获胜者将在11月下旬公布,Arc的竞赛报道将日期列为11月19日。挑战赛官方任务与数据说明;Arc Institute竞赛介绍
所以,即使一个表示模型能用少量标签把某队列分得更好,仍需单独检验它能否在没有目标细胞背景扰动标签时预测响应。把这两类成绩混为一谈,会高估虚拟细胞距离“可用于实验决策”的程度。
近期产业动向把“从模型到实验”的问题推到台前
36氪于11月16日报道,无界进化完成超亿元Pre-A轮融资,并称资金将用于细胞响应预测、科学假设检验及高通量自动化实验反馈等方向。36氪报道
这条消息是产业投入与研发方向的信号,不是独立的模型性能证据。融资规模不能说明模型预测准确,也不能证明闭环实验已经成功。真正值得跟踪的是:公司是否会公开预先设定的候选选择规则、盲法验证方案、失败结果和实验命中率,而不只是展示平台整合了多少数据或模块。
这也给学术研究一个提醒:当虚拟细胞开始用于安排实验,评价标准应从“能否生成一张看起来合理的图”转向“它是否比简单基线更好地选中了下一项实验”。
我的判断:先证明“表示收益能迁移”,再谈通用虚拟细胞
scREFINE支持一个有限但重要的结论:基础模型的冻结嵌入不是终点;即使只开放少量标注,针对具体任务适配也可能带来明显收益。但这篇研究的训练目标是聚类,不是扰动响应,因此它是虚拟细胞的状态表示组件证据,不是完整虚拟细胞的直接验证。
这个判断可以被实验证伪。若在预先锁定的独立扰动数据上,scREFINE式的状态适配在不使用目标细胞扰动标签的前提下,反复优于简单表达均值、同源细胞系迁移和未适配scGPT等基线,而且改善同时体现在效应方向、差异基因排序和多个扰动背景中,那么就有理由认为这类适配不仅改善了聚类,也给干预预测带来了可迁移增益。反过来,若优势只出现在同一队列的聚类指标,迁移到扰动预测时消失,就应把它定位为注释/分群工具,而非响应模拟器。
下一步如何验证这个观点?
一个可执行的分析设计可以分三步:
- 先固定数据切分。按细胞背景或实验批次留出完整测试集,防止同一背景的细胞同时进入训练和测试。
- 做表示对照。比较原始 scGPT 嵌入、scREFINE适配嵌入,以及简单的基因均值/线性模型;标签只在训练背景中提供。
- 再评估扰动。在未见背景中预测预先定义的基因敲低响应,并同时报告效应方向、响应基因排序、总体表达偏差和不确定性。不要只选对模型有利的单一指标。
这是一项研究建议,不是scREFINE论文已做的实验。现有研究使用5个聚类基准,尚不足以证明跨组织、跨平台、跨扰动类别的通用性;竞赛的隐藏测试能提供更强的基准压力,但仍不能替代针对具体疾病与实验条件的前瞻验证。
把虚拟细胞拆成可检验的能力
“虚拟细胞”不是一个单一分数。至少要区分细胞状态表示、细胞注释、干预响应预测、跨背景迁移,以及能否帮助筛选真实实验。scREFINE把“少量标签能否改善状态分群”推进了一步;它没有越过“是否能预测未见干预”的证据门槛。
读论文或评估一个平台时,可以先问三个问题:模型究竟预测了什么?测试数据是否来自未参与训练的生物学背景?它是否比简单基线更能选出值得做的实验?回答清楚这三问,才能判断我们是在看一个更好的聚类器,还是一个开始具备干预预测能力的虚拟细胞。
参考资料
- Sadik S, et al. scREFINE: Label-efficient refinement of frozen scGPT embeddings for single-cell RNA-seq clustering. Computational Biology and Chemistry. DOI: 10.1016/j.compbiolchem.2026.109535. PubMed记录
- Arc Institute. The 2026 Virtual Cell Challenge: predicting perturbation responses in cell contexts a model has never seen. 官方竞赛介绍
- Virtual Cell Challenge 2026. 任务、数据与赛程
- 36氪. 无界进化完成超亿元Pre-A轮融资. 2026-11-16. 原报道