
谱库已经转换成目标格式,程序也正常退出,是否就能进入后续分析?一次很小的对照实验表明,答案取决于你检查了什么。文件存在、条目数正确,并不能保证保留时间的含义正确。同一个数字被按分钟或秒解释,可能使整个谱库的时间尺度相差六十倍。
本文实际运行 EncyclopeDIA 的谱库转换功能,用四条原创理论谱构建两份库。两次输入的序列、电荷和碎片完全相同,只改变保留时间字段的数值。两次转换都成功,但数据库中存储的时间相差六十倍。我们还会检查碎片数组、蛋白映射和条目计数,形成一个转换后可以立即使用的审阅方法。
执行范围限定在 MSP 转 DLIB,没有搜索实验 DIA 文件,没有进行保留时间拟合、错误发现率估计或蛋白定量。人工谱只用于检测数据结构和单位传递,不能代表真实样品的鉴定能力。
谱库在分析流程中扮演什么角色
谱库提供候选肽段及其参考碎片等信息,后续分析再把实验数据与这些候选对应起来。它可以来自实验构建,也可以包含预测或理论信息。来源不同,意味着保留时间、相对强度和覆盖范围的可靠性及适用条件不同,不能因为最后文件扩展名相同,就认为证据性质相同。
EncyclopeDIA 的库文件采用 SQLite 数据库结构。官方格式说明区分用于搜索的较简化库与包含更多定量、色谱信息的库,并说明了肽段、电荷、来源文件及蛋白映射的关系。理解这个结构,可以让我们在调用完整分析之前先做只读检查,见 官方文件格式说明。
一个带电荷的肽段条目,与一个裸序列不是同一个计数单位。同一序列使用二价和三价母离子,可以形成两个谱库条目。在本例中,两条序列各使用两个电荷,因此四条库记录是预期结构,不能写成四条独立肽段。
同样,谱库中存在一个条目,只表示候选信息被写进文件,没有证明该肽段在待测样品中被观测到。正式报告要明确区分库规模、搜索候选数、通过质量要求的肽段数和最终参与定量的对象数。
固定版本后怎样启动转换
本次从官方项目下载归档取得 EncyclopeDIA 4.9.19 的可执行 JAR,在 Ubuntu 22.04.5 上用 OpenJDK 11.0.33 运行。文件大小为约九十五兆字节,下载摘要和原始日志另行保存。本文只称这是本次实际运行的版本,没有把下载列表中的顺序当作最新稳定版本的保证。
首先调用帮助入口,再查看转换器子命令的帮助,确认它需要 MSP 输入和用于映射的 FASTA,并支持指定输出库。可执行归档及项目说明见 EncyclopeDIA 官方下载页。
java -Djava.awt.headless=true -jar encyclopedia-4.9.19-executable.jar -convert -mspToLib -h
java -Djava.awt.headless=true -Xmx1g -jar encyclopedia-4.9.19-executable.jar -convert -mspToLib -i minutes.msp -f demo.fasta -o minutes.dlib
这里的一吉字节参数只是本次四条人工谱练习使用的 Java 堆上限,不是对真实项目的资源推荐。输入规模、库内容和分析阶段变化后,应重新观察运行情况。本文没有开展大规模搜索,也没有拿极小输入的完成速度推算项目耗时。
命令行关闭图形界面,便于保存可重复的执行记录。运行结束后,还要同时检查退出码、日志、输出文件及内容。若上一次失败留下旧文件,单凭文件存在会误判,因此附件脚本要求使用尚不存在的新工作目录。
四条原创谱如何保持可检查
作者使用两条教学序列,每条配置二价和三价母离子。理论质量根据残基质量及水、质子贡献计算,碎片使用一组一价末端离子,强度由作者指定,没有借用任何实验峰形。第一条序列每个电荷含六个碎片,第二条每个电荷含八个碎片。
这组设计刻意让同一序列不同电荷拥有相同保留时间,也让两条序列的碎片数量不同。这样既能检查电荷层级,又能发现数组长度处理中的错误。若所有条目完全一样,很多错误在抽查时反而不容易暴露。
配套 FASTA 包含两个原创蛋白条目,各自包含相应教学肽段。转换日志实际读入四条谱和两个蛋白,随后完成映射并写出数据库。这只说明示例关系在输入中存在,没有经过生物样品验证,也没有提供自然蛋白丰度的信息。
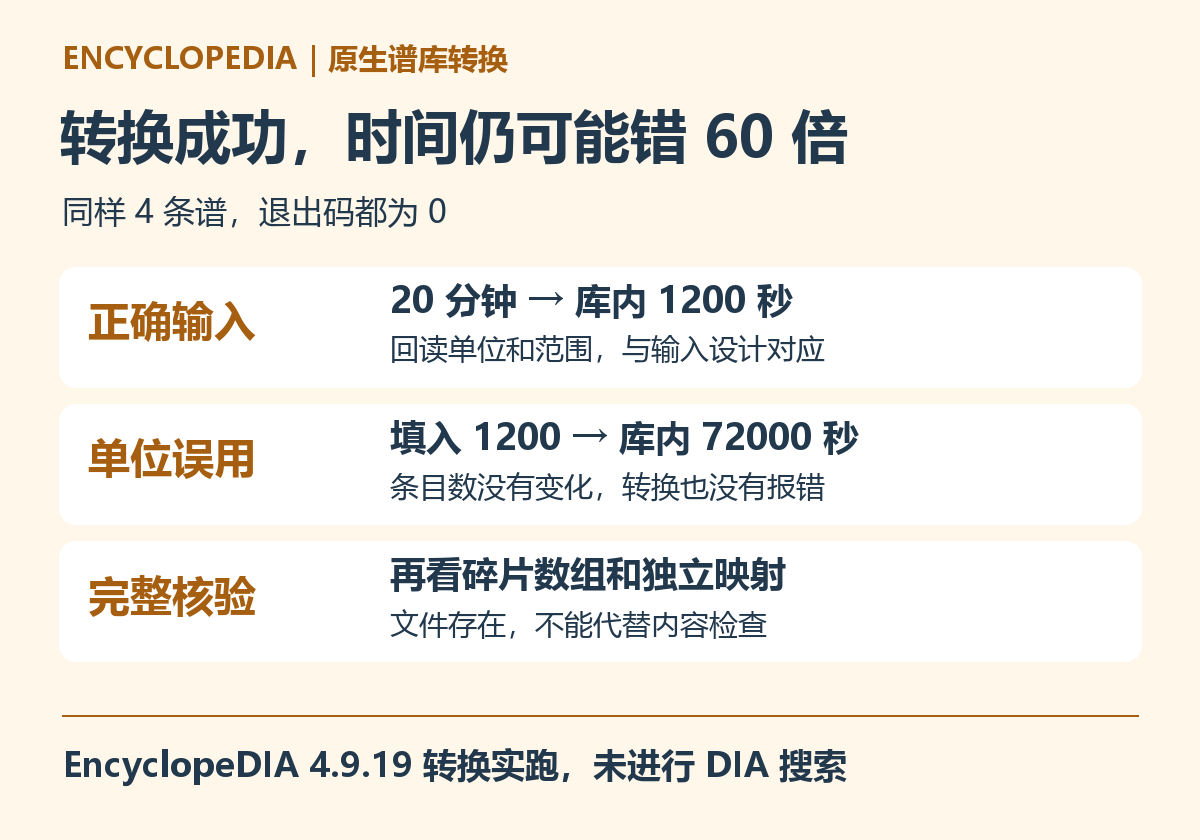
实际运行后的正确库包含四条记录,其中两条保留时间为一千二百秒,另外两条为一千八百秒。对应分钟分别为二十和三十,与输入设计一致。正文采用容易读懂的整数展示,具体母离子与碎片质量保留在附件生成的结果文件中。
单位错误为何没有阻止转换
本次 MSP 输入采用的注释字段名是保留时间,正确方案在其中写入二十和三十。该版本转换器在这条输入路径中,将它们解释为分钟,再在库的秒字段中保存为一千二百和一千八百。这个对应关系来自实际回读结果,不是仅凭字段名称猜测。
随后我们把输入数值改为一千二百和一千八百,也就是把已经换算成秒的数字放进同一位置。转换程序仍然正常结束,输出条目数也仍然是四个,但数据库中出现七万二千和十万八千秒,恰好相差六十倍。
| 检查项 | 正确分钟输入 | 秒数放入同一字段 |
|---|---|---|
| 输入数值 | 20、30 | 1200、1800 |
| 原生转换退出码 | 0 | 0 |
| 库条目数 | 4 | 4 |
| 库内秒数 | 1200、1800 | 72000、108000 |
这个例子不能推广成所有 MSP 变体、所有来源或所有版本都具有同一单位规则。不同软件导出的注释可能采用其他写法,甚至使用无直接时间单位的保留指数。迁移时应根据来源说明和转换器行为核对,最好抽取已知条目做一次小规模回读。
单位错误属于内容语义错误,数值本身仍是合法的数字,转换器不一定有足够信息判断实验梯度。它无法仅凭一个很大的时间值就知道用户原本想表达什么。因此,建立与实验时间范围相对应的检查,通常应由数据准备流程承担。
打开数据库后,先查少量明确字段
对这类库不必一开始就解压所有二进制内容。先以只读方式打开,查看条目表中的序列、电荷、来源和保留时间,通常已经能够发现大量问题。只读连接也能降低误操作修改原始库的可能性。
SELECT PeptideSeq, PrecursorCharge, RTInSeconds, SourceFile
FROM entries
ORDER BY PeptideSeq, PrecursorCharge;
检查时间时,应同时看单位、范围和分布。全部时间超出实验梯度,可能提示单位或来源不匹配。全部时间为同一个默认值,则可能表示输入没有提供可用时间信息。只有少数异常时,还应追溯相应条目,判断是否是混合了不同实验来源。
不要看到异常后直接在库里把所有数值除以六十。先确认错误发生在哪一段转换,修复原始输入或转换规则,再重新生成输出。否则后续重复运行时错误仍会回来,而人工改库还会让结果脱离可追溯的生成过程。
对于采用预测保留时间或保留指数的库,尤其需要区分数值尺度与实验分钟。把预测值机械解释成时间,即使量级看起来合理,也不能证明它已经与当前色谱系统对齐。本文没有进行任何预测或校准,仅验证明确设定的时间传递。
碎片数组不能直接当普通文本读取
库内碎片质量与强度以压缩的二进制数组保存。官方格式说明给出了压缩方式和字节顺序,本次核验依此解压,再分别读取双精度质量数组和单精度强度数组。需要注意,长度字段表示的是未压缩字节数,不是直接可用的碎片个数。
第一条教学谱的质量长度为四十八字节,对应六个双精度数,强度长度为二十四字节,对应六个单精度数。若把四十八当成四十八个碎片,统计结果会被放大。把大小端顺序弄反,则可能得到非常离谱的数值,看起来像输入质量损坏。
本次还遇到一个自编核验脚本的问题,起初把所有二进制字段都按浮点数组处理,导致读取失败。修正时只对质量和强度等对应字段采用正确类型,其他字段按其实际结构分别处理。这是审阅脚本的类型假设错误,不是转换器生成了坏文件。
最终检查确认四条记录的质量和强度数组一一对应,长度分别为六、六、八、八,质量按升序排列。数组检查通过并不能证明理论峰符合真实碎裂过程,但可以证明本例的数值在格式转换中没有发生错位或截断。
蛋白映射也要先去除计数歧义
本次蛋白映射表回读得到四行,但只有两种独立的肽段与蛋白对应关系。同一序列的两个电荷在这个转换结果中带来了重复关系行。如果直接用映射表行数报告蛋白数或独立关系数,就会产生多计。
这与前面的谱库条目计数属于不同层级问题。条目表需要保留电荷和来源等信息,蛋白映射则描述序列与蛋白之间的联系。关联多个表之前,要先确认每个表的唯一键,以及连接后会不会把一条证据复制成多行。
| 数据层级 | 本例实际数量 | 适合核对的内容 |
|---|---|---|
| 库条目 | 4 | 序列、电荷及来源 |
| 独立裸序列 | 2 | 肽段覆盖范围 |
| 映射表记录 | 4 | 是否存在重复关系 |
| 独立映射关系 | 2 | 去重后的序列与蛋白配对 |
真实蛋白组还存在共享肽段,一条序列可能对应多个蛋白。此时不能为了让表格变整齐就随意保留第一个蛋白,也不能把多个候选编号写成多个独立鉴定。应把映射歧义交给后续蛋白推断及结果解释,并保留原始关系。
这次小实验怎样帮助正式分析
EncyclopeDIA 谱库转换的便利在于提供统一入口,并把后续分析需要的信息写入可检查的数据库。相应的使用要求是理解输入格式及字段语义,接受文件格式一致并不等于实验条件一致。不同物种、修饰策略、碎裂方法和色谱条件的库,都需要结合实际项目审阅。
正式导入前,可以先抽取少量已知条目,核对质量、电荷、保留时间、碎片数量和蛋白关系,再扩展到全库汇总。对于异常条目,回到源文件定位,而不是仅在下游结果里排除。这样更容易区分输入问题、转换问题和搜索问题。
建议在转换记录里明确保留源文件摘要、程序版本和命令参数,并把异常条目的原始注释一起保存。来自不同来源的谱库不要先混合再追查单位,因为混合后的整体分布可能掩盖某一部分记录的错误。先分别通过检查,再合并并复查重复身份,会更容易定位变化发生在哪一步。
本次两个方案都返回成功,条目数也完全相同,只有回读时间内容才暴露出六十倍偏差。这说明一份可靠的转换验收记录,应当同时包含执行状态、结构一致性和语义合理性。附件保留原创输入生成、实际调用和只读核验脚本,读者可以按同样顺序检查自己的谱库。
下载脚本、运行说明与核验结果(ZIP)。附件包含原生转换调用脚本和实际核验结果。需自行准备文中版本的 Java 与可执行 JAR,脚本生成理论谱并只读检查数据库。工作目录须尚不存在。
当谱库和输入规则已经核对清楚,需要持续管理多批次 DIA 分析的环境与运行记录时,可了解云生信生物信息学分析服务器服务。


