
把基因型中的斜线变成竖线、补齐某个样本的缺失值,以及推断整个位点未检测的基因型,是三个不同任务。它们可能在同一条 Beagle 命令里完成,因此仅看输出文件“更完整了”,很容易误判究竟发生了哪种处理。
本次安装并实际运行 Beagle,用一套原创合成参考面板和目标样本做四组对照。我们会看到,关闭未检测位点填补之后,零星缺失仍然被补齐。更隐蔽的是,一个等位基因标签不匹配的已检测位点,也可能在输出中重新出现,但其身份已经变成参考面板引导的填补位点。
一、安装固定版本,先说明数据范围
本次于二〇二六年十一月十七日运行 Beagle 5.5,具体程序为 27Feb25.75f,使用 Java 11.0.33。程序从作者网站获取,并记录文件摘要,避免同名文件或环境变化导致结果难以追溯。下载及版本信息见官方页面,参数解释见官方使用文档。
练习生成八十个参考样本、三十个目标样本,以及六百个参考位点。单倍型由若干人工祖先片段拼接产生,没有真实人群资料。我们从目标输入中去掉每五个位点中的一个,留下四百八十个与参考匹配的位点,再添加一个目标样本独有的位点,因此目标文件总共四百八十一行。
为了区分整个位点缺失与个别样本缺失,还在部分保留位点中人为挖去二百一十个基因型。参考面板始终使用完整、已定相的基因型。合成数据的真值由脚本保存,可以检查已观测基因型是否改变,也能核对被遮蔽位点的剂量是否恢复。
下载原创脚本和实际输出后,可在装有 Java 的环境运行下面命令。脚本会获取固定程序并校验摘要,也可以指定已经下载的同版本文件。全部输入、命令和结果都会保存在工作目录中,附件不包含真实参考数据库。
python3 192-beagle/run.py output-beagle
# 也可以指定已经下载并核对版本的程序
python3 192-beagle/run.py output-beagle \
  --jar /path/to/beagle.27Feb25.75f.jar
这些数据只能用于观察输入输出规则。人工片段共享程度、位点频率和参考组成都与真实项目不同,所以本文不把小例子的运行时间或恢复比例当成性能和准确率评价。
二、三个任务必须分别核对
定相解决的是两个等位基因分别位于哪条单倍型上。比如一个杂合基因型写成零斜线一,只说明拥有两种等位基因。定相后写成零竖线一,才为它们在两条单倍型上的相对排列提供信息。这里的第一条与第二条单倍型,通常不能直接命名为父源和母源。
零星缺失填补处理的是已经存在于输入表中的位点,只是某些样本的基因型为空。整个位点填补则处理目标文件完全没有的位点,需要其他信息支持其推断。检查输出时,前者主要改变样本单元格,后者会增加相应的变异记录。
这种区别决定了计数方法。不能只统计输出行数,也不能只统计是否还有点号。最好同时记录样本数、位点数、缺失基因型数、相位标记及参考独有位点的数量。任何一个数量发生变化,都应能够对应到具体参数或输入关系。
本次无参考分析保留了目标的四百八十一个位点,二百一十个缺失基因型全部得到补齐。加入参考并保持默认填补后,输出六百个位点,其中一百二十个来自目标文件原先没有的记录。同时,那个只在目标文件中的位点没有进入输出。
| 运行方式 | 输出位点数 | 剩余缺失基因型 | 新增参考独有位点 |
|---|---|---|---|
| 无参考定相 | 481 | 0 | 0 |
| 有参考,默认填补 | 600 | 0 | 120 |
| 有参考,impute=false | 480 | 0 | 0 |
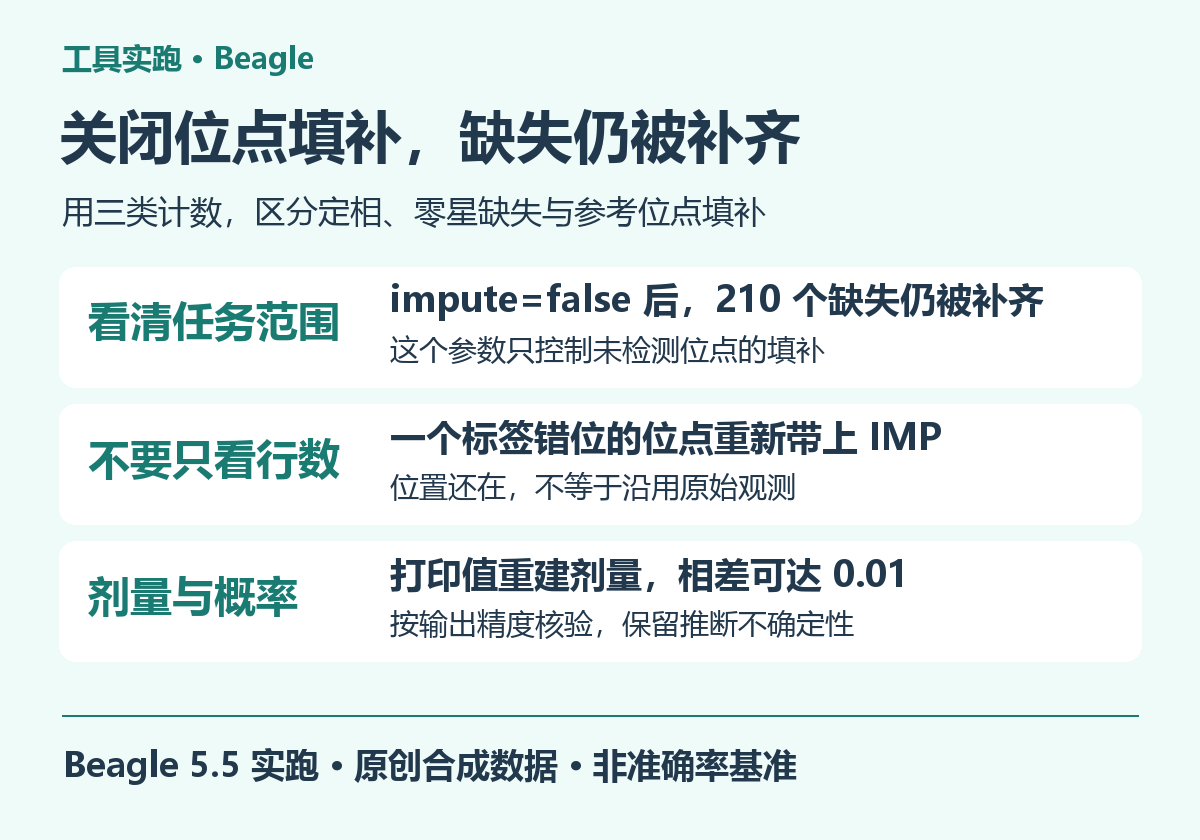
表中第三行是最容易误解的地方。关闭未检测位点填补后,输出只剩共同位点,但缺失基因型仍然全部被补齐。不能把这个参数解释为“任何缺失都不处理”。如果研究设计要求保留原始缺失状态,应在运行前保存缺失位置清单,并明确后续如何使用原始与推断信息。
三、用最少的参数建立可核验的基准
下面是本次有参考填补的核心命令。目标文件提供基因型,参考文件提供已定相且非缺失的单倍型,遗传图谱描述物理位置与遗传位置的对应。输出概率字段是为了教学核验而开启,默认情况下不一定都写入结果。
java -Xmx2g -jar beagle.27Feb25.75f.jar \
  gt=target.vcf \
  ref=reference.vcf \
  map=map.txt \
  out=impute \
  nthreads=2 seed=192 \
  gp=true ap=true
本文图谱是人工设置的线性关系,不能作为真实物种或真实染色体的图谱。正式分析需要匹配参考基因组版本和群体背景。物理距离与遗传距离不是同一个量,相同长度的两个区域也可能具有不同重组特征。
命令中的内存上限只用于限制本次小练习,不是大型参考面板的配置建议。窗口与重叠参数也有遗传距离单位,不能把它们理解为多少碱基。修改窗口时应同时检查重叠要求、实际标记密度及日志中的分窗情况,避免只根据文件大小随意调整。
固定随机种子时,也应记录线程数与软件版本。输入文件顺序、参考内容或并行设置发生变化后,不宜仅凭文件名相同就期待逐字节一致。复核时应先比较位点集合、样本顺序、已观测基因型保持情况和关键数值,再判断哪些差异来自相位或概率估计。
四、GT、DS 和概率字段分别回答什么?
GT 是输出的基因型及相位表示。DS 是替代等位基因剂量的估计,可以不是整数。两个单倍型上的替代等位基因概率分别由 AP1 和 AP2 表示,而双等位、二倍体情况下,GP 给出三个基因型状态的概率。
在本次输出的第六十个位点、第二十五个目标样本中,GT 为零竖线一,DS 为一点三八,两个单倍型概率为零点四四和零点九四,三个基因型概率为零点零三、零点五五和零点四二。这个例子比一个全为零或一的结果更能说明不确定性仍然存在。
GT   0|1
DS   1.38
AP1  0.44
AP2  0.94
GP   0.03,0.55,0.42
两个单倍型概率相加等于一点三八。若从打印出的基因型概率计算剂量,则是零点五五加二乘零点四二,得到一点三九。二者相差零点零一,并不是我们发现了统计矛盾,而是这些字段已经经过有限小数位输出。
本次全表核对中,DS 与打印概率重建值的最大差异为零点零一,概率之和也可能偏离一同样的数量级。程序因此按输出精度传播误差后设置容差,而不是要求小数完全相等。真实读表脚本也应先了解字段精度,避免把正常舍入误差错误标记为数据损坏。
另一方面,不能因为存在舍入,就忽略任何程度的不一致。如果出现剂量超出合法范围、概率明显不归一或字段长度不匹配,应检查是否误读了多等位位点、单倍体记录或字段顺序。先按 FORMAT 中的名称解析,不能假设每个文件的第二个值都代表剂量。基因型编码规则可以对照VCF 规范理解。
五、等位基因不匹配,可能被输出完整性掩盖
第四组对照只修改一个原本匹配的位点。我们把目标文件第七个位点的参考与替代等位基因交换,并同步翻转其基因型编码,使其在生物学含义上仍描述相同的两种等位基因。但是,没有在运行前把表示方式重新统一到参考文件。
结果输出仍然有六百个位点,原本的一百二十个填补标记变成一百二十一个。第七个位点重新出现时带上了 IMP 标记。这说明它没有作为原先完全匹配的目标记录参与同样的处理,而是以参考位点的身份被填补。
如果只检查“这个位置还在不在”,就会漏掉这种变化。应同时检查染色体、位置、参考等位基因、替代等位基因和来源标记。某个位点仍然存在,并不能证明它继续使用了原来已观测的基因型信息。
本例只涉及一个简单双等位位点,不能用来证明复杂变异能够通过交换字母自动修复。实际输入应先完成参考版本、变异标准化和等位基因方向核对,再进入定相与填补。对多等位变异及插入缺失,还需理解拆分或左对齐是否改变了记录形式。
六、填补质量分数,不是已经观察到的正确率
输出中的 DR2 是模型给出的剂量质量估计,不是把未知真值逐个核对后得到的实际正确比例。输出完整、缺失为零,也不能证明所有推断都正确。本次刻意遮蔽的一百二十个位点,合计三千六百个目标基因型中,有二十五个最佳猜测剂量与合成真值不一致。
这个数字的作用是提醒读者,完成填补之后仍然有推断误差。由于数据来自同一套简单人工片段,不能把这里的恢复表现外推到稀有变异、其他祖源或真实参考面板。相同的总体比例也可能掩盖某一类低频位点表现很差。
真实验证更适合保留独立的已知基因型作为遮蔽对照,并按频率、质量分数、变异类型和群体分别观察。若评估目标是后续关联分析,还应考虑剂量信息与硬调用之间的差别。把所有概率压成整数以后,某些不确定性已经被丢弃,不能再用同一解释衡量两种输入。
相位质量也与剂量正确不同。一个杂合位点的两个等位基因即使都正确,仍可能被分配到相反的单倍型片段。若评价跨位点相位,应使用适合的相位真值或家系信息,而不能只统计单个位点的基因型是否一致。
验证数据的独立性也需要检查。把目标样本的部分位点遮蔽,并不自动保证评价独立。如果同一个体已经包含在参考面板里,或参考与目标存在未说明的近亲关系,表面的恢复表现可能偏乐观。应在正式评估前核对样本重叠,固定遮蔽方案及评价分组,并记录排除规则。这样得到的结果才知道适用于什么范围,而不是只留下一个漂亮的总体比例。
七、版本、输入类型和输出来源要一起留档
Beagle 的不同大版本支持的输入方式并不完全相同。当前这条版本线以 GT 为核心,不能因为文件里存在 GL 或 PL 就认为程序会按基因型似然重新推断。旧教程中的低覆盖处理命令不一定适用于本文环境,应结合官方版本记录检查接口变化。
提交分析结果时,建议保留一份运行前的样本与位点清单,记录哪些单元格原本缺失、哪些位点目标未检测、哪些记录因参考不匹配而未保留。这样的来源记录可以帮助下游人员区分直接观测和模型推断,也方便重新评估过滤策略。
本次练习的核验并不复杂,但检查了四种不同事情。输出位点数是否符合参考与目标的关系,已观测非缺失基因型是否保持,缺失值是否按实际参数处理,剂量与概率字段是否在精度范围内一致。把这几项分开,才能避免用一个“运行成功”替代整个分析质量判断。
需要把定相、填补和结果核验固定为可重复流程时,可通过云生信生物信息学分析环境服务保存软件版本、参考面板和完整运行记录。


