
时间树上的一个数字究竟代表年、百万年,还是尚未赋予实际单位的相对时间,不能靠画图软件替我们决定。使用 BEAST2 时,最容易被忽略的工作之一,就是检查时间尺度与分子钟速率是否配套。
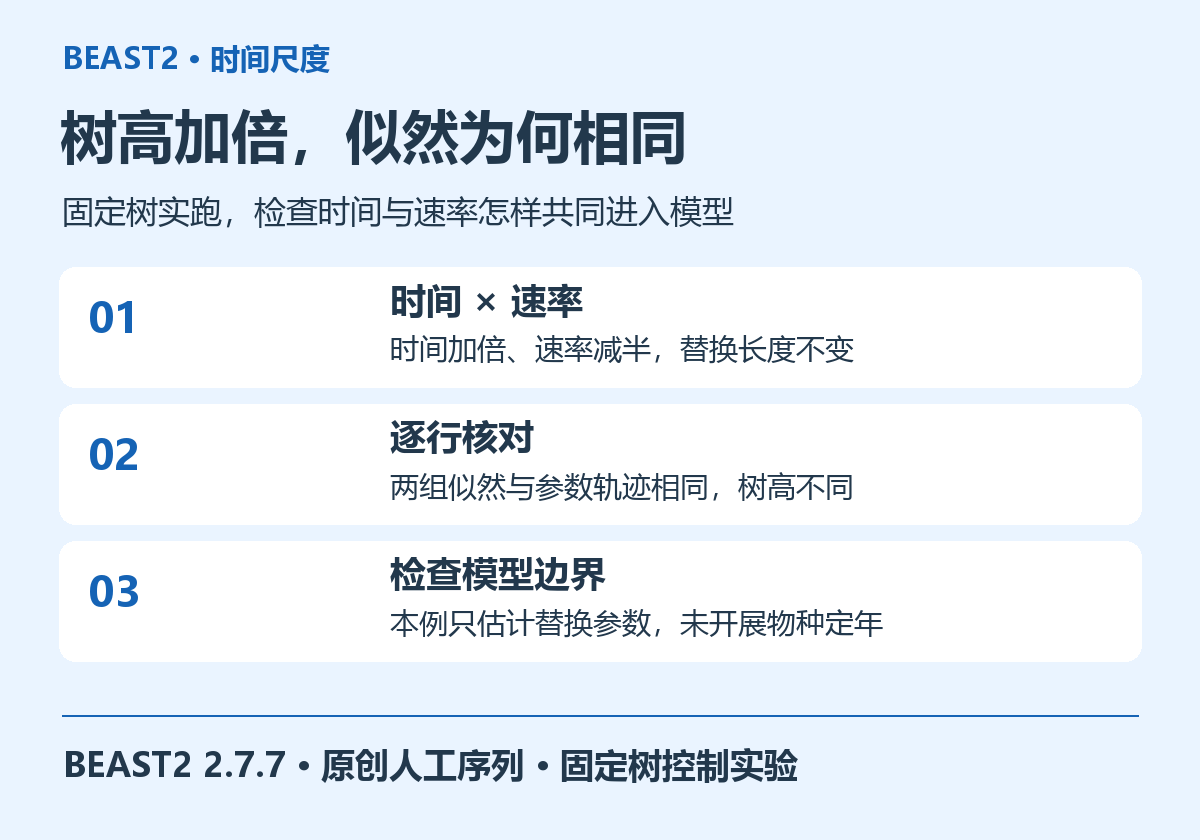
本文实际运行 BEAST2 2.7.7,构造三个只有一个待估参数的小实验。其中两组把树上的所有时间长度加倍,同时把分子钟速率减半,输出的似然和参数采样轨迹逐项相同。这个结果能帮助理解,序列信息怎样约束变化量,以及为什么时间推断需要额外的尺度信息。
先分清时间长度和替换长度
在严格分子钟下,同一棵树的所有分支共享一个钟速率。序列替换模型实际使用的分支变化量,可以理解为该分支持续时间与速率的乘积。若速率单位是每位点每年,乘以年数后,得到每位点的预期替换次数。
因此,一个标成零点一的分支本身并没有完整含义。若时间用百万年,速率必须按每百万年来解释。把年龄从年改写为千年,却仍保留原来的速率数值,会改变模型所看到的替换量,而不是只改变图上的标尺。
BEAST2 官方介绍将时间尺度上的系统树推断列为其主要用途。它既支持不同分子钟,也支持通过模型扩展进行其他进化分析。本文选取严格钟和固定树,是为了隔离时间与速率的关系,并未开展真实物种的分歧时间估计。
严格钟的 XML 文档给出了平均钟速率输入。读者修改配置时,应同时找到树、钟和位点模型,而不是只搜索一个带有年龄含义的变量名。
输入是怎样生成的
练习脚本使用固定随机种子,生成四条各八百列的人工核酸序列。树结构将甲乙分为一组、丙丁分为另一组,所有分支的原始长度均为零点一。序列按简单等频替换过程生成,没有使用真实物种、采样日期或化石记录。
拟合时使用 HKY 模型,固定四种碱基频率各为四分之一,只让转换与颠换的相对交换率参数参与采样。这个参数采用对数正态先验,对数尺度的位置为零、标准差为一。树拓扑、节点高度以及钟速率都被固定。
这种设置刻意缩小了问题。程序确实执行了马尔可夫链采样,但没有搜索树拓扑,也没有估计节点年龄的不确定性。将结果称为固定树上的参数控制实验,才与实际执行的内容相符。
三组使用同一输入、同一随机种子、同一操作器和一万代运行长度,每五十代记录一次。为了让结果容易核对,使用纯 Java 似然计算,不引入本地加速库的选择差异。
| 实验 | 每条时间分支 | 严格钟速率 | 根到叶时间 | 每条替换长度 |
|---|---|---|---|---|
| 基准 | 0.1 | 1 | 0.2 | 0.1 |
| 等价尺度 | 0.2 | 0.5 | 0.4 | 0.1 |
| 速率加倍 | 0.1 | 2 | 0.2 | 0.2 |
安装成功要靠实际输出确认
本次通过固定摘要的公开容器安装程序。最开始直接运行镜像中的启动脚本,出现找不到主类的报错,进程退出码却为零。如果只检查退出码,或者只记录容器能够启动,就会把失败误判成安装成功。
排查后发现,这个镜像把主程序和基础包放在不同的库目录。显式把两个目录加入 Java 类路径,并设置可写的用户目录后,启动器才正确加载主程序。版本输出同时列出主程序、应用包和基础包,三者均为本次使用的版本。
下面给出本次镜像内使用的启动方式。路径属于这个已固定的镜像,不应原样套用到其他安装布局。完整驱动脚本已经包含对应处理。
JAVA=/usr/local/opt/beast2-2.7.7-0/jre/bin/java
CP='/usr/local/opt/beast2-2.7.7-0/lib/*:/usr/local/opt/beast2-2.7.7-0/lib/packages/*'
"$JAVA" -Xmx2g -Duser.home=/tmp -cp "$CP" \
  beast.pkgmgmt.launcher.BeastLauncher \
  -java -seed 210 -threads 1 -overwrite base.xml
安装后的验收还包括日志是否生成、最后代数是否达到目标、样本列是否完整,以及日志中实际使用了哪些模型。本次输出明确记录四个分类单元、八百个位点和一百一十二种位点模式。模式数量小于列数,是重复列型被合并计算,不能据此认定丢失了序列。
XML 中真正连接模型的是引用关系
初看配置文件时,大量标签很容易让人把它当成一张参数表。实际上,文件描述了对象之间的关系。数据进入树似然,树似然同时引用树、位点模型和分支速率模型,参数则通过这些对象影响最终计算。
阅读时可以先从后验分布往下追。找到先验部分与似然部分,再看似然引用的比对、树和替换模型,最后核对哪些参数被加入状态、哪些操作器负责改变它们。这比逐行背标签更容易发现遗漏。
<branchRateModel
  spec="beast.base.evolution.branchratemodel.StrictClockModel"
  clock.rate="0.5"/>
在本例中,这段配置只固定钟速率。它没有声明一个待估的钟参数,也没有给钟添加先验。若读者希望估计速率,就必须把相应参数及其状态、先验和采样操作一起检查,不能认为写下一个数值后程序会自动决定估计方式。
同样,文件里出现树对象,不代表树一定在变化。本次没有给树添加采样操作,目的就是让三组对照只有预定差异。真实分析中,误把需要估计的对象固定下来,可能得到看似平稳但回答了另一个问题的结果。
两组轨迹相同,具体相同到什么程度
三组各写出二百零一条记录,包含第零代与第一万代。我们逐行对齐基准组与等价尺度组,比较后验、先验、似然和待估参数。四列最大绝对差都为零,树高列则从零点二变成零点四。
这不是只看最终一行碰巧相近。整条已保存轨迹都相同,说明在这次固定树和固定钟的设置下,两组给采样器的目标分布相同。相同种子和相同提议过程因此得到相同的接受与拒绝路径。
这里的后验相同还有一个重要前提。我们只给待估的替换参数设置了先验,没有给时间或钟速率设置额外的概率项。实际时间推断一旦包含年龄校准、树先验或速率先验,整体后验未必对这样的尺度变换保持不变。
换句话说,本例证明的是序列似然与特定小模型的尺度关系,不能推导出所有时间树分析都存在完全相同的后验。读者应该明确,究竟是似然不变,还是包括全部先验后的目标函数也不变。
第三组保留原来的时间长度,只把速率加倍。它的第一条已保存似然约为负二千九百九十一点八二,基准组约为负二千九百零八点七四。这组对照说明,单独改变速率确实改变了序列模型,而不是任何尺度调整都会被程序忽略。
为什么不能从这里直接得到年份
序列可以提供替换差异的信息,但当时间和速率同时自由变化时,仅有乘积约束往往不足以单独确定两者。要把树放到具体时间尺度上,需要检查数据或模型中究竟有哪些信息在固定尺度。
这类信息可能来自有时间跨度的采样日期、外部年龄校准,或者有依据的速率知识。它们不是可以随便填入的格式字段。日期跨度是否足以提供时间信号、校准对象是否对应正确节点,都需要针对研究问题审查。
尤其应区分物种名称、单系群约束和校准节点。指定一组名称,并不能自动保证校准被施加到自己心中想象的祖先。应检查配置中的分类单元集合、单系性设置,以及最终树上对应节点。
对校准分布也不能只保留一个“中心值”。偏移量、分布形状和支持范围共同决定模型允许的年龄。两个同样写着某个代表年龄的设置,可能表达不同的不确定性,从而影响后验。
本次没有加入这些信息,因此树高的零点二和零点四都只是控制实验中的数值。将它们标成百万年,或者据此讨论真实物种何时分化,都会超出实验能够支持的范围。
时间单位可以怎样逐项核对
实际整理分析方案时,可以先写一张单位表,将采样时间、校准年龄、树高和钟速率各占一行。前三者应使用一致的时间尺度,速率中的时间分母则应与它们对应。不要只在图注里记录单位,而把配置中的单位关系留给读者猜测。
例如,每位点每年百万分之一的速率,乘以二十万年,得到零点二的替换长度。若时间改为以千年计,这段时间是二百,速率就应变为每位点每千年千分之一,两者乘积仍为零点二。这个简单乘法可以作为配置审查时的手工检查。
如果模型还包含年龄分布或速率分布,换单位时必须检查整套分布的表达。直接在实数尺度上定义的中心和宽度,需要按相应尺度换算。对数尺度上的参数则有自己的转换关系,不能把所有数字机械地乘同一个倍数。
同时区分单位转换与科学假设改变。把同一时间从年表示为千年,目标是保持模型含义一致。把某个校准年龄改成原来的两倍,却不改变其他信息,属于修改研究假设,需要单独开展敏感性比较并解释依据。
从日志走到可交付结果,还缺哪些检查
二百零一条记录只是保存的状态数,不能直接当成二百零一个独立样本。相邻采样通常相关,保存间隔也不会自动消除相关性。正式分析仍需检查有效样本量、轨迹形态和独立运行之间的一致性。
还应区分日志中的模型量。似然反映观测数据在模型参数下的概率,先验反映参数分布,后验记录相应组合。不同输出位置可能使用简略标签,最好依据参数日志的列名和配置对象核对,避免把整体目标值误认成纯似然。
若一个模型的轨迹长期不动,应先确认对象是否真的参与采样,再检查提议是否几乎全部被拒绝。盲目增加运行代数,不能修复遗漏操作器、固定参数或错误引用关系。
如果使用多个扩展包,应同时保存包版本。主程序版本相同,不代表模型实现完全相同。复现材料至少应包含原始输入、实际运行的配置、完整版本记录、随机种子和输出,而不只是最后展示的树图。
怎样复现并进一步练习
下载本组实跑脚本与结果后,在具备 Python 3、Docker 和镜像下载条件的 Linux 环境中执行以下命令。脚本会生成原创输入、配置文件和原生日志,镜像摘要已经固定。
python3 210-beast2/run.py /tmp/beast2-scale-demo
每次使用新的工作目录,便于区分不同设置。先核对三组样本数与最后代数,再比较基准组和等价组的似然列,最后检查树高是否确实不同。这个顺序同时验证程序执行、对照成立和结果解释。
进一步学习时,可以另建实验加入有明确含义的校准或速率先验,观察哪些概率项发生变化。不过那已经是另一个模型,应保存新的配置并重新审查其科学依据,不能把它当作给原图补上时间单位的简单步骤。
BEAST2 的优势是可以把时间、速率、树和其他过程放进明确的概率模型中,局限则是模型越丰富,越需要认真核对可识别性和采样质量。这次实跑提供了一个直接的排错办法,先用可计算的小对照弄清对象之间的关系,再扩展到需要回答的研究问题。
当后续需要并行开展独立链、校准敏感性比较和较大数据集分析时,可结合实际流程了解云生信生物分析服务器服务。


