11月19日,Illumina宣布旗下 BioInsight AI Lab 赢得 Arc Institute 的2026 Virtual Cell Challenge,并在同日公开 CellularAI 的代码仓库。对研究者来说,开源让方法审查和独立使用向前迈了一步;但一个最容易被新闻标题带过的问题仍然存在:现在 clone 这个仓库,能不能复现冠军在挑战赛的0.4399成绩?
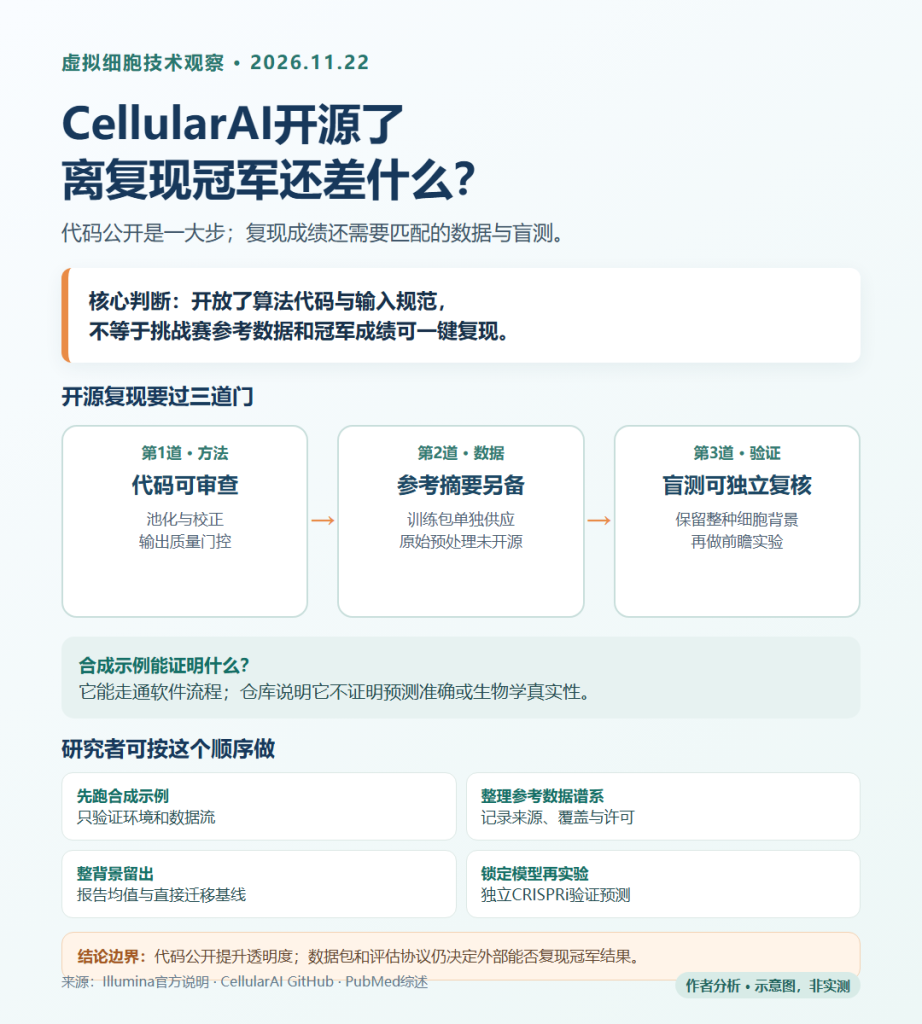
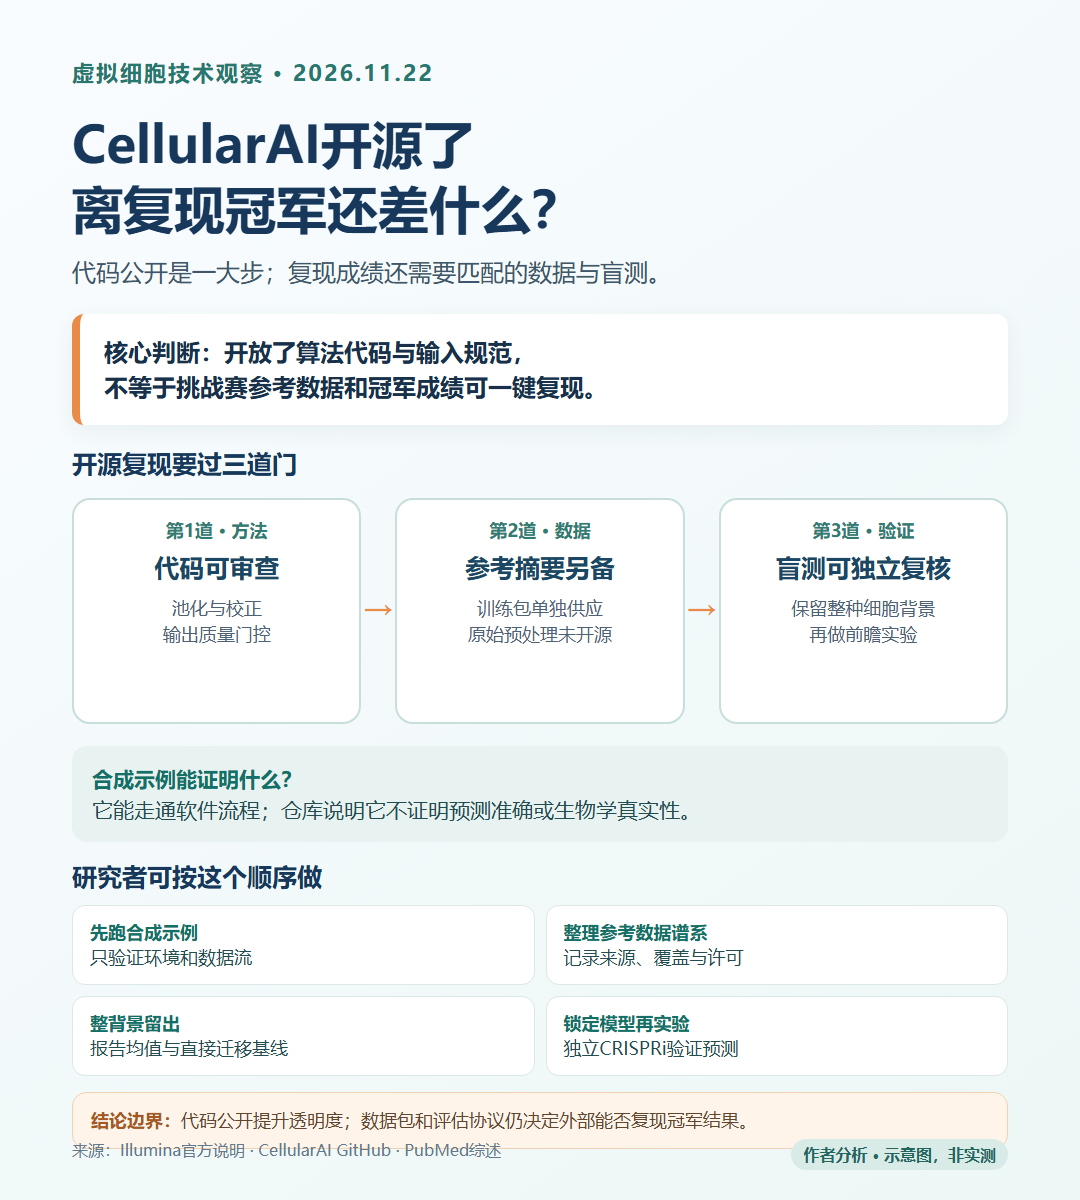
我的判断是:能读代码、能检查算法流程,不等于能原样复现榜单结果。目前公开的更像可运行的分析框架和输入规范;复现所需的扰动参考数据包并未随源码公开,原始数据到摘要表的完整预处理也不在仓库中。公开的合成示例能验证管线是否按预期运行,却不能验证生物学预测能力。这个区别不削弱开源的价值,反而告诉我们下一步应把“开源”拆成可审计的代码、可获得的数据和可独立验证的成绩三层。
这次开放的核心,是可检查的迁移算法
Illumina的官方介绍称,挑战赛版本的 CellularAI 没有从随机噪声中凭空生成一个细胞,而是从新细胞背景的未扰动对照出发,把每个基因的表达按预测幅度上调或下调;没有支持证据的基因则保持不变。它把不同参考细胞系里同一扰动的证据汇总起来,再依据参考与目标背景的相似度、敲低效率和测量噪声调整权重。官方复盘提到,比赛开始时团队已有约2亿个CRISPRi筛选细胞作为基础;这属于公司对其数据资产的报告,不是外部独立盘点。Illumina方法介绍
这是一种明确的建模取舍:保留真实对照细胞的单细胞差异,把估计出的扰动效应叠加上去;模型输出的虚拟细胞因此受参考实验和预测效应约束。它适合问“已有相似细胞中的敲低响应能否帮助预测新背景”,不应自动扩展成“任意细胞状态、药物剂量和组合干预都已可模拟”。Arc公布的挑战赛冠军综合分是0.4399,评分以背景均值为0、实验重复参照为1;这是比赛特定测试和指标下的结果,不能直接视为开源仓库在任意数据上的性能保证。Arc最终榜单与评分说明
Illumina还报告,它在H1、K562和HEK293三个已有真值的细胞背景上做过留出评估,并称完整算法相对跨细胞响应均值达到约2倍表现;这属于厂商自己的验证叙述。公司页面称细节方法论文计划于2027年初发布,因此目前不能把“2倍”当成已由独立团队复核的结论,也不能与Arc赛事的0.4399直接换算比较。Illumina方法介绍与评估说明
GitHub仓库公开了什么,哪些依赖仍要另行解决?
目前 GitHub 上的 Illumina/CellularAI 仓库列出 Apache 2.0 代码许可,并包含预测、验证、合并、评估代码,以及方法说明、配置和合成示例。README 写明,完整运行需要一个预先计算的训练摘要数据包、任务基因与扰动清单,以及目标背景的对照 .h5ad 文件;训练摘要包需要从单独的数据渠道取得。另一个关键边界是:仓库不包含从原始训练数据生成这些摘要表的预处理流程。CellularAI仓库与输入文件说明;输入数据文件契约
官方介绍把这一版描述为不包含 Billion Cell Atlas,也没有使用该 Atlas 训练;同时明确说,这套分析框架可以接入一个参考库,例如 Billion Cell Atlas。GitHub README则称方法使用从 Billion Cell Atlas 及公开 Perturb-seq 数据生成的预计算摘要表。两种表述可能分别谈的是开源代码包与获胜方法实际使用的参考数据,但目前页面没有逐项说明“哪一版本的配置对应哪一批摘要数据”,读者不宜自行把两句话合并成确定的版本关系。共同能确认的是:GitHub文档要求完整运行时另行取得训练摘要包,数据受单独访问控制和许可;仓库也没有从原始训练数据生成摘要表的预处理流程。公开的是可处理兼容参考摘要的算法框架,而不是把 Atlas 数据、原始处理链和竞赛完整训练包一起打包发布。你可以用自己构建的兼容参考库研究方法,但能否复现原榜单,还取决于摘要库版本、扰动数据覆盖和挑战赛模型配置是否相同。这处版本和数据对应关系,正是未来方法论文值得讲清楚的复现信息。Illumina开源说明;GitHub数据与许可说明
仓库还附有一个自包含的合成数据示例:运行时生成虚构的30个基因、3个扰动和少量细胞,走通池化与预测流程。文档自己划定了边界:它检查数据流和输出结构,不代表预测准确度或生物学真实性。对软件工程而言,这是有用的冒烟检查;对科研结论而言,它不是复现挑战赛的实验。仓库合成示例说明
手机阅读可左右滑动查看完整表格。
| 开源层次 | 现在可核对的内容 | 尚缺的复现条件 | 适合得出的结论 |
|---|---|---|---|
| 算法代码 | 池化、背景相似度权重、残差修正、虚拟细胞合成和质量门控;Apache 2.0代码许可 | 不能仅从代码推断本地数据能达到挑战赛分数 | 方法流程可检查、可改造 |
| 可运行示例 | 虚构数据可走通管线,输出结构与质量检查可验证 | 没有真实扰动测量,不能评估预测或生物学合理性 | 软件安装与输入接口可初步验证 |
| 参考数据 | 输入格式、摘要表字段、检查和校验和机制有文档 | 完整摘要包单独供应/受控;原始测量到摘要表的处理不在源码中 | 需说明数据来源、许可和预处理才能比较结果 |
| 挑战赛复现 | GitHub将该方法标为获胜方法;Arc公开了最终榜单与评估定义 | 原始竞赛参考资料、确切配置/版本及每一处理环节未必都公开可得 | 获奖事实有赛事方依据,独立复现仍需额外材料 |
| 新背景验证 | 可使用自己的对照数据和扰动参考开展预测 | 需要预先保留背景与扰动真值,再做独立实验 | 才能检验新课题情境下的可迁移性 |
新近综述提醒:不能把“留出”都叫作同一种泛化
11月20日,PubMed 收录了 Zuo 等人在 ACS Synthetic Biology 发表的叙述性综述《Virtual Knockout in the Era of Generative AI》。它把“虚拟敲除”的评估问题拆成多个留出层级:未见基因、未见细胞类型或背景、未见扰动组合、未见化学结构、未见剂量;并区分表示层面的 ablation 和因果遗传干预。论文把带不确定性、受约束的干预条件输出与前瞻性验证,作为未来虚拟细胞应达到的标准,而没有声称这些标准已经普遍实现。PubMed记录与摘要
这是一篇综述,不是新的 Perturb-seq 实验,也没有独立测评 CellularAI。它对这次代码开放的贡献是提供一张检查表:如果团队只留出了一个细胞系,不能顺势声称对未见药物、组合、剂量也能泛化;如果模型只输出转录本预测,也不能把它描述成已经预测细胞功能或组织空间行为。开源仓库定义的输入是扰动参考摘要、目标对照细胞和目标列表,输出是表达计数矩阵;其公开契约并不等于包含药物剂量、空间位置和表型读出的全模态虚拟细胞。
我怎么看这次开放:透明度开始增加,但复现的主战场是数据
在我看来,CellularAI 这次开源的最实质增量,不是“冠军模型终于可以一键复刻”,而是让更多团队能够审阅一种有解释路径的迁移方案:哪些参考数据进入汇总、按什么权重借用、如何校正目标背景,以及在哪些质量门控条件下输出会被拒绝。和只有分数或产品演示相比,这增加了可质询、可修改的层次。
但研究判断能不能被外部独立检验,决定因素很可能从“代码看没看见”转向“输入能否追溯”。同一个程序如果使用不同的参考数据覆盖、摘要生成规则、目标细胞相似度计算和预处理版本,得到的差异可能来自数据而不是算法。仓库对包内容和校验和的要求是一个可审计起点;要走到结论可复核,还需要公开兼容数据包或可用公开数据重建的处理脚本,并把挑战配置、版本、随机种子、排除项和评价指标固定下来。
这里也有一个可能推翻我判断的结果:如果研究者仅用公开可得的 Perturb-seq 汇总数据,严格按仓库说明运行,就能在预先锁定的多个保留细胞背景上持续超过简单的跨背景直接转移基线,且对显著基因集合、方向和表达误差都有一致改善,那么“开源已经形成可独立验证的迁移方法”会获得更强支持。反之,若只有合成例子能运行,或性能提升集中在最相似的来源细胞和个别指标,开源虽然提升透明度,科学适用边界仍然很窄。
一个可执行的复现与验证顺序
对准备使用这套方法的课题组,我建议按四步走。第一,先跑仓库合成示例,确认 Python 环境、输入轴和输出格式都正确;明确这一步只验管线,不评价模型。第二,写下手中参考库的每个数据来源、扰动技术、细胞背景、基因覆盖、摘要生成方法与许可证;把相互重复或高度相关的数据作为同一证据簇处理。第三,以“整种细胞背景”为单位留出,而不是把同一背景的细胞随机拆成训练和测试;同时留出一组目标扰动,报告均值预测、未经校准的参考搬运以及 CellularAI 完整流程,按背景和指标分层呈现结果。第四,在计算评估之后,预先选定一批未用来调参的靶标和新背景,锁定模型版本,再做 CRISPRi 实验确认敲低效率、独立重复和预测方向。
我的结论是:开源代码让 CellularAI 从“只听公司讲方法”进入“可以审查与改造”的阶段,但离复现冠军分数,还隔着数据包、预处理来源和匹配评估协议。把这些层次说清楚,才既能肯定开放的价值,也不把一段可运行代码误当成一份已经独立验证的虚拟细胞。
参考资料
- Illumina BioInsight AI Lab. Introducing the CellularAI algorithm: Predicting single-cell responses to genetic perturbations. 2026-11-19.
- Illumina. CellularAI source repository, README, method guide, input-file contracts and license. 检索日期:2026-11-22.
- Arc Institute. Virtual Cell Challenge 2026: Winners and Wrap-Up. 2026-11-19.
- Zuo Z, et al. Virtual Knockout in the Era of Generative AI: From Intracellular Networks to Spatial and Cross-Modal Functional Simulations. ACS Synth Biol. 2026;15(11):4405–4422. PMID: 43061985; DOI: 10.1021/acssynbio.6c00191. PubMed. 综述,非新实验。