
训练日志每轮都在更新,损失持续下降,潜在空间里也出现了不同区域,这些现象很容易让人相信模型已经学到了可靠构象。然而,训练程序首先是在优化给定输入的目标函数。输入图像与姿态没有正确对应时,程序可能照样运行,曲线也可能变得更好看。优化成功和科学解释成立之间,还有一段必须检查的距离。
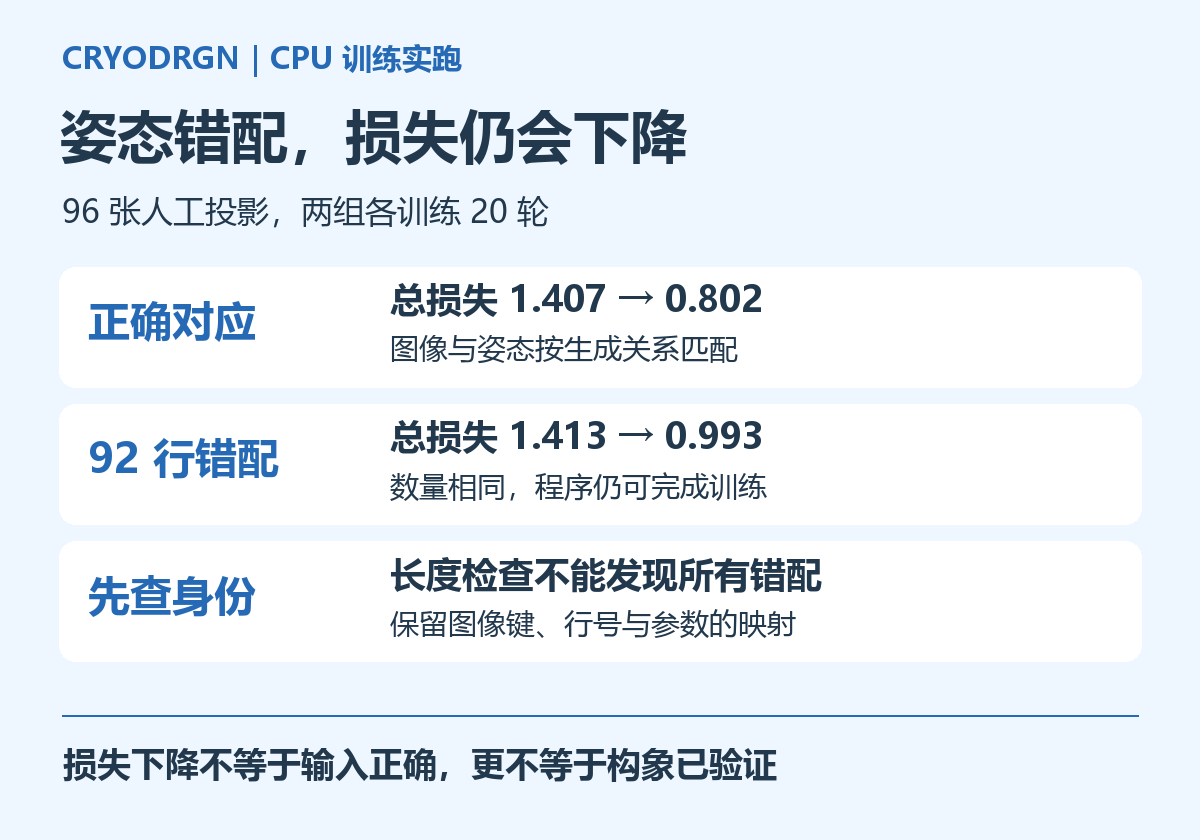
这次我们安装 cryoDRGN,真正执行了两组小规模训练。两组使用相同的九十六张人工投影图,区别是其中一组保持图像与姿态对应,另一组打乱姿态顺序。结果两组损失都下降,正确对应组的最终损失较低,但错误组并没有因为语义错配而自动停止。下面结合输入、命令和输出,说明读者应该怎样把这种风险挡在训练之前。
本文选择的是已知姿态训练路线
cryoDRGN 可以用神经网络表达随潜在变量变化的密度分布。本文运行的是给定颗粒姿态的变分自编码器训练,不是从头估计姿态,也不是电子断层子体分析。不同路线需要的输入和验证方式不同,不能因为都属于同一软件,就混用命令或把一种路线的参数解释套到另一种路线。
已知姿态路线的基本对应关系是,一张颗粒图像关联一组旋转和平移信息,真实实验数据还要正确提供相关成像参数。模型再学习颗粒表征与密度函数之间的关系。输入和输出的基本定义可以查官方用户指南。本次没有模拟对比度传递函数,因此不传入相应参数文件,这个处理只适用于当前人工案例。
我们没有把两个高斯团组成的玩具模型称为蛋白结构,也没有测量实验分辨率。人工输入的价值是所有生成条件都已知,可以人为制造一种明确错误,再观察程序是否发现它。它适合讲清验证方法,不能用来证明某个真实复合物存在几种状态。
安装时把基础依赖和实际执行后端记清楚
实测版本为 cryoDRGN 4.3.1,运行于 Ubuntu 22.04.5、Python 3.10.22,使用 CPU 版 PyTorch 2.13.0 和 NumPy 2.2.6。本次先有一个配置好的基础环境,再创建继承基础包的虚拟环境安装工具。下面命令要求当前 Python 已能导入所需 CPU 依赖,并不是在任意系统上执行两行就自动完成全部配置。
python -m venv --system-site-packages cryodrgn-env
cryodrgn-env/bin/python -m pip install cryodrgn==4.3.1
cryodrgn-env/bin/cryodrgn --version
继承基础环境可以复用已有依赖,但复现记录必须包括基础包,不能只保存新虚拟环境里新增的包名。我们同时保存了完整版本清单。读者若采用全新环境,应按照官方安装说明配置适合自己的依赖,再核对当前命令帮助。
日志明确显示没有使用 CUDA。本次网络小、图像少,CPU 可以完成教学实验,这不意味着真实大规模训练适合照搬同样设置。文章不提供外推速度,也不把短任务的运行时间当成硬件比较。是否需要更大模型和更长训练,应由数据和验证目标决定。
人工输入怎样建立,哪些信息没有包含
我们用两个球形高斯团表示一个简单三维密度。其中一个团固定,另一个团在两种状态下处于不同位置,改变两团间距。每种状态生成四十八个随机方向投影,再加入少量独立噪声,共九十六张三十二乘三十二像素图像。像素尺寸设为二埃,所有投影由解析公式计算,不涉及真实显微镜采集。
旋转矩阵由固定随机种子生成,投影中心按相同矩阵变换。保存图像时,同时保存其对应矩阵和生成标签。平移全部设为零,避免把平移单位换算与本次姿态顺序问题混在一起。正式数据通常复杂得多,因此不能因为本例使用零平移,就认为真实输入可以忽略中心位置。
这套数据没有束流损伤、冰背景、真实成像传递、错误挑选或连续构象路径。两个生成状态只是用于制造可追溯输入,也没有在本文中作为分类准确率的标准答案。我们的主要问题是,输入对应关系出错时,训练曲线能否独自充当报警器,而不是让模型赢得一个过于简单的准确率数字。
一项值得学习的做法是把图像身份保存为独立清单。即使当前数据只有九十六张,也应知道每一行从哪里来。真实流程中经过颗粒筛选、文件拼接和排序后,行号很容易变化。清单应连接原始图像键、最终行号和相关参数,而不只是记住“这三个文件当时一起复制过”。
先做程序能够发现的错误
第一项反例只提供九十五组姿态,但仍输入九十六张图像。实际程序拒绝运行,报错指出姿态旋转数量与图像数量不一致。这个检查很有用,它阻止了明显的长度错误继续进入训练,也说明文件能够读取,并不意味着内容符合任务要求。
但数量一致只是必要条件。我们随后保留九十六组矩阵,只改变顺序。矩阵形状仍然正确,每个矩阵也来自合法旋转,因此结构性检查没有理由拒绝。实际置换中九十二行发生改变,四行恰好保留原位置。我们把这个数量记录下来,没有笼统写成所有行都被交换。
| 输入版本 | 图像与姿态数量 | 实际程序行为 |
|---|---|---|
| 少一组姿态 | 96 张图,95 组矩阵 | 明确报错并退出 |
| 正确对应 | 96 张图,96 组矩阵 | 完成训练 |
| 打乱顺序 | 数量仍为 96,92 行错配 | 同样完成训练 |
这里的差别是格式约束与语义关系的差别。工具可以检查数组有没有预期形状,却不能仅凭一个无身份说明的矩阵数组,知道它原本应该属于哪张图。要发现这种错配,需要来源映射、联合筛选和转换前后的身份核对,不能指望优化器替研究者恢复数据管理历史。
两组训练只改变姿态对应关系
两组都使用二维潜在变量,编码器和解码器各两层、每层六十四个单元,批次大小十六,训练二十轮,固定训练与打乱批次的随机种子。这里的二维指表征向量有两个分量,不是指定模型输出两个类别。把潜在维度当成状态数量,是另一种常见误读。
cryodrgn train_vae particles.mrcs -o correct \
  --zdim 2 --poses correct.pkl -n 20 -b 16 \
  --enc-layers 2 --enc-dim 64 \
  --dec-layers 2 --dec-dim 64 \
  --seed 20261118 --shuffle-seed 42 \
  --no-amp --no-analysis --uninvert-data --no-window \
  --max-threads 2 --checkpoint 20 --log-interval 96
第二组将姿态文件和输出目录换成打乱版本,其余参数相同。关闭自动分析,是为了先检查训练和输出文件,不把额外降维、聚类和体图采样混到这项对照里。没有执行自动分析不等于模型没有训练,反过来,生成了分析图也不等于已经完成结构验证。
人工图像采用正密度投影,所以本例明确不反转数据符号,也关闭了实空间加窗。这些是为了让当前输入处理方式可控,不是对实验数据的通用建议。真实颗粒应核对对比度方向、边缘污染和预处理历史,不能把本例的便利设置直接复制过去。
实际损失下降,但错误没有消失
两组训练均正常完成二十轮。正确对应组的总损失从约一点四零七降到零点八零二,打乱组从约一点四一三降到零点九九三。错误组也明显下降,因此“损失下降”不能单独证明图像与姿态正确对应。这是此次实跑直接支持的结论。
| 本次训练 | 第 1 轮总损失 | 第 20 轮总损失 | 第 20 轮生成项 |
|---|---|---|---|
| 正确对应 | 1.407017 | 0.801560 | 0.799180 |
| 姿态打乱 | 1.413406 | 0.993221 | 0.990071 |
正确组最终损失较低,说明在本例条件下,两套输入对应关系对优化结果产生了差异。但这个差值不是通用阈值。我们没有运行多个随机种子来估计差值分布,也没有在真实数据上校准报警规则,因此不能告诉读者“高于某个数就一定姿态错误”。
训练目标还包含生成项和潜在分布相关项,总损失并不是这两列不加处理地直接相加。改变潜在维度、正则化安排、图像尺寸或归一化方式后,数值尺度可能变化。不同实验比较损失时,必须先确认目标函数和预处理具有可比性,不能把最低的那个数字自动当作最佳结构。
有潜在向量和体图,仍然需要解释链
实际输出中,两组都有九十六行、两列的潜在表征,以及网络权重和配置文件。我们在正确组的潜在均值位置,以及距离均值最远的一个已观测颗粒位置,调用体图解码。程序成功生成两个三十二立方网格体,头信息中的像素尺寸为二埃,所有体素均为有限数。
这项核验说明权重、配置和潜在坐标可以一起完成解码,并没有证明两个体图对应两个真实状态。潜在均值也未必对应数据密集区域,极端颗粒更可能受到噪声或异常输入影响。选择解码坐标时,应说明为何选择它,而不是挑两张差别最大的图就宣布发现结构变化。
cryodrgn eval_vol correct/weights.pkl \
  -c correct/config.yaml -o decoded \
  --zfile decode-z.txt --Apix 2
对真实数据,需要把潜在区域连接回成员颗粒,检查成像条件、方向分布和异常图像,再比较相应密度。潜在图中的分离可能包含结构变化,也可能包含没有被模型正确解释的其他图像差异。官方提供的构象景观分析说明可以帮助组织后续分析,但它不能替代对输入来源的核验。
轨迹不是时间轴,漂亮聚类也不是机制证据
潜在空间中的一条连续路径,可以产生连续变化的体图,但其参数并不天然代表真实时间。沿路径出现的顺序,也不能直接解释为分子发生反应的先后顺序。若要提出动力学或机制结论,还需要独立实验或其他约束支持。
在两个区域之间直接插值,还可能穿过几乎没有颗粒支持的位置。此时解码器仍能给出数字,但输出与实际观测的联系变弱。更合理的探索要同时检查路径附近的数据支持程度,并说明选择路径的规则。可进一步参考官方图遍历方法,本文没有实际执行该分析。
同样,二维可视化会改变高维距离关系,图上的团块形状不应直接等同能量地形。看图之后,应回到原始潜在向量、颗粒成员和密度结果做交叉核验。任何一种漂亮展示都应该服务于可检查的问题,而不是代替问题本身。
将本次经验变成可复用流程
开始训练前,先检查图像、姿态和成像参数的数量,再检查它们是否通过同一身份清单联合排序与筛选。每次转换后保存映射,不依赖文件名相似来判断对应。对数量不匹配立即停止,对数量相同的情况继续抽查身份与物理含义,两个层次都不能省略。
训练后,先核对日志中的实际后端、参数和输入范围,再查看损失分项、潜在向量形状及解码输出。随后才开展多种子稳定性、颗粒子集比较和独立结构验证。这些后续检查在本文中属于建议,没有被包装成已经完成的实验。
cryoDRGN 的优势是能够表达连续的结构异质性,并把颗粒表征与密度生成连接起来。使用难点则是输入对应关系、成像模型和潜在解释都可能影响结论。此次对照给出的实用经验很具体,结构性报错值得重视,训练成功值得记录,但语义正确性必须另外证明。
下载脚本、运行说明与实际结果(ZIP)。选择 cryoDRGN 目录,按说明准备固定版本环境后运行脚本,将生成输入并执行训练和体图解码。工作目录须尚不存在,保留日志后再比较对应关系与损失。
当输入对应和验证方案已经明确,需要扩展训练规模或开展多轮对照时,可以了解云生信生物信息学分析服务器服务,按具体流程安排计算环境。


