
两条分析分支都挑出了好颗粒,把它们合并后继续精修,是很常见的操作。真正容易出错的地方却不是点击合并按钮,而是没有先定义“同一颗粒”意味着什么。两个记录编号相同,是否沿用同一份离焦参数。两个编号不同,是否其实指向同一张图像。合并后颗粒更多,是否只是重复计算了同一批数据。
本文围绕这些问题做一个可复现的小实验。实际安装运行的是独立开源 Python 库 CryoSPARC Tools 的本地 Dataset 接口,版本为 5.1.0。我们生成小型元数据集合,保存、读取、合并并检查冲突,没有安装或运行 CryoSPARC 主程序,没有执行二维分类、精修或三维重构,也没有连接在线任务。区分这个范围,才能准确理解下文数字能说明什么。
颗粒既有身份,也有处理历史
一条颗粒记录通常不只有身份编号,还会携带图像位置、成像参数、对齐结果以及其他字段。同一个颗粒经过不同处理分支,身份可以保持相同,但某些字段会改变。因此,“取相同颗粒”只回答保留哪些记录,没有自动回答保留哪个分支的元数据。
本次把这两个问题故意拆开。集合甲有六个编号,集合乙有五个编号,其中三个重复。我们为重复编号设置不同的人工离焦值,方便观察合并后到底使用了哪一边。数值只是作者设计的标记,不是显微镜测量值,也没有经过任何对比度传递函数拟合。
如果没有这种冲突样例,一个接口即使选择了你不希望保留的字段,测试也可能看不出问题。因为两边数值恰好相同,任何覆盖规则都会得到相同结果。处理真实项目之前,用几个有意不同的小记录检查接口行为,往往比直接跑全量数据更容易发现逻辑错误。
安装独立工具库,不等于运行主程序
CryoSPARC Tools 提供读写数据集、访问项目和编排任务等接口。本文只使用本地文件和数组操作,不需要连接实例。有关库的用途和环境安排,可查Tools 入门文档。工具库采用独立的 BSD 许可,主程序的使用条件应另查官方许可说明,两者不能混为一谈。
实测使用 Ubuntu 22.04.5、Python 3.10.22 和 NumPy 2.2.6。我们用单独的虚拟环境安装固定版本,完成后保留依赖清单。独立环境的意义是让导入行为和依赖版本可以追踪,而不是因为几行数据处理需要复杂部署。
python3.10 -m venv cryo-tools-env
cryo-tools-env/bin/python -m pip install cryosparc-tools==5.1.0
cryo-tools-env/bin/python -m pip freeze
后面如要把脚本接到真实项目,仍需检查工具库与主程序的兼容要求,并确认项目身份、结果类型和字段组。本文的最小数据集只是本地接口练习,不具备提交重构任务所需的完整输入。能够写出一个扩展名正确的文件,并不意味着它已经是合格的下游任务输入。
建立一个能暴露冲突的最小数据集
集合甲的编号为一到六,集合乙为四到八。两边的图像路径相同,图像索引按编号减一填写。为了检查数据来源,我们让乙的人工离焦值比甲对应值增加一千埃。这样,观察编号四的输出值,就能判断覆盖来自哪一侧。
import numpy as np
from cryosparc.dataset import Dataset

def make(ids, offset):
    ids = np.asarray(ids, dtype=np.uint64)
    return Dataset({
        "uid": ids,
        "blob/path": np.array(
            ["synthetic/particles.mrcs"] * len(ids), dtype=object),
        "blob/idx": (ids - 1).astype(np.uint32),
        "ctf/df1_A": (10000 + offset + ids * 10).astype(np.float32)
    })

a = make(range(1, 7), 0)
b = make(range(4, 9), 1000)
这里的路径只是人工字符串,实验没有创建或打开颗粒图像。因此,后文的“图像键相同”仅指路径与索引相同,不是通过读取像素证明两张实验图完全相同。读者如果把它迁移到真实数据,必须进一步检查文件是否存在、索引是否合法以及文件有没有被替换。
这个例子也提醒我们,字段名称看起来像正式科学数据,并不会让人工数字自动变成测量结果。编写测试时应给结果文件加上明显的人工数据标记,并与正式数据分开保存。否则,一个用于验证流程的文件,很容易在多次复制后失去来历。
并集的成员相同,元数据却可能不同
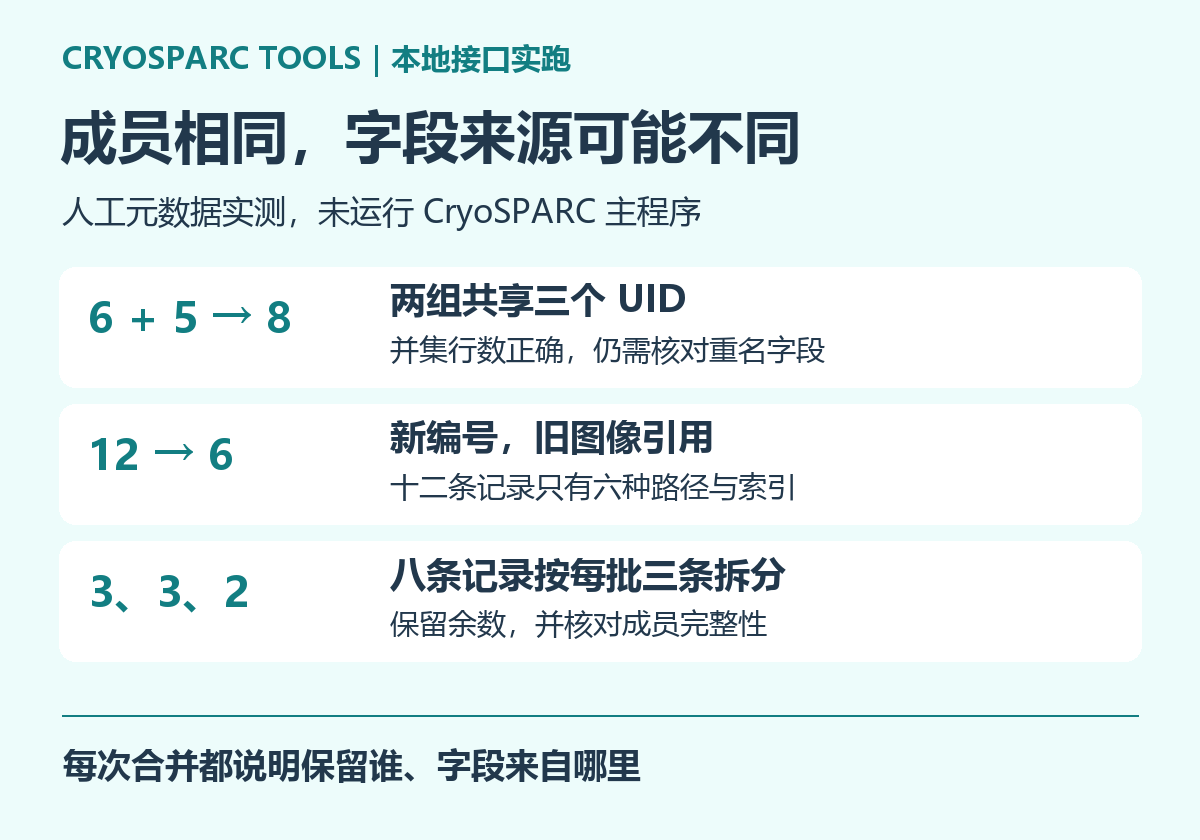
实际调用并集时,甲乙合并后得到八条记录,符合六加五减三个重叠的计数关系。将顺序反过来,仍然是八个编号。但在本次版本和输入中,甲在前时,重复编号四的离焦值为一万零四十埃。乙在前时,对应值变为一万一千零四十埃。
这两个输出在成员集合意义上相同,在记录内容上却不同。如果只检查总颗粒数和编号是否齐全,就会误以为结果完全等价。对于处理过参数更新的分析分支,这种差异足以影响后续解释。不能因为一次运算被称为并集,就假定所有附带字段也满足交换顺序不变。
| 本次操作 | 结果行数 | 编号四的人工离焦值 |
|---|---|---|
| 甲在前的并集 | 8 | 10040 Å |
| 乙在前的并集 | 8 | 11040 Å |
| 从甲取共同编号 | 3 | 10040 Å |
| 从乙取共同编号 | 3 | 11040 Å |
| 甲连接乙的字段 | 3 | 11040 Å |
最后一行尤其值得注意。实际运行字段内连接时,本次重名字段采用了乙中的值。它与甲在前的并集表现不同。因此,不要凭函数名称猜测覆盖顺序,也不要把一个操作观察到的规则推广给另一个操作。升级版本或更换数据布局后,保留这样的小型冲突实验,可以快速检查行为是否仍符合预期。
若任务的意图只是保留共同编号,并明确沿用甲的全部字段,直接对甲做成员掩码会更容易审阅。若需要乙的某些更新字段,就先明确字段清单,再进行连接,并核对变化范围。相关接口参数与默认行为见Dataset API。
common_from_a = a.mask(np.isin(a["uid"], b["uid"]))
common_from_b = b.mask(np.isin(b["uid"], a["uid"]))
merged = a.union(b, assert_same_fields=True)
joined = a.innerjoin(b)
在界面中取交集,也要看输出来自哪边
CryoSPARC 的 Particle Sets Tool 文档将共同颗粒和元数据来源分别说明。其交集输出可以分别沿用甲或乙的数据组,因此选择哪个输出连接到下游同样是分析决定。这个主程序行为是官方文档解读,没有在本文环境中运行对应界面任务。具体端口和条件应核对Particle Sets Tool 说明。
一个常见场景是,甲保存了较新的成像参数,乙经过了更严格的颗粒筛选。此时研究者真正想要的可能是“使用乙的成员,保留甲的参数”。如果把意图写成这句话,就能更清楚地安排连接顺序和字段来源。若只写“把两组取交集”,同事很可能执行了成员正确但元数据错误的操作。
实际交接时,可以为关键字段建立来源清单,说明图像、成像参数、对齐结果分别来自哪个任务。清单应跟着输出一起保存。只在聊天记录里解释一次,过几周再追查某个参数从哪里来,通常就会变得困难。
新编号不会让旧图像变成新证据
我们复制甲的六条记录,仅把身份编号改为一百零一到一百零六,路径和索引保持不变。然后将两份数据按编号取并集,实际得到十二条记录。再统计路径与索引组合,却只有六种。编号层面没有重复,图像引用层面存在一对一重复,这两个检查给出了不同答案。
这模拟了重复导入或外部转换后身份发生变化的一种风险。本文没有调用重新导入任务,而是直接构造了等价的身份变化情形。教训很明确,身份去重只对身份定义负责,无法自动识别所有物理重复。多出一倍的记录,并不意味着多出一倍独立信息。
路径与索引也不是万能标准。文件复制、移动或重排之后,同一图像可能具有不同路径,路径相同的文件也可能已经被覆盖。真实项目最好保存稳定的来源映射、文件摘要以及转换记录。对于同一张显微图上距离很近的颗粒,还需要空间位置核对,单纯比较图像堆栈路径无法解决这个问题。
官方 Remove Duplicate Particles 任务涉及位置和距离阈值,并可考虑对齐位移。阈值的物理单位与像素尺寸有关,不能把某个像素距离不加换算地当成埃。本文没有执行该任务,其适用条件应查重复颗粒处理说明。把“编号重复”“图像引用重复”“空间上重复挑选”分开讨论,比统称去重更准确。
默认行为可能静默减少字段
我们又从乙中移除人工离焦字段,再与甲合并。默认并集成功返回,却只保留两边共同拥有的字段,离焦列从结果中消失。改用严格字段检查后,操作实际报错。对正式分析来说,宁可在字段不一致时停下来解释,也不应在不知情的情况下把必需信息丢掉。
另外两个反例也实际触发了错误。默认追加操作拒绝重复编号,严格内连接检查则拒绝丢失甲中没有匹配项的记录。这些错误并非软件故障,而是在提示输入与当前操作契约不一致。直接关闭检查让脚本继续运行,只会把需要解释的问题推到更后面。
| 核对项目 | 本次观察 | 可迁移的做法 |
|---|---|---|
| 缺少字段 | 默认并集仅保留共同字段 | 重要流程启用严格字段检查 |
| 重复编号 | 默认追加拒绝 | 先明确追加还是去重合并 |
| 连接丢行 | 严格内连接拒绝 | 比较连接前后成员清单 |
| 分批余数 | 八条按三条分为 3、3、2 | 保留最后不足一批的数据 |
分批、保存和复核应当一起完成
还有一个经常发生在导出环节的问题,身份编号不是连续测量值,不应该为了计算方便随意转成浮点数。真实编号可能很大,经过电子表格或自动类型推断后,如果精度被截断,原本不同的身份可能显示成相同值。本例使用很小的编号只是为了阅读方便,不能据此推断任何表格软件都能无损保存正式编号。
与同事交换列表时,可以把身份按完整字符串输出,导入后再用明确的数据类型恢复,并检查唯一值数量。不要把科学计数法显示的缩略数字手工复制回来作为匹配键。比对差异时,也应区分数据真的不同与行顺序不同,先按身份建立对应关系,再检查相关字段,不能仅看两个文件逐行是否相等。
缺失值同样需要保留含义。某个分支没有某字段,和该字段测得数值为零,是两种完全不同的状态。为了凑齐表头直接补零,可能让下游误以为参数已经有效估计。更可靠的处理是明确标记缺失原因,判断任务是否允许缺失,再决定重新计算、排除或从可信分支补入,并把决定留在记录中。
八条记录每三条分一批,实际批次大小为三、三、二。这个看似简单的检查很重要,若只按整除次数循环,最后两条就会悄悄丢失。我们进一步检查所有批次的编号并集是否等于原集合,再保存数据文件、重新读入,并验证内容等价。行数正确、身份完整和文件可读是三个不同层次的检查。
任意把数据分成两份,也不等于建立了可靠的独立验证。如果同一物理图像通过不同身份落入两边,身份集合看似互斥,仍可能存在重复信息。本文没有运行半图重构或傅里叶相关验证,只指出上游数据身份会影响下游独立性的判断。分组之前先解决重复来源,比事后解释异常漂亮的指标更有效。
CryoSPARC 的工作流和 Tools 接口让颗粒集合处理很方便,这是明显优势。代价是数据组、身份和处理分支之间的关系需要认真维护。此次实测最实用的经验,是每次合并都同时回答三个问题,保留谁、字段来自哪里、是否增加了独立信息。把这三件事写进脚本和结果记录,后续精修才有清楚的数据基础。
下载脚本、运行说明与实际结果(ZIP)。选择 CryoSPARC Tools 目录,在独立环境安装固定版本后运行。脚本只处理人工元数据,不连接主程序实例,也不读取颗粒图像。
当颗粒集合与处理分支核验清楚后,若需要扩展批量分析,可以了解云生信生物信息学分析服务器服务,围绕已经明确的流程安排计算环境。


