
比对率不低,最后留下的有效接触却很少,这是 Hi-C 分析里很容易让人焦虑的情况。直接把它归因于建库失败,可能错过参考注释、筛选条件或版本行为的影响。有效接触不是“两个端都比对上”的同义词,它还经过片段归属、产物分类、距离过滤和去重。只有把接触数量沿着这条路径逐步核对,才知道损失发生在哪里。
本文实际运行 HiC-Pro 的酶切、接触分类、合并去重及原始矩阵构建模块。使用两条自编参考序列和十二对手工编写的比对记录,没有运行比对器,也没有执行矩阵的迭代校正。这样做的目的是隔离几类具体错误,不能据此评价真实文库质量、运行速度或工具整体准确率。
一、安装成功后,还要核实真正运行的版本
本次获取官方项目链接的容器,固定镜像摘要后运行,程序实际报告 HiC-Pro 3.0.0,内部使用 Python 3.7.6 和 bx-python 0.8.8。镜像的可移动标签不能替代程序版本号,尤其在复现旧项目时,不能看到标签写着最新,就默认里面的软件也是最新发布版本。
另一个实际遇到的问题是,主程序没有直接出现在默认命令搜索路径中。容器已经下载成功,但直接执行程序名仍报找不到命令。使用安装目录内的完整路径后才正常返回版本。遇到这类情况,先检查程序位置和环境变量,不必马上重新安装所有依赖。
IMAGE=nservant/hicpro@sha256:273eec78a98e32e994315b4e059a1cf27c9e9c9e97bfa8dfceef03c5640cf29d
docker pull "$IMAGE"
docker run --rm "$IMAGE" /HiC-Pro_3.0.0/bin/HiC-Pro -v
后面的数值都限定于这个固定环境。项目的总体能力与安装方式可以参考官方仓库,但本文使用的旧版容器不能被理解为对当前生产分析版本的推荐。完整输入生成器、调用记录和预期输出保存在实跑复现包。
二、酶切文件要和真正使用的参考序列一致
我们构造一条六千碱基和一条三千碱基的虚拟染色体,每隔一千碱基放置一个指定切割序列。调用工具后得到九个片段,每段一千碱基。这里的规则是我们人为设置的,真实基因组上的片段长度分布不会如此均匀。
python /HiC-Pro_3.0.0/bin/utils/digest_genome.py \
  -r '^GATC' -o fragments.bed toy.fa
切割位置用符号明确标出,不能只写识别序列而忽略切点。酶切片段区间与接头连接序列也不是同一个概念,前者用来给比对记录分配参考片段,后者涉及读段中连接位置的处理。混用两者会让参数看上去都很“像正确的序列”,实际却作用于不同步骤。工具的输入约定见官方辅助工具说明。
建立片段文件后,至少检查三个问题。染色体名称是否与比对头部一致,片段边界是否落在参考长度内,参考是否和创建比对索引时完全相同。仅检查文件扩展名无法发现这些问题,能够被程序读取的注释,也可能完全不能覆盖当前比对记录。
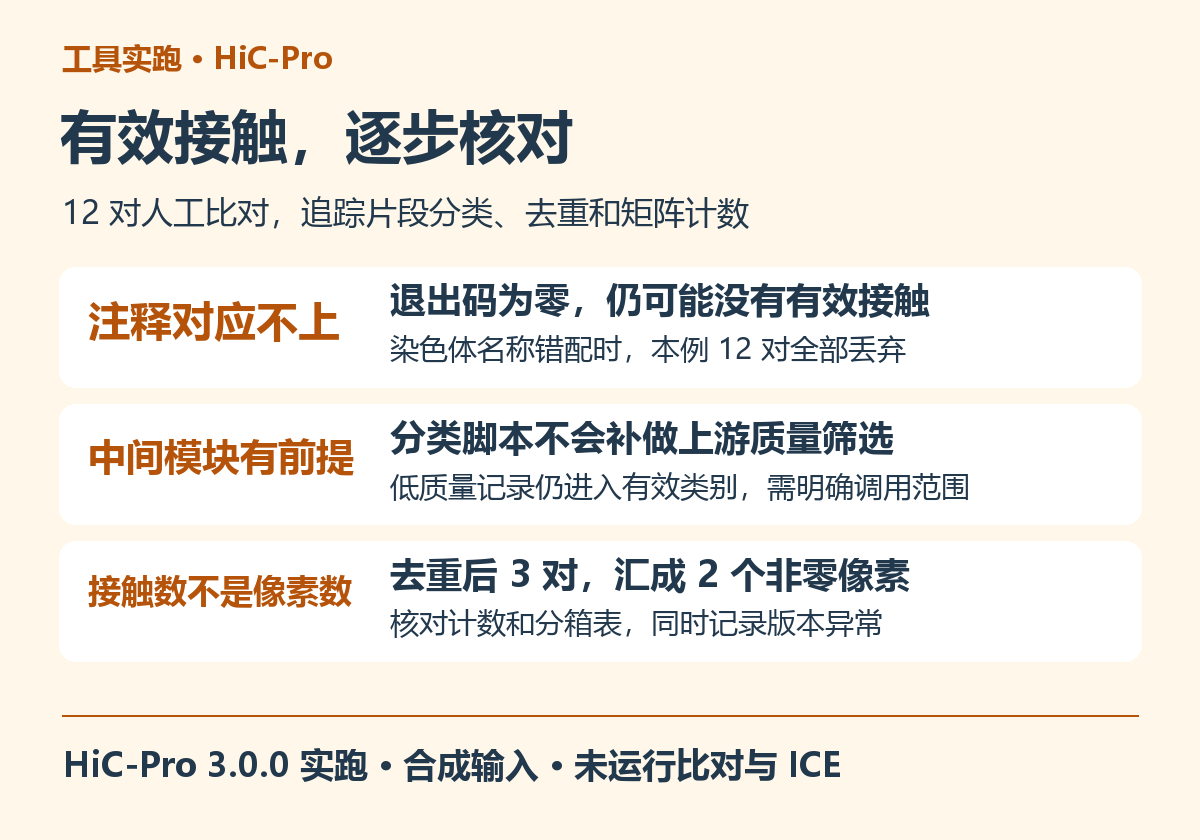
我们专门把注释中的染色体前缀去掉,保留其余坐标不变。程序退出码仍然为零,但十二对输入全部进入丢弃类别,有效接触为零,同时日志出现找不到限制性片段的提示。这个结果足以说明,任务正常退出不等于输入关系正确。遇到空矩阵时,先检查这些可验证的对应关系,比立即降低所有过滤阈值更有效。
三、片段归属的位置,不一定是最终输出的位置
本次分类程序通过读段比对中点寻找所属片段,而有效接触表报告的是读段五端坐标。两种坐标服务于不同目的,不能拿输出位置直接替代程序内部的片段查找位置。
我们设置了一条正向读段,五端位于第九百八十个碱基,长度五十碱基。它的零基比对起点是九百七十九,中点是第一千零四个零基位置,已经跨入第二个片段。另一端也落在第二片段,方向形成向内排列,于是被归入悬垂末端类别。如果只看九百八十这个输出坐标,会误以为第一端属于前一个片段,进而觉得分类矛盾。
这个例子还提醒我们区分坐标体系。片段区间使用零基、左闭右开表示,输出接触位置则使用一基坐标。对跨片段边界的记录,要同时列出原始比对起点、比对长度、方向、中点和输出五端位置。把这些量写在一行里,通常比反复看热图更容易发现问题。
对于包含复杂剪接或特殊比对操作的读段,还应检查实际比对表示。本文只有简单的连续五十碱基比对,没有覆盖所有复杂操作,因此不能把这里的手算方法不加区分地套到任何比对记录上。
四、先按具体读段核验,再看分类百分比
基础设置下,十二对输入的分类如下。这些数量来自实际输出文件和统计文件的交叉核对,每一对都能追溯到我们编写的输入记录。
| 输出类别 | 本次数量 | 核验要点 |
|---|---|---|
| 有效接触 | 4 | 其中含一对精确重复和一对低质量对照 |
| 悬垂末端 | 2 | 含跨边界但按中点落在同片段的例子 |
| 再连接 | 2 | 两对相邻片段,方向不同 |
| 自环 | 1 | 同片段向外排列 |
| 丢弃 | 3 | 同向同片段、全未比对及下文的版本对照 |
| 额外条件过滤 | 0 | 基础设置未增加距离和长度门槛 |
最容易被示意图误导的是再连接类别。本次版本对相邻片段作判断时,没有再要求两端必须呈现某个特定方向。因此,我们编写的相邻片段向内排列和同向排列,都进入再连接类别。分析时应以所运行版本的实际规则为准,不要把一张教材示意图当作代码中的全部条件。
另一对故意设置为低比对质量的记录仍进入有效接触。这里直接调用的是片段分类脚本,并没有经过完整流程前面的质量筛选。这不表示完整 HiC-Pro 流程没有质量控制,而是说明单独调用某个模块时,必须自己保证它所依赖的上游条件。把模块结果写成全流程结果,会掩盖这个关键前提。
五、一个值得保留的版本回归例子
实跑还发现了一个比预期更细的边界情况。我们把两个读段分别放在不同染色体上,但让它们所属片段具有完全相同的起止坐标。按生物学含义,这不是同一个片段。然而在本次安装的区间对象实现中,两个对象的相等比较返回真,片段名称不同也没有改变这个结果。
随后分类程序先进入“同片段”的判断分支。因为这对读段同向,最终落入丢弃类别。作为对照,仍然使用不同染色体,只把第二端移到起止坐标不同的片段,同向接触就正常进入有效类别。最小对象比较和完整分类结果均保存在复现输出中。
这个问题的范围必须说准确,它发生在本文固定的 HiC-Pro 3.0.0 与 bx-python 0.8.8 组合、特定片段坐标条件下。本文没有测量它在真实基因组中的发生比例,也没有验证所有其他版本,不能据此推断真实项目损失了多少接触。相关分类逻辑可对照项目源代码,运行结论则以复现包中的固定环境为准。
实际项目如果复用了同一环境,可以把这个人工例子作为升级前后的回归检查。不要通过修改真实片段坐标来“绕开”问题,那会改变数据本身。应核实目标版本的代码与依赖行为,重新比较分类结果,并保留版本变更记录。本文也没有偷偷修改软件后再把输出称为官方原始行为。
六、不同过滤条件,改变的是不同分母
加入最小染色体内距离三千碱基的条件后,有效接触从四对变成一对,三对染色体内有效接触转入额外过滤类别,染色体间那一对保留。悬垂末端、自环和再连接数量保持原值。这说明该距离条件是在特定类别上生效,并不是把所有近距离读段统一重新归类。
python /HiC-Pro_3.0.0/scripts/mapped_2hic_fragments.py \
  -f fragments.bed -r toy.bam -o mincis3000 \
  -a -d 3000
再把最小限制性片段长度设为一千零一,九个一千碱基片段全部不合格。此时十一对有比对的记录进入过滤类别,一对完全未比对记录仍被丢弃,原来那些产物分类计数都变为零。若不看规则,只比较自环比例,会错误地认为样本的自环问题消失了。
因此比较不同运行的质量统计,必须先核对筛选顺序和统计分母。某类数量下降,可能是其原始记录先被另一条规则截走,而不是实验改进。正式报告最好同时保留进入分类的总对数、每类绝对数量及过滤后总量,让读者能够重新计算比例。
插入片段长度和两端基因组距离也应分别理解。有效连接的长度估计利用两端与所属酶切片段边界的关系,不是简单地拿两端坐标相减。本文没有扫描插入长度门槛,读者如需调整,应先抽取具体记录手算其长度来源,再决定阈值。
七、有效接触、去重后接触和矩阵像素不是同一个数量
基础分类输出四对有效接触。执行实际的合并脚本时,关闭去重仍为四对,开启去重变为三对,删除的是我们特意复制的一对。这个阶段的统计文件同时记录合并前与去重后的数量,因此可以核对数量守恒,而不是只看最终文件是否存在。
合并脚本使用已经排序的输入进行归并,本次先按染色体及位置把每个输入文件排序。若手动准备了中间接触文件却遗漏这一步,程序的前提就不成立。逐块处理再合并时,也应该确认块内排序规则一致,不能认为拼接多个文件就自动完成了全样本去重。
接着用实际矩阵构建程序生成一千和两千碱基两种分辨率。去重后一千碱基矩阵只有两个非零像素,计数分别为二和一,总和为三。两千碱基矩阵依然只有两个非零像素,总和仍为三,但分箱编号发生变化。
/HiC-Pro_3.0.0/scripts/build_matrix \
  --binsize 1000 --chrsizes chrom.sizes \
  --ifile dedup/data/sample/sample.allValidPairs \
  --oprefix dedup_1000 --matrix-format upper
这里不能把“两行矩阵”解读成“两对有效接触”。多个不同接触可以汇总到同一个分箱对,第三列才是该像素的计数。也不能把三列矩阵中的第一、二列直接当作基因组坐标,它们需要通过同时生成的分箱注释表映射。官方对中间结果及矩阵结构的说明见结果文件文档。
本次只构建原始上三角矩阵,没有执行迭代校正。若下游需要校正矩阵,要另行检查低覆盖分箱、收敛状态及偏差向量,不能因为已经得到矩阵文件,就默认完成了标准化分析。
八、把工具优缺点落到实际使用判断上
HiC-Pro 的优势是中间产物较完整,片段分类、有效接触、去重统计和矩阵都可以独立核对,适合追踪一个样本在哪一步损失了数据。模块化也便于已有比对结果的项目从中间阶段开始,减少重复计算。
它的局限是每个入口对上游状态有明确依赖。直接调用分类脚本不等于运行了比对质量筛选,接触文件进入合并前需要符合排序要求,旧镜像的依赖组合也可能影响边界行为。熟悉全流程并不只是记住一个启动命令,还要理解这些中间契约。
这次实跑最值得带走的方法是建立一小组人工已知输入,覆盖同片段、相邻片段、跨染色体、低质量、重复及注释不匹配情形。升级环境或更换参考后先跑这组输入,再检查真实样本中抽取的代表记录。这样可以在大批处理之前,把配置错误和版本差异与真正的实验质量问题分开。
当这套检查完成、需要处理更多样本和多种矩阵分辨率时,可了解云生信生物信息学分析环境与算力服务,在明确的软件版本与流程记录下继续批量分析。


