
基因型填补完成后,最容易得到的是一个漂亮的总体数字,最难确认的是这个数字到底回答了什么问题。某个低频位点的硬判定一致率达到百分之九十八,可能一个携带者都没有找对。剂量与真值的相关系数平方等于一,也可能仍有系统性偏差,甚至等位基因方向完全反了。理解这些情况,比记住一条填补命令更能帮助判断结果是否适合后续分析。
本文围绕 IMPUTE5 的方法定位和结果审阅展开。官方页面将其列为仅向学术用途免费提供的软件,并另列许可条款。本次没有安装或执行 IMPUTE5。下面所有数值来自我们编写并实际运行的 Python 概率练习,输入也是原创示例,不是该软件的输出、性能测试或准确率排名。官方软件说明、许可说明
一、先知道 IMPUTE5 在推断哪一种信息
填补并不是从文件格式中恢复被压缩掉的记录。目标数据通常只检测部分位点,方法借助参考单倍型和附近已知标记,对未观测的基因型作概率推断。IMPUTE5 使用位置 Burrows-Wheeler 变换寻找局部匹配的参考单倍型,再把所选单倍型作为隐马尔可夫模型的条件状态。其核心思路之一,是针对目标选择有用的局部参考状态,而非让所有参考状态始终参与同样的计算。方法论文
由此可以推导出两个输入层面的要求。首先,参考中有大量位点,不表示目标在每个区域都有足够锚点识别合适的模式。其次,参考数量增加也不等于目标人群中的所有稀有变异都能被可靠预测。坐标、等位基因表示和定相质量决定输入是否可比较,参考对目标的适配程度则决定模型有多少相关信息可用。
实际设计项目时,应把目标样本、参考样本和评价样本分开描述。用于补全的参考不能同时被当作完全独立的测试答案,输入中已经观察到的基因型也不能直接代表未检测位点的预测难度。先明确哪些信息对算法可见,再讨论准确率,才能防止验证过程把答案泄露给模型。
原论文提供过特定版本、面板和数据条件下的性能比较。本文不把那些历史倍率转换为当前环境下的承诺。运行成本还涉及参考准备、文件读写、目标规模和输出范围。若要比较方法,应让它们使用相同输入及评价集合,并记录完整工作流,而不只取一段最有利的核心计算时间。
二、把硬判定、剂量和概率放在同一张表里
对于一个二倍体双等位基因位点,先明确我们数的是哪一个等位基因。以下练习始终统计替代等位基因数,真值只能为零、一、二。三个概率依次表示这些计数的概率,和应接近一。剂量则是概率加权后的期望计数,可以处于零到二之间,通常不必是整数。
若直接选择概率最大的类别,就得到硬判定。它便于展示,但把不确定性压缩成一个数字。例如概率分别为零点五一、零点四九和零,硬判定仍为零,却不能理解为几乎确定不携带。剂量为零点四九,保留了与后一类别接近的概率信息。下游究竟使用哪种量,应由统计模型决定,而不是看哪一列最容易导出。
这个关系也提供了一组简单的数据检查。先核对概率取值和概率和,再从概率计算剂量,与输出的剂量列比较。允许文件打印精度造成的微小差异,但不能把任意偏差都归因于舍入。不同倍性、不同等位基因数和不同概率排列需要不同的解释,本文的三分类公式只针对上述二倍体双等位基因条件。
# 本文原创练习中的定义,不是 IMPUTE5 的命令或 INFO 算法
dosage = p1 + 2 * p2
hard_call = max(range(3), key=lambda k: [p0, p1, p2][k])
mse = sum((g - d) ** 2 for g, d in zip(truth, dosage_list)) / len(truth)
allele_frequency = sum(dosage_list) / (2 * len(dosage_list))
三、百分之九十八一致率,怎样漏掉全部携带者
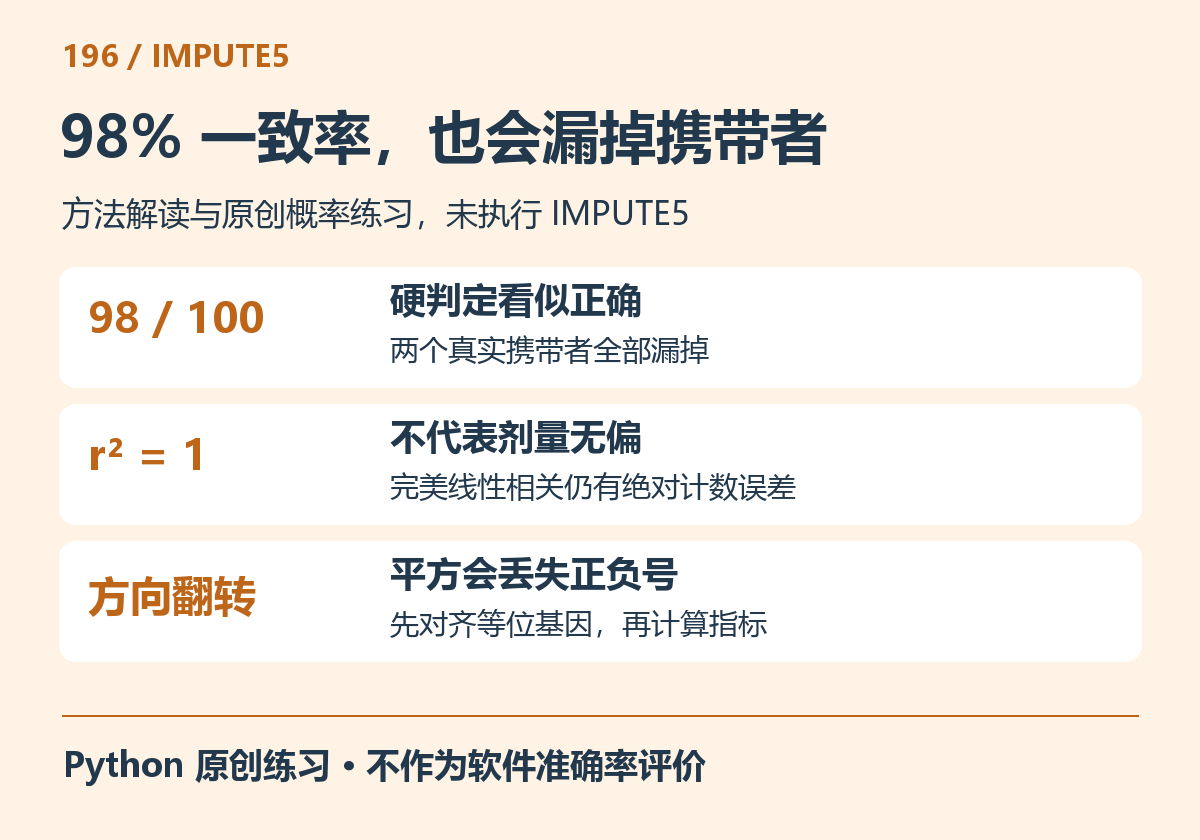
我们设定一百个样本,其中九十八个真实计数为零,两个为一。真实替代等位基因频率为百分之一。预测方案甲对每个人都给出同一组概率,分别为零点九八、零点零二和零,因此每人的剂量都是零点零二,硬判定全为零。
运行脚本后,甲的总体硬判定一致率确实是百分之九十八,但两个携带者全部漏掉,携带者召回率为零。更容易误判的是,用剂量计算的总体等位基因频率也恰好为百分之一。群体频率正确与个体识别正确没有逻辑上的等价关系,前者不能替代后者。
这个反例并不依赖复杂模型,只依赖类别极度不均衡。当绝大多数样本不携带某个低频等位基因时,总体正确数很容易被这一类主导。因此评价稀有位点,应同时查看真值中有多少携带者、非参考基因型是否恢复,以及预测概率有没有区分样本,而不是只报告所有样本混在一起的百分比。
也不要看到召回率就停止检查。极端地把所有人都判为携带者,同样可以得到很高的召回率,却会引入大量错误。应结合混淆表及错误方向审阅。本练习选择两个携带者只是为了让计算透明,正式评价中的不确定性需要足够验证样本支持,不能把两个人的比例当作稳定的人群参数。
四、相关系数平方为一,为什么仍有剂量误差
方案乙对九十八个非携带者给出剂量零点零一,对两个携带者给出零点九。相应概率分别为零点九九、零点零一、零,以及零点一、零点九、零。乙的硬判定全部正确,经验相关系数平方也等于一,但剂量仍没有逐个等于真值。
| 原创方案 | 硬判定一致数 | 携带者召回 |
|---|---|---|
| 甲,恒定预测 | 98 / 100 | 0 / 2 |
| 乙,区分样本 | 100 / 100 | 2 / 2 |
| 乙,仅预测方向翻转 | 2 / 100 | 2 / 2 |
| 剂量评价指标 | 甲 | 乙 |
|---|---|---|
| 均方误差 | 0.0196 | 0.000298 |
| 经验相关平方 | 无定义 | 1 |
| 剂量频率 | 0.0100 | 0.0139 |
原因是乙的剂量与真值之间存在精确的线性关系,剂量等于零点零一加上真值的零点八九倍。相关系数衡量这种线性共同变化,不要求截距为零、斜率为一。均方误差则直接比较数值距离,因此能发现相关系数平方没有表达的偏差。两者回答的问题不同,应该并列理解。
乙的剂量频率为百分之一点三九,高于设定真值中的百分之一。这进一步说明,样本排序关系、离散分类和绝对计数量级可以表现不同。读者拿到一份结果时,可以先画剂量与真值的散点关系,再查看频率差异和误差分布,而不是把一个汇总指标当成所有方面的保证。
本例使用完全人为的概率,所以不能据此断言某个填补软件具有这种偏差。它的用途是验证评价程序是否会给出预期答案,并帮助确定报告该保留哪些互补指标。只有在这种可控例子上理解了计算含义,面对真实数据中的复杂差异时才不容易被数字名称带偏。
五、方向反了,相关系数平方仍然可能不变
我们把乙的三个概率顺序反过来,相当于把所统计的等位基因换到另一侧,剂量变成二减去原剂量,却故意不改真值的计数方向。此时相关系数变为负一,其平方仍然为一。硬判定却只与两个杂合样本一致,另外九十八个样本全部错了。
方向翻转后的剂量均方误差达到 3.881098,剂量计算的频率为 0.9861。这两项与平方相关形成鲜明反差,也让错误的量级变得可以直接核对。
这个对照说明,只保存平方后的相关指标会丢失方向信息。若另一份表格统计的是参考等位基因,而你认为它统计的是替代等位基因,再高的平方相关也无法自动发现错误。比较之前必须对齐实际的等位基因身份,不能仅凭相同坐标或相同编号连接记录。
这里是故意漏做真值重编码的错误对照。如果预测和真值同时按一致规则转换,统计对象只是换了名字,不应把它当成预测质量下降。实践中应保存转换清单,记录哪些位点交换过等位基因、哪些需要互补链处理、哪些由于歧义被排除,并在验证前复查转换后的频率和方向。
单个指标看似反常时,先核查定义通常比重新运行整个填补任务更快。尤其当高相关与明显的频率差异同时出现,应优先检查等位基因和样本对应关系。输出文件读得通,并不能证明两份数据比较的是同一个对象。
六、相关性无定义时,不要擅自填成零或一
方案甲的剂量对所有人都相同,预测方差为零,所以相关系数没有定义。另一个对照让真值和预测全部为零,硬判定完全正确、均方误差为零,但真值没有变异,相关系数平方仍然没有定义。脚本在这两种情况下输出空值,并保留原因。
把第一种情况填成一,会把没有任何个体区分能力的预测当作完美结果。把第二种情况直接填成零,也会混淆没有可评价变异与预测失败。更稳妥的做法是给出有效评价位点数,并单独统计单态位点和零预测方差位点,使汇总指标的分母可追踪。
本文计算的是拿已知答案与剂量比较的经验相关性。它不是 IMPUTE5 的 INFO,也不是其他软件的某个模型内部质量字段。不同字段的估计方式和适用条件必须回到对应版本文档确认。名字里都有平方或质量二字,并不能保证数值可以直接互换或共享同一个阈值。
七、分块合并也会改变你的评价集合
练习包还包含一个区间例子。我们定义两个互不重叠的核心区间,同时让读取范围向两边扩展。扩展范围用于获得邻近上下文,最终应由各块负责各自的核心记录。如果直接把读取范围中的全部结果拼接,重叠位置会重复出现,影响位点数和汇总评价的权重。
这段原创代码统一使用左闭右开的区间约定。第一块核心是一百到三百之前,第二块是三百到五百之前。两块带缓冲的读取结果直接拼接得到十四行,其中位置二百五十、三百和三百五十重复。按核心归属裁剪后得到八行,既没有重复,也没有边界漏行。
这些边界只是教学用的 Python 区间,不是对 IMPUTE5 命令参数坐标约定的声明。实际使用某个软件时,要确认它的起止坐标是否包含端点,再把任务清单转换成同一约定。对于真实变异,去重键还应包含染色体、位置、参考与替代等位基因,不能简单按位置删除所有后出现的记录。
八、把审阅过程变成可重复的验收
从练习包解压后,运行下面的命令即可得到原创概率表和核验结果。程序只使用 Python 标准库,不下载、调用或仿造 IMPUTE5 的可执行程序,也不把示例表格伪装成原生输出。
python3 196-impute5/run.py output-impute5-review
迁移到真实项目时,可以沿用检查思路,但需要换成经过独立验证的真值数据。先完成样本身份与等位基因对齐,再明确评价位点集合,随后分开报告硬判定、剂量误差、经验相关性与保留率。遇到无法计算的指标,应说明原因并保留有效分母。这样读者才知道一个好看的结果究竟来自预测能力、数据构成还是筛选选择。
把这些定义写进分析记录,还能减少协作中的误解。别人接手时应能够知道每一列统计哪种等位基因、缺失怎样处理、哪些位点被过滤、评价集合是否变化。可复核的结果通常先来自清楚的定义与对应关系,然后才来自更大规模的计算。
需要把这样的输入检查、分块管理和结果核验整理成长期可复用的分析流程时,可了解云生信生物信息学分析环境与计算服务。


