
VCFtools 的命令往往很短,但短命令也会产生难以察觉的解释错误。把最低完整率当成最高缺失率,把低深度基因型过滤当成整个位点删除,或者在抽取样本后直接使用旧的 INFO 频率,都可能让后续分析使用错误的分母。
本文实际安装并运行 VCFtools 0.1.17,构造四个样本、十个位点的 VCF,逐项检查过滤、频率统计、文件重写和连锁不平衡计算。所有记录都是原创练习数据,没有真实个体,也不用于推断群体历史。小数据的价值在于可以手算答案,再检查软件输出是否与预期语义一致。
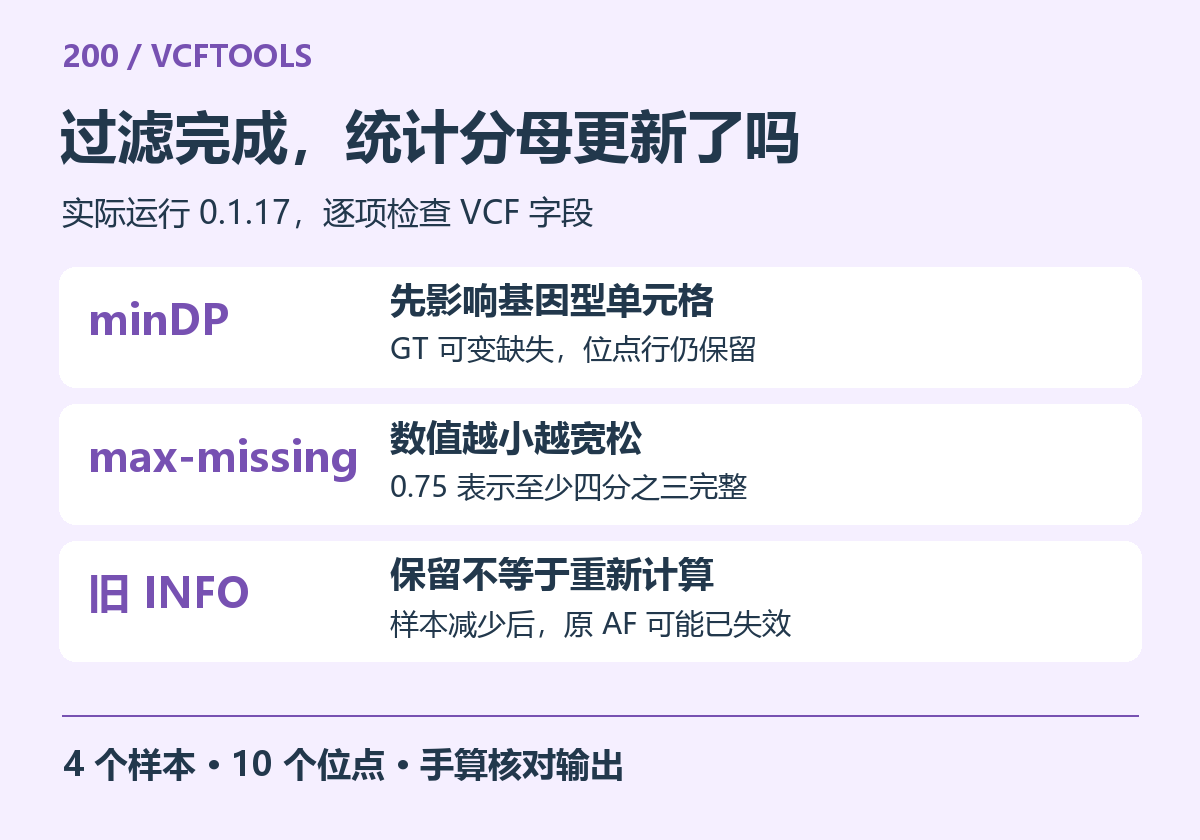
一、读命令前,先把三种过滤对象分开
VCF 文件包含位点层面的信息,也包含每个样本在该位点的基因型及附加字段。样本过滤会改变保留哪些列,位点过滤会改变保留哪些行,基因型过滤则可能只把某些单元格的 GT 改成缺失。三者都会影响统计,但并不是同一个操作。
例如一个位点有四个样本,其中只有一个样本深度不足。如果目标是忽略这个样本在该位置的判定,就不一定需要删除整个位点,也不一定需要删除该样本在其他位置的数据。反过来,某个位点所有样本都变成缺失后,即使该行仍存在,也不意味着它仍提供有效基因型信息。
字段层级也必须分清。INFO 中的 DP 是位点注释,FORMAT 中的 DP 则对应逐样本数据。两者名称相同,不代表数值来源与分母相同。具体解释应结合文件头和生成程序,不能看到一个 DP 就默认它表示当前样本的深度。VCF 格式规范
我们在一个练习位点中特意让 INFO 的深度注释为八十,而四个样本的 FORMAT 深度都是二,用它检查参数究竟读取哪一层。这是人为设置的元数据对照,不应拿来推导真实测序流程中两种深度必然具有怎样的关系。
二、固定安装版本,再用十个位点做参数验收
本次使用固定摘要的容器。运行脚本会生成输入 VCF、样本清单和指定位置清单,再完成各组命令。版本号来自实际 --version 输出。官方在线手册的页首仍标注较早的版本,因此本文涉及的具体行为均以这次运行结果核对,而不是只依据网页标题判断。项目仓库、官方命令手册
docker pull quay.io/biocontainers/vcftools@sha256:a6ef07658eb0f678ded605d7108700bbf15381a877f8effa88b15b80d9de0f03
python3 200-vcftools/run.py output-vcftools

# 在已有 vcftools 的环境中检查版本与基础频率
vcftools --version
vcftools --vcf input.vcf --freq --out base_freq
vcftools --vcf input.vcf --minDP 8 --freq --out dp_freq
原始数据包含完整位点、部分缺失位点、低深度基因型、一个多等位基因 SNP、一个插入位点,以及一个带低质量过滤标签的位点。最后两个位置具有已知相位,用于比较两种不同的相关统计。设计这些差异,是为了让每个参数都有可以观察的作用对象。
使用自己的数据前,也可以准备类似的小文件,把期望保留的样本与位点写成清单。先验证语义,再组合条件,能避免在一份很大的结果中靠猜测寻找某个位点为什么消失。数据越大,这种小型验收越有价值,但无需把练习本身做得很大。
三、minDP 改的是哪些基因型
只设置最低深度八并输出重写文件后,十个位点全部仍在。位置二百原来的基因型是参考纯合、替代纯合、杂合和缺失,第二个样本深度只有二,因此它的 GT 被改成缺失。保留的有信息基因型只剩参考纯合和杂合。
对应的有效等位基因数从六变成四,G 的频率从零点五变为零点二五。这可以直接手算,剩下两个人共有四个等位基因,其中只有一个 G。样本总列数仍然是四,但频率的分母已经不是八,也不能继续使用原来六个已调用等位基因的计数。
位置三百的四个基因型深度都只有二,过滤后全部变成缺失,该行却仍保留在单独的深度过滤输出中。重新计算频率时,有效等位基因数为零,频率出现无法定义的数值标记。脚本保留原始文本,并在结构化核验结果中将无法定义的数值写为空值,没有把它误记为零频率。
这个位点的 INFO 深度为八十,仍没有阻止四个 GT 被过滤,说明本次 --minDP 使用的是逐样本 FORMAT 深度。只有在理解这一层级之后,才知道该去检查深度矩阵、位点汇总还是样本质控,而不是对着一个较大的 INFO 数值怀疑程序没有执行参数。
四、max-missing 数值越小,条件反而越宽松
这个参数的名称很容易误导。--max-missing 0.5 在本例中保留至少一半样本非缺失的位点。设为零点二五则允许只有四分之一的样本非缺失。数值一表示不允许缺失,数值零则不施加这种完整率要求。因此它不能按“最多允许缺失这么多”直接理解。
原始位置四百有两个人可用,位置五百只有一个人可用。阈值为零点五时,前者保留、后者排除,输出九个位点。阈值降低到零点二五时,位置五百也保留,输出十个位点。这组结果清楚显示,降低参数值会放宽而不是收紧限制。
| 实际设置 | 保留位点数 | 关键变化 |
|---|---|---|
| 只用 minDP 8 | 10 | 部分 GT 变缺失 |
| 只用 max-missing 0.5 | 9 | 排除仅一人可用的位置 |
| 只用 max-missing 0.25 | 10 | 允许四分之一完整率 |
| minDP 8 加 max-missing 0.75 | 6 | 按过滤后的有效 GT 判断 |
读者若希望“缺失比例最多为四分之一”,对应的是至少四分之三完整,而不是把参数写成零点二五。最好在分析方案中同时写出自然语言条件与实际数值,再用一个临界例子验证。命令名看起来熟悉,不能代替对取值方向的检查。
五、参数写在前面,不等于按文字顺序执行
我们将深度过滤与完整率过滤组合,并交换它们在命令行中的先后顺序。两次输出都保留六个位点。另一次先单独把低深度 GT 置为缺失,写成中间文件,再对中间文件执行完整率过滤,也得到同一组位置。
这说明在本次版本和这组设置中,组合过滤的效果与先处理基因型、再判断完整率一致。不能通过把某个参数移到命令开头,就假定程序会改变内部执行次序。若研究方案确实要求两个独立阶段,应明确生成中间文件,并验证每一阶段的样本和位点集合。
vcftools --vcf input.vcf --minDP 8 \
  --recode --recode-INFO-all --out depth_masked

vcftools --vcf depth_masked.recode.vcf --max-missing 0.75 \
  --recode --recode-INFO-all --out complete_sites
这里保留 INFO 是为了让后面的陈旧注释问题可以被观察到,并不表示这些统计字段在过滤后仍然有效。中间文件有助于追踪变化,但它本身也需要语义检查。不能因为流程分成两步,就认为每一步输出的所有注释都已经自动更新。
六、保留 INFO,不等于重新计算 INFO
原始位置一百的四个样本共有八个已调用等位基因,其中四个为 G,所以 INFO 中记录 AC 为四、AN 为八、AF 为零点五。我们用样本清单只保留 A1 和 A2,其基因型分别为参考纯合与杂合,正确的 G 频率应该变成四分之一。
使用 --recode-INFO-all 后,输出只有这两个样本列,但原来的 AC、AN、AF 仍分别为四、八和零点五。它们被保留了,没有依据新样本重新计数。对同一份输出再运行 --freq,频率表得到的有效等位基因数为四,G 频率为零点二五,与手算一致。
默认重写而不要求保留 INFO 时,练习位点的 INFO 变为缺失标记。这与手册说明相符,因为抽取样本和过滤可能使原注释失效。需要保留哪些注释,应区分不依赖当前样本集合的描述性信息与依赖集合的计数或频率,不能一概认为保留越多越完整。
这一点还影响跨团队交付。若一份文件的 GT 已经经过筛选,而附带频率仍来自原始队列,应明确标注来源。否则接收者可能根据 INFO 再执行一轮频率筛选,与直接从当前 GT 计算得到的结果不同。对关键字段进行重新计算或独立核验,比仅保留原始表头更有用。
七、去掉插入缺失,并不保证只剩双等位基因 SNP
本例位置六百的替代等位基因是 G 和 T,三个等位基因都是单碱基。单独运行 --remove-indels 时,它仍被保留。位置七百的插入记录则被删除,输出九个位点。再加入最少两个、最多两个等位基因的限制,多等位基因记录才被排除,输出变为八个位点。
因此,如果下游要求双等位基因 SNP,需要分别表达长度类型与等位基因数条件。不能把一个去除插入缺失的选项当作包含了所有格式约束,也不能仅凭文件名带有 SNP 就跳过检查。特殊符号等位基因和复杂变异还需要按照实际输入进一步审阅,本例没有覆盖所有表示形式。
带有低质量标签的位置八百,在前面只按深度和完整率过滤的运行中仍然保留。执行 --remove-filtered-all 后,它才被排除。GT 深度足够、没有缺失,与位点是否通过上游质量标签,是不同的条件。使用某一种过滤不会自动启用另一种。
写分析方法时,可以把每条条件对应到输入字段,例如样本清单、GT 深度、完整率、等位基因数和 FILTER 状态。这样读者能知道哪些标准实际执行过,也能看到哪些未包含。一个笼统的“完成质控”无法替代这些可复查的定义。
八、同两个位点,基因型 r² 与单倍型 r² 为什么不同
最后两个位置在四个样本中的替代等位基因计数,分别为零、零、二、二,以及零、一、一、二。用 --geno-r2 得到的相关系数平方是零点五。它比较的是每个个体的基因型计数,两组向量共有四个观测单位。
同一份带相位数据使用 --hap-r2,得到的相关系数平方是零点二五,输出同时报告八条染色体。这里使用的是两条单倍型上的等位基因组合,观测单位和统计对象已经改变。两个数不同,并不意味着某条命令计算错误,也不能把它们混在同一张阈值表中直接比较。
这组例子强调的是统计定义,不是在四个样本上估计可靠的人群连锁程度。真实应用还需考虑样本量、相位质量、频率与样本相关性。若输入未定相,不能仅把分隔符换成竖线就让它满足单倍型分析要求,那样只是人为指定了未经支持的组合。
同样写作相关系数平方的量,还可能来自剂量与真值的比较。符号相同并不代表变量相同。阅读结果时应先回答,比较的是哪些量、每个观测单位是什么、缺失如何处理,然后才讨论某个数值大小意味着什么。
九、把验收清单落实到输出文件
本次练习包包含完整生成脚本、命令日志和核验结果。脚本分别比较位点集合、样本集合、过滤后 GT、有效等位基因数以及两种连锁统计。出现无法定义的频率时保留其状态,没有用零值掩盖没有分母的事实。
迁移到实际项目时,可以沿用这个检查次序。先确认哪些行列和基因型发生变化,再确认依赖这些数据的统计字段是否更新,最后再计算群体指标。若结果与预期不符,回到一个可手算的位点检查,通常比一次性更换整套参数更容易定位原因。
需要把这些过滤规则、字段核验和批量统计整理成可重复的分析流程时,可了解云生信生物信息学分析环境与计算服务。


