
在肿瘤边缘和组织内部各找到一枚表达相似的免疫细胞,它们应该被归入同一群吗?如果目标是建立细胞类型清单,可能希望它们靠在一起。如果要找免疫细胞聚集的边界和组织生态位,则希望图能保留两处邻里的差异。BANKSY 将细胞自身的表达与周围邻居的表达特征组合起来,允许分析者调整两部分的相对贡献。同一份坐标和计数,可能因研究目标不同而得到两套都有生物意义的分组。张贴结果前,值得先用已知类型和已知区域分别检查模型保留了什么。BANKSY 原始研究
画出两种真值,再决定怎样评价
设想一张八乘八的空间网格,左右半区都有甲和乙两类细胞。左侧乙多甲少,右侧甲多乙少。此时“是不是甲类”和“位于左区还是右区”有关联,但没有任何一项能完全替代另一项。例如左区的少量甲细胞,若自身甲标记可靠,在类型图上应能与右区的甲细胞接近。在区域图上,它身边的大多数细胞却是乙类。先用这个例子预演,再问自己的数据中有没有类似的交叉对照,比单看一张聚类图的颜色是否连片更能说明模型行为。
研究数据没有模拟真值时,可从两条途径寻找近似对照。细胞类型用独立标记组合、可信的参考注释或成像复核,组织区域用病理轮廓、层状结构或独立定义的解剖位置。尽量选取同一种类型分布在不同区域、同一区域包含不同类型的点,分别观察它们的相似性。若某类型只出现于某个解剖区域,两个目标在这份数据里天然共变,任何高分都很难说明区别来自细胞内在状态还是邻里组成。把可交叉比较和无法区分的部分如实标在样本图上,有助于选择后续验证。
邻域半径与邻域权重是两个问题
使用固定邻居数时,程序先根据空间几何决定从哪些细胞提取邻域特征。密集区域和稀疏区域即使都取八个最近邻,实际覆盖的微米范围也可能不同。应抽查组织中心、切片边缘和明显空洞两侧的邻居距离,确认局部平均没有跨过本不相连的区域。若来源是多张切片,先核实各张切片的坐标系和邻接构造,尤其要避免两张局部坐标从零开始的组织在拼接后互相贡献邻居。这种污染一旦写入邻域矩阵,再调低邻域权重也没有修复错误的空间关系。
邻域权重决定这些特征参与下一步表征的程度。原本邻域选择和计算特征的设置应先固定,再改变权重,以免同时改变证据来源和混合比例后无法解释差异。选择参数时,不少人只看二维降维图有多少个漂亮分支。相同的邻接输入可以因降维种子、投影和绘图顺序显得更紧或更散。可以先回到实际特征矩阵,为每个细胞在表征空间找一个最近邻,再分别统计最近邻是否同类型、是否同区域。作者也提供了在同一数据上比较多组参数的实例。作者的参数选择教程
| 邻域权重 | 最近邻同类型的细胞 | 最近邻同区域的细胞 | 两项都相同 |
|---|---|---|---|
| 0 | 63 / 64 | 44 / 64 | 44 / 64 |
| 0.2 | 62 / 64 | 58 / 64 | 56 / 64 |
| 0.8 | 48 / 64 | 63 / 64 | 48 / 64 |
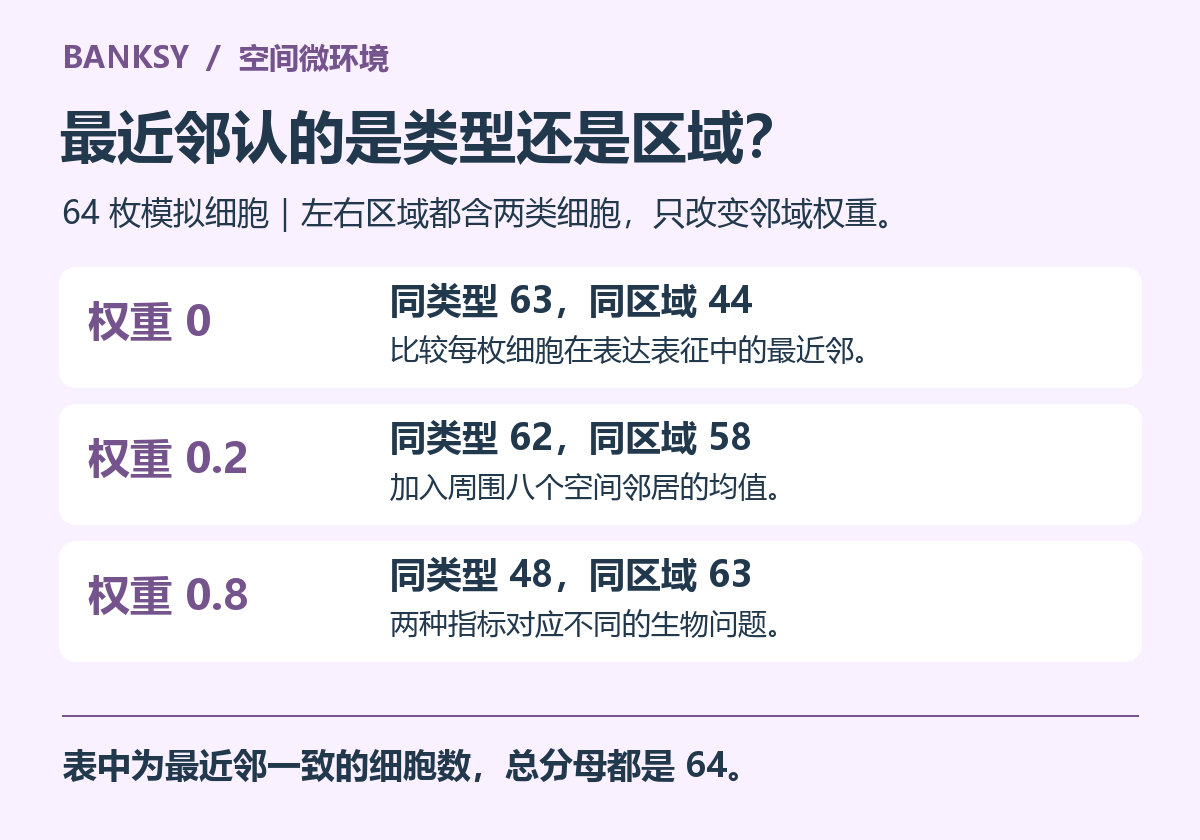
实跑经验|同区域的邻居变多,同类型的却变少
我们在 R 4.5.2 安装 Banksy 1.6.0,生成六十四枚细胞、三十个基因的模拟计数。左半区有八枚甲和二十四枚乙,右半区恰好相反。给每种类型六个偏好表达基因,固定输入种子三十七。先按细胞总量归一化并取对数,再用八个最近邻的均匀权重构造邻域均值,不计算角度梯度特征。随后取邻域权重零、零点二和零点八,保持预处理和邻接方式完全一致。对每份按特征标准化并加权的矩阵计算细胞间欧氏距离,排除细胞自身,逐一提取最近邻。组合特征矩阵的接口与参数
权重为零时,六十四枚细胞中六十三枚的最近邻与自己同类型,只有四十四枚同区域。权重零点二时同类型数为六十二,同区域数升至五十八。权重零点八时同类型数降到四十八,同区域数却升到六十三。表中最后一列另外要求两项同时成立,数目与前两项的较小值也不必相等。这次我们直接检查的是表征空间里每个细胞的一个最近邻,没有额外运行社区聚类。因而不能把四十八除以六十四写成聚类软件的分类准确率,更不能把零点二当成适用于所有切片的推荐参数。
z <- as.matrix(Banksy::getBanksyMatrix(s, M=0, lambda=0.2,
    assay_name="logcounts", scale=TRUE, verbose=FALSE))
D <- as.matrix(dist(t(z)))   # 每列是一枚细胞
diag(D) <- Inf
nn <- apply(D, 1, which.min)
c(same_type=sum(type == type[nn]), same_region=sum(block == block[nn]))
还可以把这张表拆细一层。总体上邻域权重增加时区域一致性变高,尤其值得回看的,是少数类型散在另一群中的细胞。分别统计“左区的甲”“右区的乙”与当地多数类的结果,再画出发生最近邻更换的细胞及其原始标记。若少数类型的自身标记稳定,却在高邻域权重下被周围群体包围,这可能正符合生态位图的用途。若任务是给稀有类型做细胞注释,就应保留其自身表达证据,并谨慎处理由邻里主导的标签。
怎样交付两张不会互相冒充的图
在类型图旁列出最能区分类别的自身标记,在区域图旁列出邻居组成和几何尺度。如果同一个候选结构在前者松散、后者连片,可以写成“该群在局部微环境上相似”,并展示哪些邻里特征支撑这一解释。若要主张发现了新的细胞亚型,应补回细胞自身和跨样本重复的证据。对密度差异大的切片,可以再变化邻居数量,讨论研究结论是否跨尺度稳定。这比在所有参数里挑一张轮廓最整齐的图更便于复现。
需要在多张切片上重复比较邻居数量、权重和独立样本时,可以先固定上述两种评价,再安排批量运行。研究团队可了解云生信的生物信息分析服务器。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)