
同一个人的读段和单样本 gVCF 都没改,队列多加了八个人,重做联合分型却发现旧表里有两条记录在新表里匹配不上。这是原来的变异消失了吗?我们用 GLnexus 官方教程中的千人基因组计划公开样例,在 ALDH2 附近取两个嵌套的小队列。四人的结果有六十八条,十二人的有七十七条,完全匹配的记录只有六十六条。找到那两条旧记录的基因组位置,再打开原始样本的参考块,就能看清有些差异来自新增携带者,另一些来自同一位置改用了另一种写法。GLnexus 官方入门与公共数据来源
为什么要用各样本的 gVCF 做联合分型
普通的单样本变异表往往只列出被发现的变异。一个样本某处少一行,可能因为参考证据充分,也可能因为覆盖不足。样本级 gVCF 额外保留参考置信区间等信息。联合分型时,程序先从样本中收集候选,决定怎样在队列层面表示等位,再对每个样本在相应位置填入可支持的基因型。同一个位置有多个不同长度的替代序列时,输出需要一个足以共同表示这些等位的参考字符串。因此,增加样本不一定只是在旧表后面加几列。GLnexus 项目与联合调用流程
本次资料包包含二千五百零四个历史 DeepVariant 0.8.0 生成的局部 gVCF。为了逐行追查,我们按样本文件名字典序先取前四个,再取前十二个,后者包含前者的全部成员。运行 GLnexus 1.4.1,两次均使用同一套全基因组 DeepVariant 预设、相同的十二号染色体区间和相同线程数,各建一个临时数据库。样本选择是可复现的教学抽取,不适合拿来估算总体频率。不同调用器或测序设计有自己的分型配置,复用历史队列时要记录输入来源和所用预设。GLnexus 作者的配置说明
实跑经验|六十八和七十七之间不只差九条
我们按照染色体、位置、参考和完整替代列表四项形成匹配键,先比较整条队列记录,再按样本名比较基因型。两个队列有六十六个相同键。四人组独有两个旧键,十二人组独有十一个新键。拿两个总行数相减只会得到九,无法发现其中有两处更换了等位表示。在六十六个完全相同的键上,四名原始样本共二百六十四个基因型格子,逐个按名字对齐后没有改变。这个检查只覆盖相同键的那些格子,对键已变化的地方不能直接照搬。
| 对照对象 | 四人队列 | 十二人队列 |
|---|---|---|
| 全部队列记录 | 68 | 77 |
| 仅本队列有的完整变异键 | 2 | 11 |
| chr12 的 111815781 位 | A→T | A→T,ATT |
| chr12 的 111761958 位 | 无单独队列记录 | T→C,11 人 0/0,1 人 0/1 |
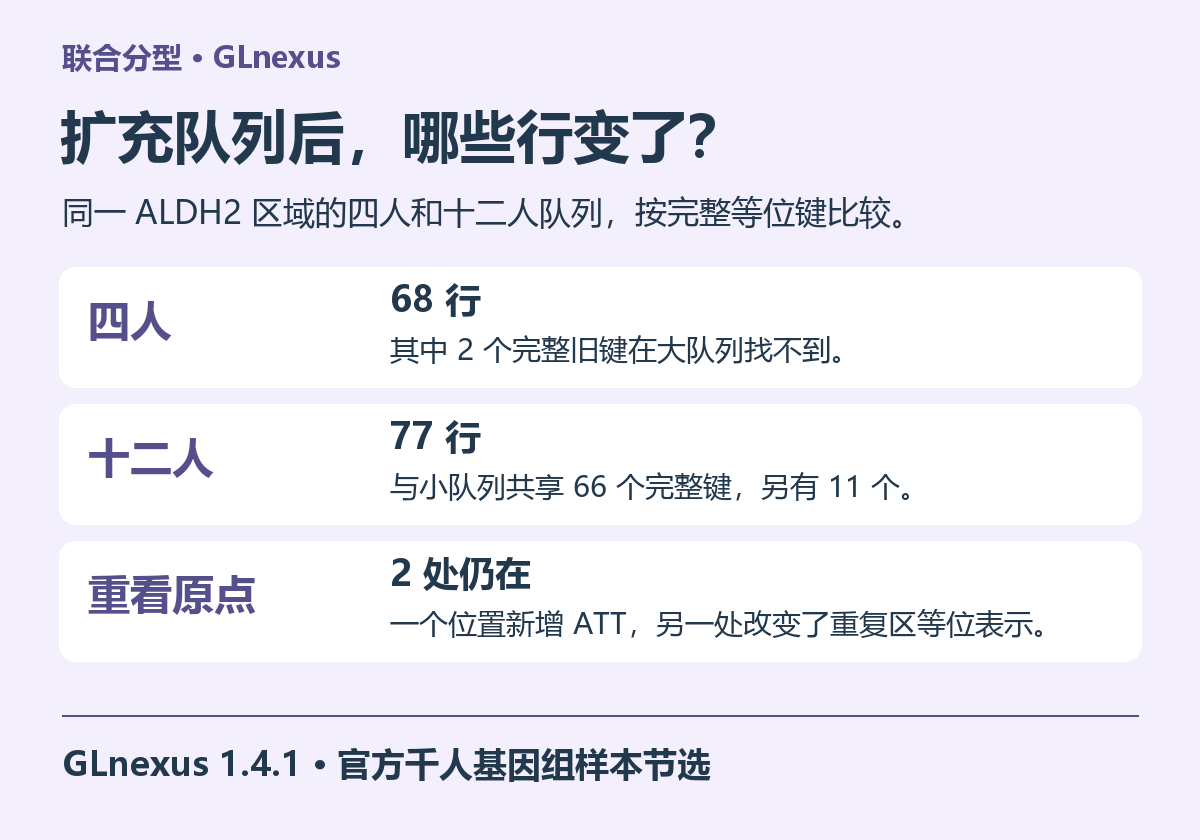
把两个旧键按染色体和起点重新查找,两个位置在十二人表中都仍然存在。其一原来参考为 A、替代为 T,现在多了 ATT,旧表中的 T 仍在。另一个位置落在重复序列,旧行参考字符串长五个碱基,新行延长到十七个,候选替代列表也变化。只比较字符串会把旧记录列为丢失。只比较起点又会把全部新旧等位强行视为相同。在后一类复杂位置,若要跟踪旧样本的某个等位,应先映射为同一参考上的具体序列变化,再比较携带状态。
另一个位置则能看见新候选由谁带来。十二号染色体第一亿一千一百七十六万一千九百五十八位,新增样本 HG00109 携带 T 到 C 的杂合,原来四人的新队列基因型都为参考纯合。回读该样本的单样本 gVCF,三十一条深度中十六条支持参考、十五条支持 C,对应基因型质量五十四。再看原队列中的 HG00096,同一位置落在它的一条长参考块内,块的最低深度二十六、质量五十。这解释了为什么四人变异表没这一行,但在扩大的队列中仍能为原成员提供有依据的参考基因型。作者对群体 VCF 输出的解读
glnexus_cli --config DeepVariantWGS --threads 2 --mem-gbytes 2 \
  --bed locus.bed --dir joint4.db --list four-samples.txt > joint4.bcf
glnexus_cli --config DeepVariantWGS --threads 2 --mem-gbytes 2 \
  --bed locus.bed --dir joint12.db --list twelve-samples.txt > joint12.bcf
bcftools query -l joint12.bcf
bcftools query -f '%CHROM\t%POS\t%REF\t%ALT[\t%GT]\n' joint12.bcf
复核这种“新增”时,参考块的起点未必等于要查询的坐标。例如上述参考样本的原始块起于一亿一千一百七十六万一千二百九十二,止于一亿一千一百七十六万二千,横跨要查的位置。在压缩文本里只搜索目标坐标的数字,会漏掉这条有效的参考证据。用支持区间重叠的查询,或直接核对起点和结束字段,再把样本名和所用文件一并记下。
十二人结果中,其余十一个样本都为参考纯合,但这是本次特定区间、预设和样本组合下得到的观察。要重新判断其中任一人的可判定性,需要回查那个人自己的深度与质量。不能把一个样本参考块里二十六的最低深度借给同一行里的其他人。
扩充队列后怎样检查旧样本的变化
先把原始样本名与新表头核对,再限制相同参考、相同分析区间与可比较的过滤条件。结果可以分成完整键相同、同一起点但等位集合改变、附近可能重写以及真正新增的候选。对简单单碱基位点,查看加入者是否有替代支持,原队列成员是否有覆盖该点的参考块。对复杂插入缺失,保存拆分前的原始行,再在同一参考上做规范化。若落在串联重复中,必要时比较局部单倍型。一条基因型写了二号等位,含义取决于本行替代列表的顺序,两份文件中同一个整数未必指同一段序列。
这个对照还说明,向队列中增加一名携带者后,原先没有报告的坐标可以产生整行新结果。要计算该位置的携带比例,应使用该位置上能够判定的样本数,写清如何处理缺失和部分缺失。如果要比较两批统计值,尽量把两批样本放回统一的等位集合中重新分型,或者明确限定到可比的位点和基因型。直接对照两份版本不同的队列变异列表,往往会把表示改变误认为检测灵敏度变化。
扩展到更多样本时,可以保留两份小队列作为回归样例。团队若要在同一环境中集中管理样本 gVCF 并反复联合分型,可使用云生信的生物信息分析服务器。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)