
一份变异注释表里,同一个染色体位置既写着错义变异,又写着内含子变异,究竟该删去哪一条?先看这两个结论分别属于哪个转录本。我们安装 SnpEff 5.2b,建立了一个只有一条染色体、一个基因和两个转录本的小型注释数据库。两个转录本共享首尾外显子,其中一个多含一段编码外显子。在这段序列上只改一个碱基,两个结论果然同时出现。再把变异移动一位,错义变成同义,而另一转录本上的内含子注释保持不变。这个例子可以直接用密码子表验算。
先把参考序列与转录本画在同一张纸上
人工染色体长一千碱基,两个转录本都在正链。长转录本包含三个外显子,坐标是一百零一至一百三十、二百零一至二百三十、四百零一至四百二十一。短转录本保留第一段和最后一段,中间整段在它的成熟转录本中被跳过。我们设置了完整的起始和终止密码子,所有编码块长度都是三的倍数,GFF 中的编码相位按这个模型设定。这让注释差异可以归到外显子选择,而不至于同时混入移码、方向和不同起始位置。SnpEff 官方自建数据库说明
对基因组变异而言,参考碱基和替代碱基由基因组坐标固定。转录本坐标和蛋白结果需要沿各转录本自己的编码路径计算。同一基因名只是告诉读者这些转录本属于同一基因,不能代替转录本编号。结构不同的两个转录本,有时给出相同的蛋白变化,有时一个根本没有可计算的蛋白变化。整理报表时应保留基因组变异键、转录本编号和后果类型三层身份,再决定是以等位、转录本还是基因为单位汇总。
实跑经验|四个变异各有两条注释
我们把 FASTA 和 GFF3 交给 SnpEff 新建数据库,再通过其正式注释入口处理四个单碱基替换,最后从 VCF 的注释字段逐条拆出替代等位、影响类别、转录本、外显子序号与蛋白变化。除了目标位点,还选了一处共享外显子的同义替换和一处共同内含子的对照。每个变异明确放在参考中实际存在的碱基上。这个模型用于核对基因结构和阅读结果,没有用它做患者风险判读。SnpEff 输入输出与 ANN 字段文档
| 位置与变化 | txA,三个外显子 | txB,跳过中间外显子 |
|---|---|---|
| 112,T→A | 同义,p.Ala4Ala | 同义,p.Ala4Ala |
| 214,C→A | 错义,c.44C>A,p.Ala15Asp | 内含子,c.30+84C>A |
| 215,T→C | 同义,c.45T>C,p.Ala15Ala | 内含子,c.30+85T>C |
| 302,T→A | 内含子,c.60+72T>A | 内含子,c.31-99T>A |
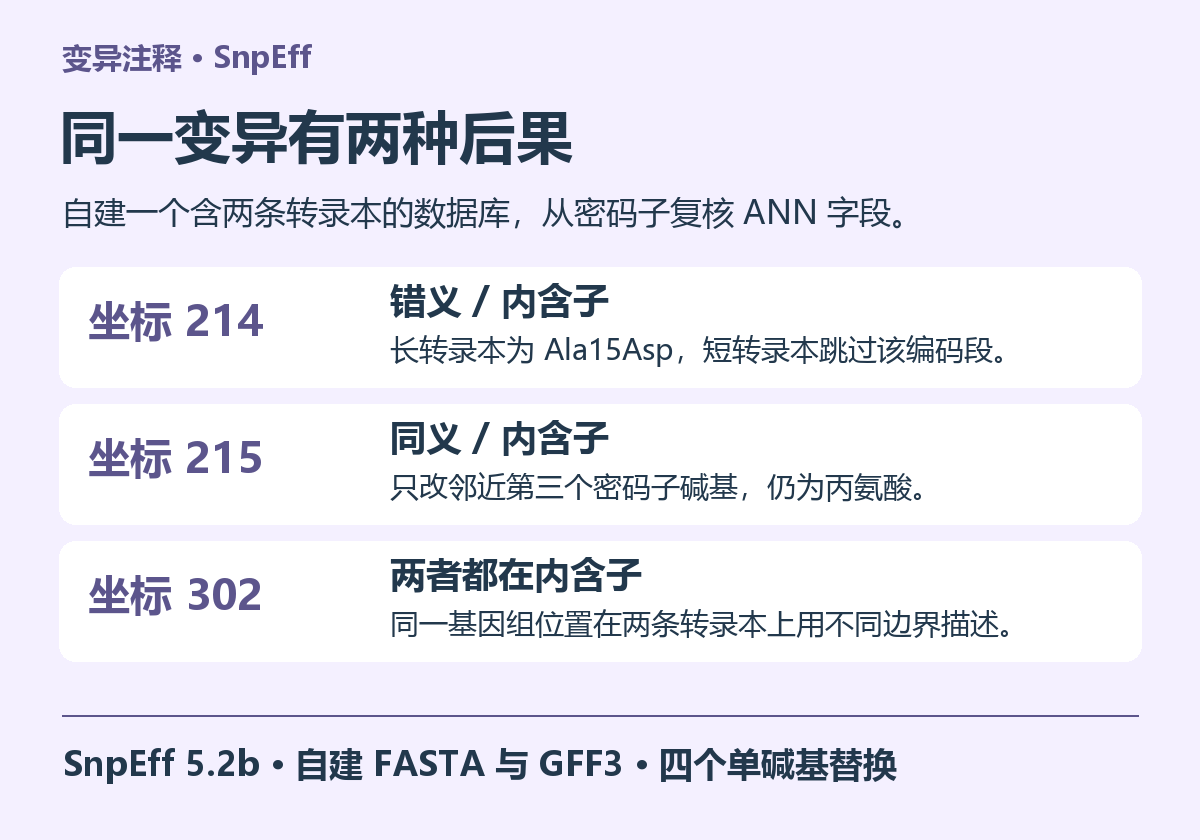
第二百一十四位在长转录本上处于第二个外显子。第一段编码三十个碱基,再从第二段起点二百零一计入十四个,得到编码坐标四十四。它位于第十五个密码子的第二个位置。参考密码子为 GCT,代表丙氨酸,把中间 C 改为 A 得到 GAT,编码天冬氨酸。再看紧邻的二百一十五位,改变的是该密码子的第三个碱基,GCT 变成 GCC,仍编码丙氨酸。软件给出的一个错义、一个同义,可以与逐字翻译一一对照。
短转录本在一百三十之后直接接到四百零一,因此二百一十四与二百一十五对它都位于内含子。相对于上一编码外显子末端,两者分别标为加八十四和加八十五,蛋白变化栏为空。这里的空值有明确的结构含义,不应在数据清洗时填成“蛋白未改变”。再看第三百零二位,两条转录本都给出内含子后果,但编码坐标一条从上个边界往后加七十二,另一条从下个边界往前减九十九。坐标表达不同不等于基因组位置不一致。
java -Xmx512m -jar snpEff.jar build -gff3 -noCheckCds -noCheckProtein -c snpEff.config toy
java -Xmx512m -jar snpEff.jar ann -noStats -c snpEff.config toy input.vcf > annotated.vcf
bcftools query -f '%CHROM\t%POS\t%REF\t%ALT\t%INFO/ANN\n' annotated.vcf
自建数据库与结果汇总各有哪一步容易出错
本例只有事先写定的编码序列和基因模型,所以建库命令显式跳过与外部编码序列和蛋白文件比对的两个检查,再用手算的已知密码子复核。正式给非模式物种建库时,如果注释提供方发布了配套编码序列和蛋白,应使用同一发布批次的数据执行这些检查。检查有助于发现组装版本错配、染色体名不一致、链方向或编码相位不对。遇到大量警告时,先挑一个结构清楚的基因从基因组翻译起,核对模型能否产生提供方的蛋白,然后再扩大范围。
注释结果还容易被“只保留最严重的一条”改写。第二百一十四位对长转录本的影响类别是中等,对短转录本则是修饰类。如果研究问题是“有哪些基因至少一个转录本发生氨基酸变化”,保留长转录本那条可以回答初筛问题。若目标是“研究组织中主要表达的转录本是否改变蛋白”,还要加入组织表达和转录本选择证据。如果直接删掉短转录本,就无法向读者说明为什么在另一个样本或组织里可能需要不同的解释。影响等级来自后果类别,不能凭等级单独推断疾病作用或蛋白功能损失。
构建汇总表时可以保存完整注释和一份按研究标准选出的代表结果,再给代表列注明选择理由,例如特定实验实际表达的异构体、固定公共转录本或项目预先指定对象。对多等位位点还要先看注释字符串的首栏对应哪一个替代等位。在真实的负链基因上,应确认变异的基因组方向与转录本方向,先做互补再翻译。保留能同时覆盖共享外显子、可变外显子和内含子的几个小样例,未来升级注释数据库时就有方法判别变化来自软件、基因模型还是输入变异。
选定基因模型后,若需对整个队列反复注释并保留转录本级结果,可使用云生信的生物信息分析服务器集中管理数据库与输出版本。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)