
对同一份 POD5 重新识别碱基后,读段名还在,序列却可能变长,平均质量也会变化。手工把 FASTQ 质量值相加再取平均,经常复现不出软件报告的数字。我们取 Oxford Nanopore 公开的一条真实原始信号,在本地用 Dorado 完整跑了两次碱基识别,分别使用快速模型与高准确模型。随后逐碱基重算整条读段的质量分数,并对照同一参考核算错配、插入和删除。下面的数字都可以从两份输出 BAM 中读回。官方单读段测试数据说明
让比较落在同一条原始分子上
这条信号来自公开样本 NA24385 的一号染色体区域,采用每秒五千个采样点的纳米孔测序条件。官方还给出一段人为加入了简并碱基符号的参考序列,用于自己的格式测试。我们使用同一个 POD5、同一份参考、相同软件版本与设备设置,显式指定相同版本系列下的两个模型。关闭可选序列修剪,两轮都直接输出带比对的 BAM。首先检查两次的读段标识完全一致,才能认定比较的是同一份原始信号。再看读组中的模型名称,防止自动选择版本或者中间文件串用让实验失去可比性。Dorado 模型和碱基识别说明
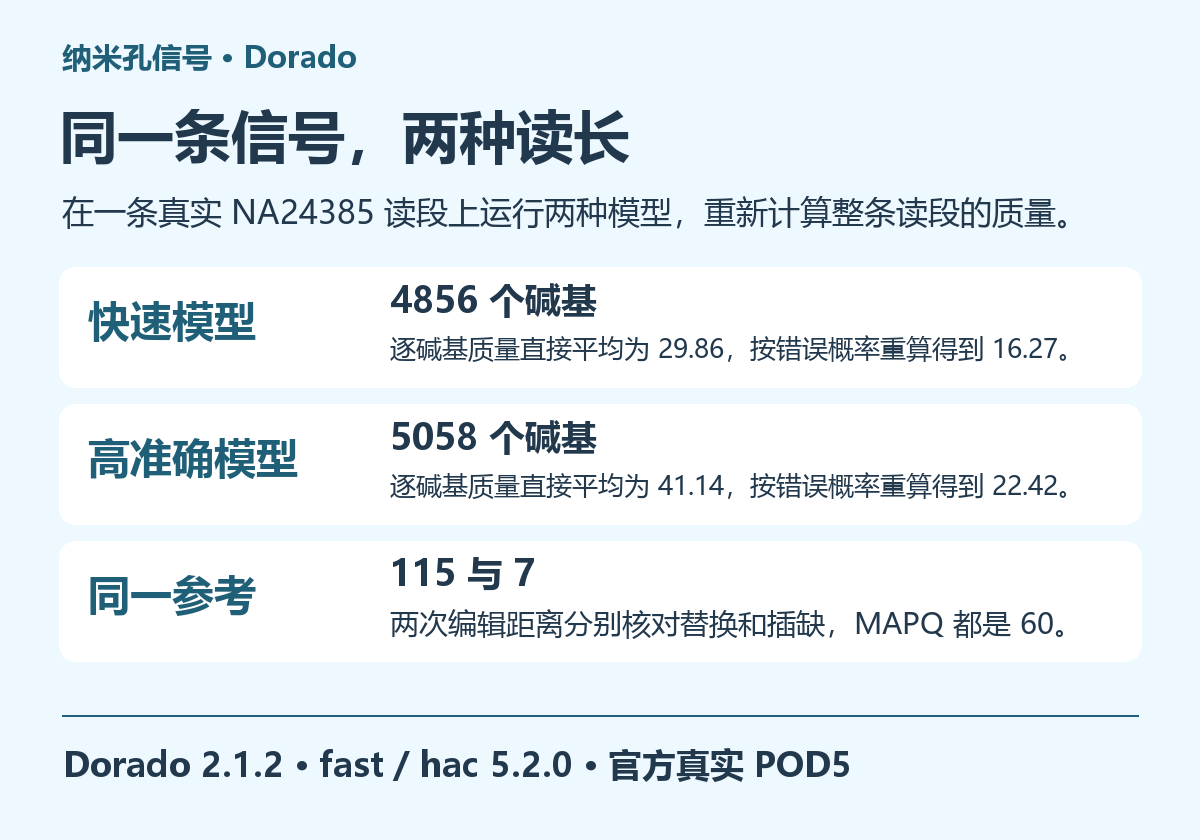
快速模型给出四千八百五十六个碱基,高准确模型给出五千零五十八个,相差二百零二。电流采样点和模型输出的碱基属于不同的测量单位,一段信号由多个采样点组成,模型需要推断其中的碱基顺序和数量。这里能直接确认的是同一读名得到不同的碱基数,不能光靠长度差判定快速模型恰好漏掉了二百零二个指定位置。要进一步定位差异,还得看两次输出各对齐到哪一段参考,剪切掉了多少,两边完全可比较的区间又有多长。
为什么直接平均质量值会高出十几分
一个碱基的质量分数是错误概率的负对数变换。取读段平均质量时,应该先将每个位置换回错误概率,把这些概率求算术平均,再转成一个质量分数。拿一半碱基质量为十、一半为三十的例子,错误概率分别为十分之一和千分之一,平均为零点零五零五。再转回质量大约十三。直接平均两个质量分数会得到二十,显著低估这批碱基的平均错误概率。这也是为什么一小段差质量序列能够拉低整条读段的平均质量,尽管余下的大部分位置质量都很高。
还要复现官方对序列开头的处理。对于长度超过六十的读段,Dorado 的整条质量统计先略去测序方向上的前六十个碱基。可以从 BAM 取回原始方向的逐碱基质量,只为这个统计量截去开头,再换算概率。这个步骤不会把输出 FASTA 的长度再减六十。实跑中,快速模型的逐位质量直接平均为二十九点八六,转换为概率并在全长求平均得到十六点零四,按官方规则略去开头后得到十六点二七,与 BAM 标签一致。高准确模型的三个数字分别为四十一点一四、二十一点七二和二十二点四二。Dorado 对平均质量的定义
| 同一条真实信号 | fast 5.2.0 | hac 5.2.0 |
|---|---|---|
| 输出碱基数 | 4856 | 5058 |
BAM 整条质量 qs |
16.2727 | 22.4214 |
| 直接平均全部逐碱基质量 | 29.8589 | 41.1394 |
| 比对区内替换、插入碱基、删除碱基 | 66、19、30 | 7、0、0 |
比对质量 MAPQ |
60 | 60 |
导出质量时还会遇到方向问题。以反向链比到参考的读段,在比对文件里给出的序列和质量可能已经随比对方向反转。略去前六十个位置时应从测序原方向开始。在实现时直接取恢复原方向的质量数组,再另行读取参考方向的比对列,便可使两个统计对应各自的坐标约定。
实跑经验|把质量估计与参考比对分开复核
dorado basecaller models/dna_r10.4.1_e8.2_400bps_fast@v5.2.0 chr1_MAT.pod5 --device cpu --no-trim --reference chr1_MAT_iupac.fasta > fast.bam
dorado basecaller models/dna_r10.4.1_e8.2_400bps_hac@v5.2.0 chr1_MAT.pod5 --device cpu --no-trim --reference chr1_MAT_iupac.fasta > hac.bam
samtools view fast.bam | cut -f1-6
samtools view hac.bam | cut -f1-6
快速模型输出中有五十九个软剪切碱基,另有十九个插入碱基,余下四千七百七十八个碱基与具体参考字母逐位配对,其中六十六处不同。用六十六个替换加十九个插入碱基、三十个删除碱基,得到编辑距离一百一十五,与结果标签吻合。高准确模型里五十五个碱基软剪切,其余五千零三个连续对齐到参考,按同样的方法数出七个替换,无插入或删除。两份结果的对齐碱基在这段参考上都未实际遇到简并字母。这里指的是同一分子的两份模型输出,参考比对给出可观察的差异,身份一致或比对质量很高都不能保证每个碱基正确。
这两次实际对齐的零基参考区间分别为 101 至 4909 和 100 至 5103,范围并不完全相同。若要比较模型在同一段序列上对某类碱基的识别,应先求两次参考区间的交集,再从比对路径还原参考坐标和查询碱基,分别报告替换、插入、删除以及被剪掉的端部。真实研究还要把可能的样本变异和参考本身的不确定性算进去。单条读段尤其不能估计模型在全基因组、其他化学版本、修饰碱基或同聚物上的平均性能。
实务上可以先抽取一批固定读名,保存原始信号校验值、流动槽与建库信息、模型的完整名称和筛选阈值,再做规模化比较。比如使用读段质量二十作为某次项目的筛选条件,这条读段会被快速模型排除、被高准确模型保留。若只统计过线后读段的平均长度,模型还会通过改变入选读段集合影响观察结果。把全部原始读名与两种模型各自的保留清单并列导出,就能区分一条分子本身被识别得更长,以及整批数据因换了分母显得更长这两件事。
当需要对多张流动槽统一重算并保留原始信号、模型与旧版识别结果时,可了解云生信的生物信息分析服务器。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)