
做混合组装时,MaSuRCA 可以把大量短读段的重叠信息整理为少数较长的 super-read。这里的长序列有实际碱基内容,可以作为组装证据,也很容易被误写成原始长读段。我们用四千四百对模拟短读段构建 super-read,追查每条较长序列来自哪段模板,又让三种图构建参数面对同一个五十六碱基重复。尤其值得复核的是,两个成功运行的参数各给出两条长序列,总长度很接近,但同一段真实序列被表示了多少次并不相同。MaSuRCA 作者项目与配置说明
先给重复区一个已知答案
构造一条长二万三千一百一十二碱基的线性模板,在三个不同随机序列段之间插入两份完全相同的五十六碱基序列。每对短读段来自同一个模板片段,两端各长一百碱基,片段长度围绕三百碱基变化。总输入八千八百个读段端、八十八万测序碱基。这个数除以模板长度是原始平均测序深度的近似值。把它和最终 super-read 总长度混用,会误以为后者没能保住输入碱基。模拟器反复从同一模板取样本来就制造了覆盖冗余,而构建长序列正是为了压缩这类重复观察。
实验只执行到配置允许的 super-read 生成阶段。输入的读段、文库片段均值与标准差、线程数和计数配置始终相同,分别用三十一、四十一和七十一碱基的短词长度构图。这里的短词长度描述识别局部序列的窗口,既影响哪些重复窗口会混在一起,也影响真实测序有错误时有效窗口的数量。我们的人工输入没有测序错误,并且含有一个刻意设计的重复,适合观察参数带来的差别。实际杂合或有错数据中,贸然增加窗口长度可能使原本就浅的覆盖断开,因此下面的数字只作为解释文件的对照。
先把两个正确的结果放到同一条坐标轴
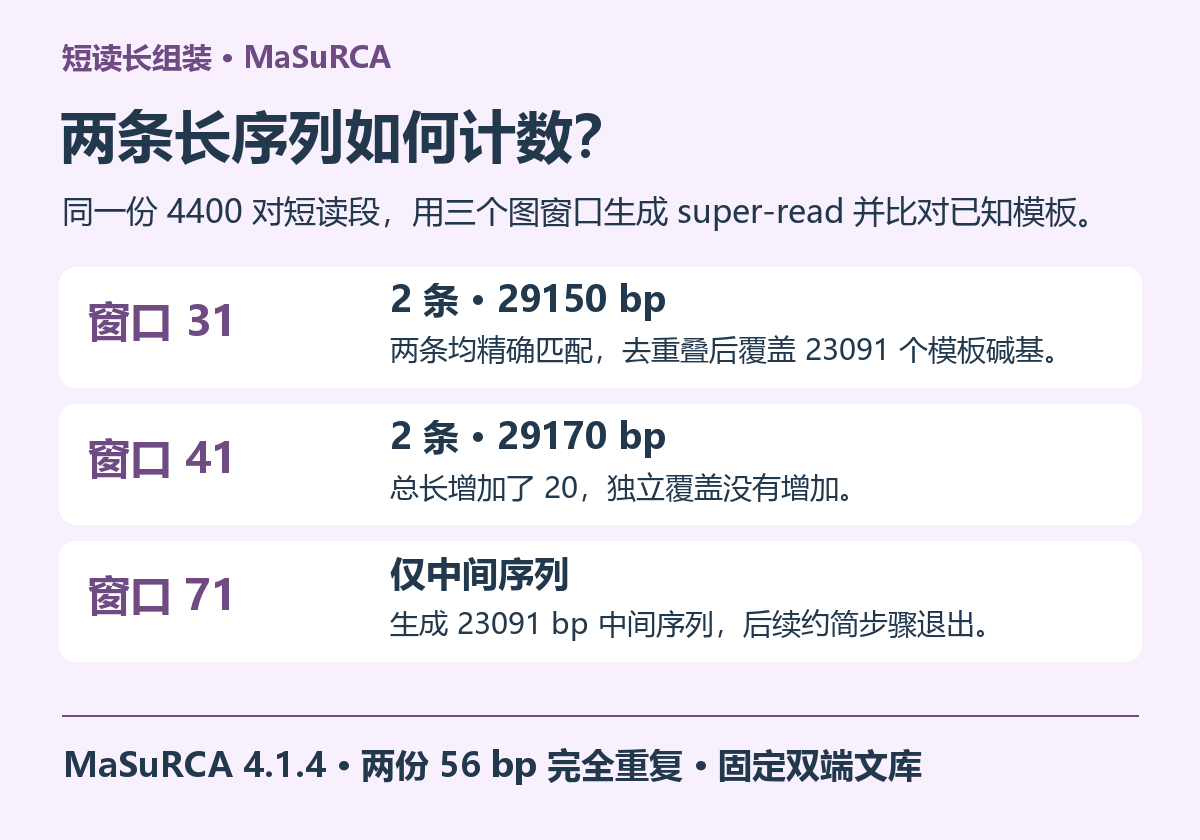
三十一碱基设置成功退出,最终 FASTA 里两条分别为一万五千零七十七和一万四千零七十三碱基,总计二万九千一百五十。将每条序列的正向及反向互补都放到已知模板上找精确匹配,两条都能逐字找到。两条覆盖的模板坐标取并集后只剩二万三千零九十一,差额是六千零五十九个重复计算的碱基。这个重复量远大于五十六,说明被两条输出共同表示的区域不止设计的那个小重复。不能把总长减去模板长度就当成基因组里新出现的重复拷贝。
把图窗口改为四十一时,最终仍是两条,每条比上一组长十个碱基,总长增加二十,但两条共同覆盖的独立坐标数完全相同。以真实模板作分母,两种设置都还有二十一个位置没有被最终长序列覆盖。哪一组更适合后续,不能只看哪一个总长更大。若目的是问特定基因区段是否被覆盖,可查独立坐标并集。若目的是问两个远端位点能否可靠连接,就要找管线里支持该路径的短读段配对及方向,必要时再用独立长读段跨过接头。这里没有输入任何真实长读段,不能把重叠构建出的两条序列计为两份独立的长分子证据。
| 图窗口 | 阶段退出 | 文件里的序列长度 | 精确比回模板的独立碱基 |
|---|---|---|---|
| 31 | 成功 | 15077、14073 | 23091 |
| 41 | 成功 | 15087、14083 | 23091 |
| 71 | 退出码 1 | 中间文件一条 23091,最终步骤未完成 | 23091,按中间序列计算 |
报告中再给出最长一条序列占模板的多少,也有助于发现分母错误。某些工具会把产物当作新的输入集合重新统计覆盖深度,如果把已经合并的共识序列每条只赋一票,结果描述的是路径的条数,无法恢复原来有多少片段提供了支持。
实跑经验|目录里已有 FASTA,仍需检查是哪一步写的
DATA
PE= pe 300 18 /data/R1.fastq /data/R2.fastq
END
PARAMETERS
GRAPH_KMER_SIZE=31
STOP_AFTER_SUPERREADS=1
USE_LINKING_MATES=0
NUM_THREADS=2
JF_SIZE=1000000
END
运行时先用 MaSuRCA 读取上述配置生成组装脚本,再在相应目录执行脚本,每组参数用独立目录。七十一碱基那轮前段也成功生成了比对放置记录和一条中间序列,长度正好是二万三千零九十一。继续运行时,后面的约简程序给出的临时输出是空文件,驱动脚本要求该文件至少有一个字节,因此返回失败。我们直接检查具体日志、阶段标记和实际文件路径。此处可以验证中间那条序列与模板相符,不能把这轮描述成成功产出最终 super-read,更不能拿它当作完整基因组组装。本次使用的 MaSuRCA 4.1.4
最容易误判的情况是,只统计目录里最大的 FASTA,或只查文件名中有没有成功标记。程序在不同子步骤都可能留下成功标记,早期成功与晚期失败可以同时存在。核验时先把主程序退出状态写进表,再分别登记进入统计的文件路径和计算口径。对于差异最大的那一轮,重新算一遍独立基因组坐标覆盖,再比较读段放置记录的行数。本例三轮的放置文件都是八千七百九十八行,这不代表它们构出了相同数量的最终长序列,也不能把行数直接换算成完整保留的配对数。
真实数据缺少已知模板时,可以换成两项外部证据。第一项从未参与组装的高准确读段中抽取跨接分子,检查长序列中候选连接点的两侧是否都能唯一锚定。第二项对新序列间做相互比对,画出长范围重叠的片段再统计总长度。拿到这两份结果,才能回答一段变长的 super-read 代表更多已验证的连接,还是只把两条输出共有的区间略微延长了。原始双端读段、配对信息与实际构图参数这三份材料都值得与最终产物一起保留。
当多份样本需要同时保存原始双端文库、多个图窗口的中间序列与独立验证结果时,可以使用云生信的生物信息分析服务器开展批量组装。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)