
把短读长和少量长读长交给混合组装流程,结果里往往能看到更少、也更长的片段。是否能由此宣布又有一条质粒完整闭环?我们用 Unicycler 作者公开的志贺菌质粒模拟数据做两轮完整组装。加入三十条长读段后,最长的连续片段变长了近一万碱基,但两轮被软件明确标记为环状的都是同一条小质粒。中等大小的那条究竟差在哪里,可以从三个地方看出来,分别是输入的长读段数、每个质粒上最长的实际比对和最终的环状标记。Unicycler 官方公开样本说明
用三个可分别检验的参考分子做对照
作者提供三份已知质粒序列,长度为二十一万五千七百七十四、八千九百五十三和五千一百五十三碱基。配套的双端短读段每端都有五万零二百条,每端一百二十五个碱基。另有一个低深度长读段文件,仅三十条,总计二十六万一千六百四十九碱基。把这个总量除以三条参考合计的二十二万九千八百八十,得到名义平均约一点一四倍。这个除法没有保证三条质粒的实际深度一致,更没有保证关键重复的两侧都被独立分子跨过。
第一轮只输入成对短读段,第二轮在原样的同一对文件上增加这份长读段。两轮都用 Unicycler 0.5.0 和 SPAdes 3.15.5,以相同参数执行,允许程序为短读段选择合适的短词长度。两个输出目录相互独立。我们另外保存了输入文件的校验值,避免名称相近的高深度与低深度长读段文件用反。参考序列从头到尾只用于验收,没有被送进组装流程。这样才能区分数据本身支持的结果与验证者根据已知参考额外补出的连接。Unicycler 混合组装流程
连续性与闭环要各填一栏
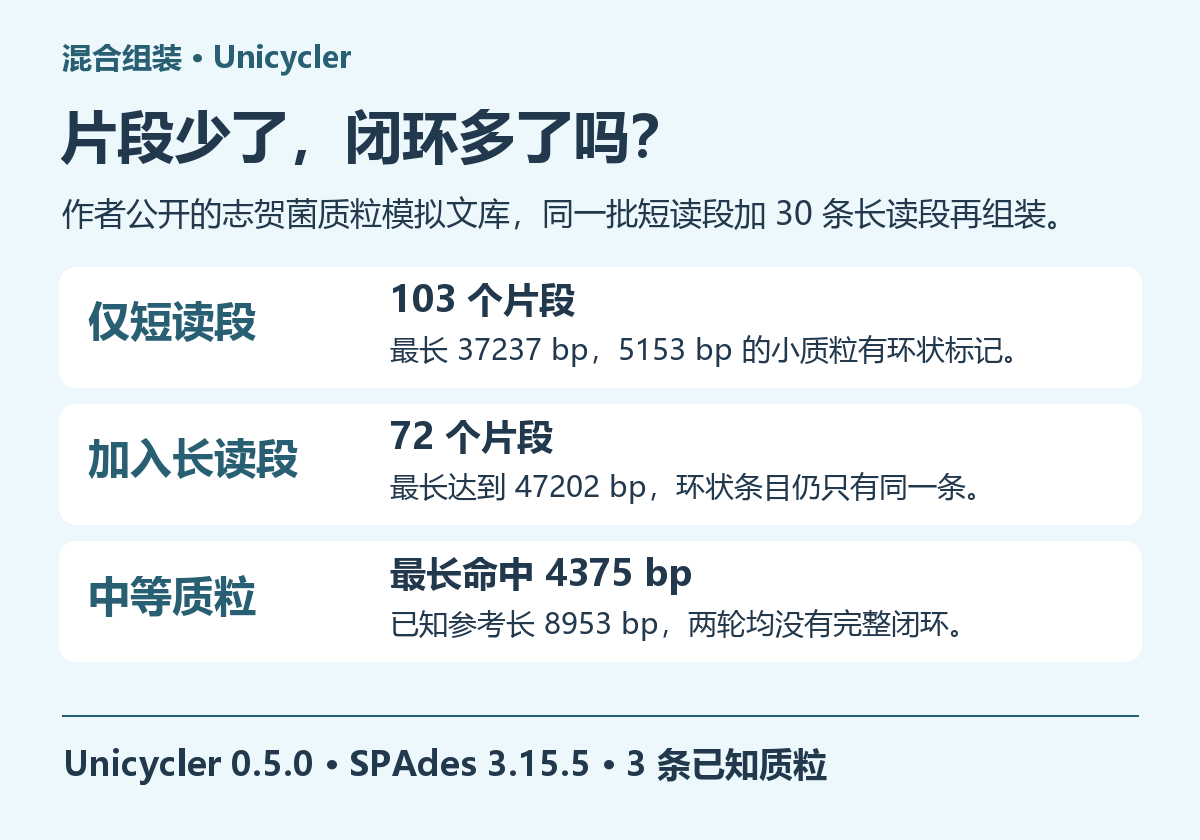
纯短读段组装得到一百零三个 FASTA 条目,总长十八万七千一百二十四碱基,最长三万七千二百三十七碱基。加入低深度长读段后得到七十二条,总长二十一万一千五百碱基,最长四万七千二百零二。少了三十一个条目,总长却增加,是因为片段数量、彼此连接的方式以及保留的序列范围都可以改变。表中把最长条目和环状条目数放在相邻两栏,读者可以自行判断连续性提高的同时,有多少新的连接直接支持了闭环。
两轮的环状条目数都是一,长度也都是五千一百五十三。纯短读段文件里的它编号十一,混合组装里编号十。把序列比回已知参考,两轮的五千一百五十三个比对列均完整匹配最小质粒。文件序号在重新排序时会改变,跨轮比较应按参考或独特标记确认身份。中等质粒的长度为八千九百五十三,两轮中分配给它的最长比对却都仅四千三百七十五,覆盖不到全长的一半。不能因为另一条长达数万碱基的片段变长,就把这份进步记在中等质粒名下。
| 同一批双端短读段 | FASTA 条目 | 最长条目 | 明确标为环状 | 中等质粒上的最长比对 |
|---|---|---|---|---|
| 仅短读段 | 103 | 37237 bp | 1 条,5153 bp | 4375 bp |
| 增加 30 条长读段 | 72 | 47202 bp | 1 条,5153 bp | 4375 bp |
比较多份样本时,可以为每条候选复制子建立独立记录,列出序列长度、支持它的图边、跨接读名及可唯一比对的侧翼。若某个短序列能比到多个质粒共享的插入序列上,记录里保持多重归属,先不要按片段编号把它定给样本中的某一条质粒。只有跨过重复并进入独特区域的长读段,才可能帮助区分这些候选连接。
实跑经验|逐条质粒查序列和桥接证据
unicycler -1 short_reads_1.fastq.gz -2 short_reads_2.fastq.gz -o short -t 3 --keep 1
unicycler -1 short_reads_1.fastq.gz -2 short_reads_2.fastq.gz -l long_reads_low_depth.fastq.gz -o hybrid -t 3 --keep 1
grep '^>' short/assembly.fasta | grep 'circular=true'
grep '^>' hybrid/assembly.fasta | grep 'circular=true'
minimap2 -x asm5 --secondary=no -c truth-double.fasta hybrid/assembly.fasta > hybrid.paf
为了让环形序列能从任意碱基写起,我们先把每条参考首尾串联成两份,再进行全基因组比对。每个查询的最长比对仍以单份参考的真实长度为分母。在大质粒上,混合组装的最长片段共有四万七千二百零二个对齐列,其中四万七千二百零一个完全匹配。它既比纯短读段中最长的大质粒片段更长,又能追溯到明确的位置。小质粒则拥有一条等于全长的序列、完整参考比对以及环状标签。三种证据分别登记,比只收集每个组装的总长或者只截一张图更容易复审。
检查桥接日志时,三十条长读段都有某种对齐,其中三条被记为完全对齐,二十七条为部分对齐。读段有比对不等于形成一条可用的桥。想证明两个锚定片段相接,需要查看一条读段是否连续落在这两端、两边有没有足够的独特序列,以及是否还有相似重复给出竞争路径。程序也可能综合几类桥,最终按质量应用选择。某个样本所有长读段都比得上,仍可因为覆盖太偏或者重复太长而留下分支。
作者的样本说明提到其低深度示例可以完成中等质粒。我们在这里列出的版本组合、默认流程和这三个校验过的输入文件上没有复现这一项,只复现了小质粒闭环。已有两轮数据足以具体指出差异,但不足以把原因归给某一个版本或算法步骤。若要继续比较,可把同一批输入递交给另一组已记录的依赖版本,先确认选择的短读段图和待桥接端点是否一致,再比对各条长读段的桥接选择。就本轮交付而言,保留对不上预期的结果,比照着示例说明填写第二个环更有价值。
当多个菌株都需要集中保留短读段图、长读段桥接日志和每条质粒的复核结果时,可以了解云生信的生物信息分析服务器。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)