
用 Clair3 调长读长小变异时,有人会拿第一阶段的位点数乘一个比例,预估第二阶段会精查多少个位点。在有二十行输入、比例设为百分之三十的测试里,这种算法会给出六个。我们从作者发布的 2.0.5 版实际调用质量阈值计算和候选选择两个步骤,得到的却可以是两个、四个或六个。差异能追踪到具体位点,实验也能解释为什么只看命令里的比例容易误判。Clair3 官方项目
先分清这个比例用在哪里
长读长比对在多数位置提供一致的碱基证据,另一些位置可能有同聚物、附近插入缺失或两条单倍型交叠的复杂模式。Clair3 先利用 pileup 表示作初步判断,再把部分难以判断的位置交给能够利用更多读段细节的全比对模型。送往后一阶段,是流程选择对哪个位置多看一遍。这个比例本身既不能解释为最终阳性占比,也不能拿来要求最后的变异表必须删掉或留下多少行。作者发布的候选选择程序
第一阶段报参考型的位置也可能值得多看一遍。如果一个位置的读段支持不一致,初步虽选了参考,模型也可能给出较低置信度。因此流程里分开处理初判为变异的一组和初判为参考的一组。我们的实验给两组各十行,分别设置百分之三十,保留软件原本的输入格式。真实数据中两组通常大小不同,想知道有多少位点进入下一步,应先把这两个分母分开记录。作者发布的质量阈值计算程序
实跑经验|固定二十个位置,只改阈值附近的同分情况
第一套人工输入中,十个初判变异的最低几档质量依次是六、八、八、八,其他均高于八。十个初判参考最低为二、四、四、四,其他都高于四。第二套只把这几个分数打散,变异端最低四档改为六、七、八、九,参考端改为二、三、四、五。两套数据的坐标、初判等位、基因型和每组行数完全相同。每个位点间隔三百碱基,以便从输出区间独立对应回输入行。
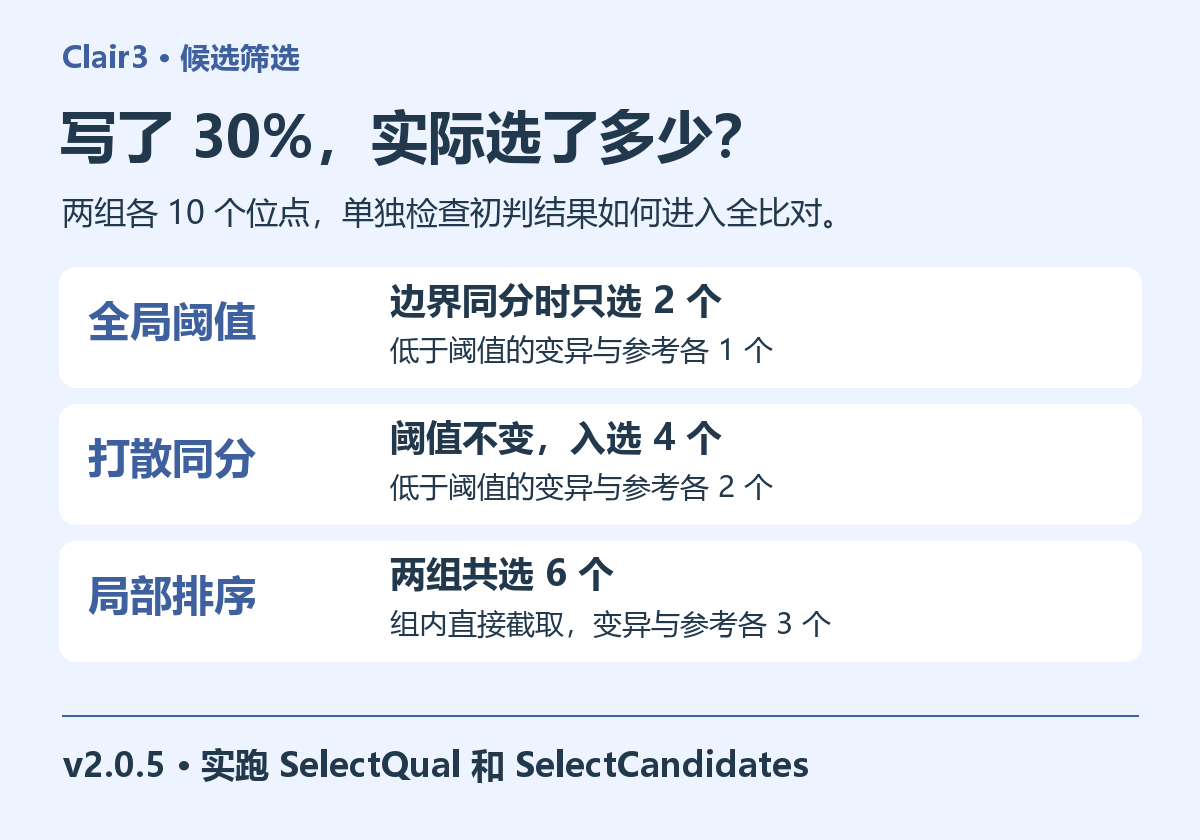
我们先让 SelectQual 对整份输入求阈值并写入选区目录,再执行 SelectCandidates。两套输入的阈值都是变异八分、参考四分。然后用另一个空目录运行同一候选步骤,让程序走没有全局阈值文件时按组内排名选取的分支。两种路径都来自同一份原版程序。实验范围到送入全比对的候选区间为止,本次使用人工构造的初判表,没有运行神经网络推理或评价最终变异准确率。
| 初判质量分布 | 已有全局阈值时,变异 / 参考入选 | 无全局阈值文件时,变异 / 参考入选 |
|---|---|---|
| 阈值附近多人同分 | 1 / 1 | 3 / 3 |
| 阈值附近打散为不同分数 | 2 / 2 | 3 / 3 |
解释数字时,把十个变异的分值从小到大写下来。拿排在前百分之三十的前三项求边界,最后一项是八。这个版本随后用的是“质量严格低于八”来选择有全局阈值时的候选。第一套里只有六分满足,第二套有六分和七分满足。参考端完全类似。没有全局阈值时改为把输入排序、直接截取前三项,因此即便边界上多人同分,数量仍能取满三条。同样是百分之三十,一个在估计分值边界,另一个在截取预定条数,阅读代码和查看输出才能知道实际走了哪条路径。
为什么少了一个候选,值得沿文件追下来
先区分没进入精查和最终没有被报告。一次流程可能继续保留合格的第一阶段调用,你在精查区间里没看到某个位点,不能由此直接推断最终文件会没有这行。反过来,已经进入精查也只表示算法为它计算额外证据,未必确认有变异。追踪单个位点时应同时查初判文件、阈值文件、精查区间、全比对结果和最终合并文件,记录它在哪一级改变了状态。这样才知道要检查证据提取、质量边界还是合并输出。
mkdir -p selected
gzip -dc pileup.vcf.gz | python3 clair3.py SelectQual \
  --output_fn selected --var_pct_full 0.30 --ref_pct_full 0.30
cat selected/qual
python3 clair3.py SelectCandidates --platform ont --ctgName chr1 \
  --pileup_vcf_fn pileup.vcf.gz --split_folder selected \
  --var_pct_full 0.30 --ref_pct_full 0.30
对自己的项目,先数被分析染色体上初判参考和变异的有效条数,为两组各列出低于阈值、恰等于阈值以及高于阈值的数量。若等号处堆了很多整数化的质量值,计算严格小于的条数常能直接解释差距。再确认阈值是全样本产生,还是仅取目标区做了缩小测试。单个染色体的分数分布与整个样本不同,只用它的小分布去推全局入选率,会混入分布差异。在已有运行目录中试验还要为每次运行用独立子目录,旧的阈值文件本身就会改变这个步骤的行为。
记录分数时保留原始小数。人眼从日志里看到的整数阈值,可能只是用于显示的四舍五入,而程序实际从阈值文件读回更精确的浮点数。若两个位置分别落在边界的两侧,手抄日志为整数再作比较,就会制造一组根本不存在的“同分”。本例刻意用整数方便手算,换成真实样本时应保存原文件再做复核。
怎样评价调大比例有没有帮助
可以先固定一段带独立真值的区域、平台模型、测序样本及软件版本,分别运行两个待比较的比例。记录的是新增精查了哪些坐标、其中哪些真正纠正了错误、哪些原本正确的初判被改错,再按单碱基变异与插入缺失分层。如果目标是救回同聚物附近的缺失,进一步给这些位点单列结果,避免全区域的平均数掩盖目标区域变化。用这类交叉表把入选数量与最终召回、误报联系起来,比仅汇报后续多算了多少个位点更有解释力。
下载本篇实验脚本与结果(12 篇合集 ZIP),解压后打开 077-clair3 目录。
多批长读长项目需要复核初判到精查的中间文件时,可以在云生信的生物信息分析服务器保留每批模型、阈值和候选区间,方便逐位点回看。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)