
宏基因组组装完成以后,目标菌靠培养检出,拼出来的序列里却找不到它。最容易做的一步是降低组装阈值,最难回答的是得到的那段序列究竟多了什么证据。还有一种常见情况,两个条件下都只见一条长序列,项目汇总表上的最长序列和总组装长度接近,看起来差别很小。若关注的是混合物中排在后面的目标,这些汇总指标很可能完全由优势成员决定。我们用两条已知来源的序列做了三轮组装,让被过滤的读段、拼出的片段和真正覆盖到的参考位置能一一对上。
先把“没有拼出来”改成可以检查的问题
一段参考序列要作为足够长的片段出现在最终文件中,至少涉及三层判断。原始数据有没有覆盖这段序列,覆盖它的读段之间能不能连续接上,最后形成的路径有没有达到输出要求。一次分类或局部比对命中,只能回答第一层的一部分。来自同一条基因的两段互不衔接的读段,也能让分类报告出现相应物种的名字,它们之间若有几百个碱基完全无人读取,组装就缺少恢复中间序列的直接依据。先定位缺的是哪层信息,再决定查看输入还是调整参数。
MEGAHIT 使用一系列不同长度的短序列词构建简洁的德布鲁因图。理解参数时可以先在纸上把一条读段拆成长度固定、每次移动一个碱基的小窗口。相邻读段若在同一位置相互覆盖,就可能提供重复出现的短词。过滤低支持短词可以减少测序错误造成的分支,也会使真实但采得很浅的区域失去连接。第一轮建图的最低出现次数、后续各轮使用的词长,以及最终输出片段的最小长度分别处在不同阶段。把三个参数混称为“覆盖阈值”,很难向另一位分析者解释为什么两条命令得出了不同序列。MEGAHIT 原始论文 · 作者仓库与命令说明
实跑经验 · 同一份稀疏输入先跑两次,再补一份较密输入
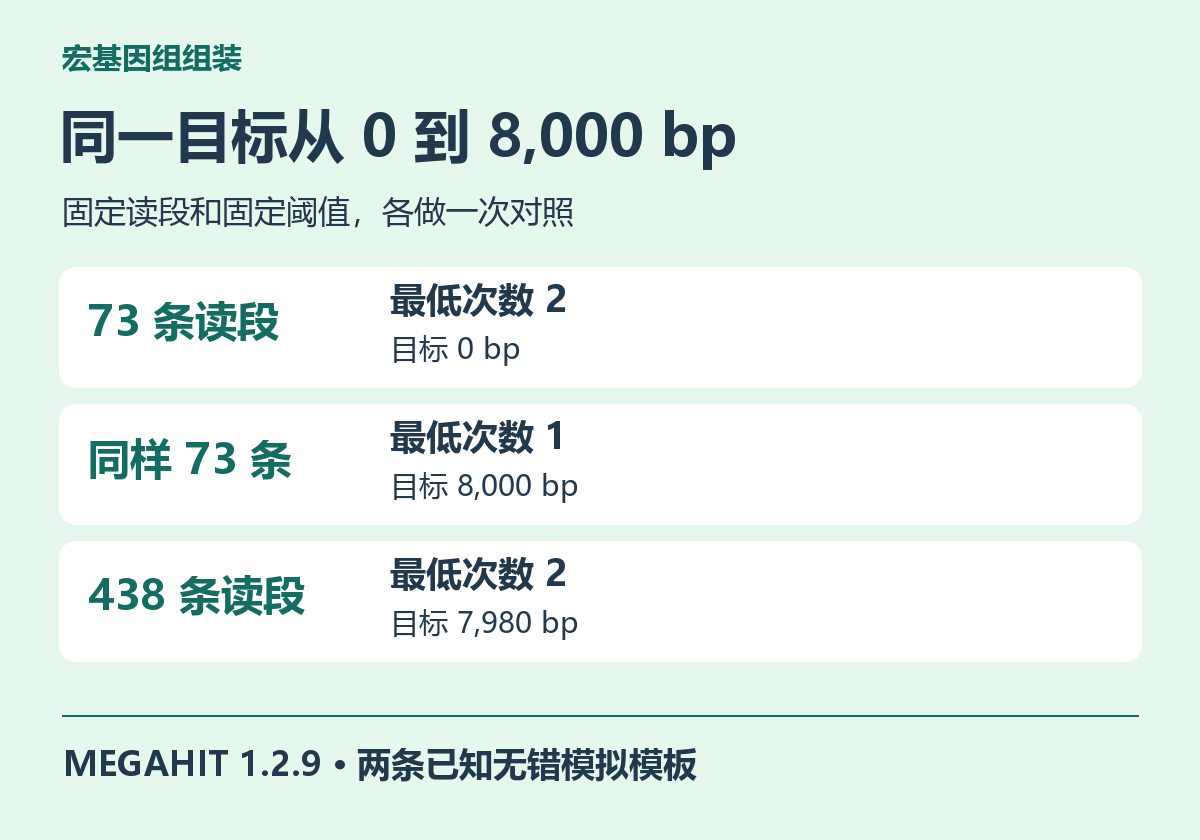
用固定种子生成两条互相独立的线性模板,长度分别为一万二千和八千碱基。两者使用相同的碱基抽样规则,读段均为单端一百五十碱基,没有加入测序错误。优势模板在三轮都提供两千九百六十四条读段。稀有模板的稀疏输入提供七十三条,增加覆盖后的输入提供四百三十八条。起点沿参考规则取样,两端也都有读段,因此本例里知道每条模板从哪里开始、到哪里结束。真实样本读段起点和错误会更不均匀,这一设计专门用来分开两个参数的作用。输入生成器、运行脚本与实测结果
实际运行 MEGAHIT 1.2.9,固定词长列表、最短输出长度和线程数,关闭补救低支持短词的 mercy 选项。第一轮用稀疏输入且最低出现次数为二,第二轮沿用同样的输入只把次数改为一,第三轮恢复次数二,只增加稀有模板的读段。只有第一轮分别与第二轮、第三轮比较,才各自只动一个条件。若把第二轮直接和第三轮相比,输入和算法设置同时改变,就难把结果归到其中一个因素。复跑时每轮给一个新的输出路径,方便把完整日志连同各自的最终文件一起保存。
python3 105-megahit/run.py "$(command -v megahit)" work105
# 以下为第一轮由脚本实际执行的等价命令,另选新的输出目录
megahit -r work105/sparse_min2/mix.fastq --k-list 21,31,41 \
  --min-count 2 --no-mercy --min-contig-len 200 -t 2 -m 1000000000 -o first_again
| 条件 | 稀有模板读段 | 最低出现次数 | 输出片段数 | 优势模板覆盖碱基 | 稀有模板覆盖碱基 |
|---|---|---|---|---|---|
| 稀疏输入 | 73 | 2 | 1 | 11,994 | 0 |
| 同一稀疏输入 | 73 | 1 | 2 | 12,000 | 8,000 |
| 增加稀有模板读段 | 438 | 2 | 2 | 11,994 | 7,980 |
表中的覆盖量按参考坐标的并集计算。脚本读取每条最终片段,尝试在两条设计模板的正向及反向互补序列上放置,只有能完整精确归到一条模板的片段才计入。然后把落在同一参考位置的碱基只计一次。三轮输出都能精确分配,未归属或方向与归属不唯一的最终片段计数为零。如果换成近缘菌株,有的片段可能同时适配多条参考,那时应保留“多处可放置”的一栏,不能把同一片段的全长分别加给每个菌株。
稀疏模板其实从头到尾都有读段,为什么还能归零
稀疏模板的大多数相邻读段起点相隔一百一十个碱基,每条读段长一百五十,二者之间有四十个碱基重叠。一张只标记“这个位置有没有被任何读段盖住”的图,会显示模板基本上从头到尾都有数据。若换一个问题,标记“这里一个长度二十一的短词有没有被两个独立的相邻读段观察到”,图形就会出现一段有支持、一段只有单次观察的周期。读段覆盖的连续性没有自动变成较高阈值下的图路径连续性。第一轮最后没有一条至少二百碱基的稀有模板片段,并不意味着那七十三条输入消失了。
可以按输入碱基数除以模板长度估算平均测序深度。稀疏条件为七十三乘一百五十再除八千,约一点三七倍。增加读段后约八点二一倍。优势模板三轮都约三十七倍。平均值对说明两份输入的数量级有用,却不能替代逐位置覆盖。例如在相同平均深度下,把大部分读段集中在同一个保守基因,会留下大片空白,把起点均匀铺开,会得到另一种图。当前示例明确规定了起点,真实项目则要靠读段回贴图来观察这种分布,还要查低质量末端和接头修剪后究竟保留了多少有效碱基。
第二轮把最低次数调到一后,八千个碱基全部出现在一条与稀有模板精确吻合的片段中。这个结果说明,在已知无错输入、已有足够重叠、关闭补救选项的组合下,放宽首轮过滤允许了真实路径通过。它不能给现实样本推出通用的最佳参数。现实的一次性短词里还包含错误和低复杂度干扰。对序列正确性没有真值的样本,单靠降低阈值后多出来的总长度无法判断新增片段的质量。报告应写清新增部分有多少支持、支持落在哪里,以及每个连接处是否有多个独立起点的读段跨过。
第三轮恢复较严格设置,补足稀有模板的读段后,最终只差二十个参考位置。优势模板在同样阈值下两轮都是一万一千九百九十四碱基,这也给了实验一个内部对照。若只盯着优势模板,会误以为加读段没有作用。若只比较全局最长片段,会把真正变化最大的目标埋在后面。针对特定目标的比较,至少要同时给出每个目标的可定位长度、最长连续匹配和未覆盖区段的位置。末端少了几个位置与中间断开同样多的位置,对引物设计或完整开放阅读框的影响可能完全不同。
在没有完整真值的样本里怎样检查新增序列
先把同一批清洗后的原始读段分别回贴到两种设置得到的片段。以新增目标片段为单位检查三件事,逐位置深度是否有长空洞,两端是否被不同起点的读段覆盖,以及声称连接两个区域的边界上是否真的有跨越读段。对双端文库,可以进一步查看连接两端的读对是否来自同一样本、方向和片段长度是否与主体分布一致。容许多处比对时还应标注唯一比对的比例。只有一些高度保守片段密集叠在核心位置,与沿整条目标散布的独立证据,在生物学解释上相差很大。
再检查新增片段是否只在同批次的阴性对照中也以相似方式出现。对于团队特别关心的低丰度对象,把它与近缘参考一起比对,寻找能够区分成员的位点,记录每个位点的碱基质量、比对质量、正反链和独立读段数。如果新序列只覆盖所有近缘菌共有的核糖体片段,仍然可以报告检测到相近类群的序列,要把结论细化到某一物种或菌株,需要额外的可区分区域。这个检查针对目标的分类归属,与前面判断一条组装片段是否连续解决的是两个不同问题。
还要弄清样本之间有没有合并。多个样本合并组装,可能让原先低支持的目标积累足够观察,也可能把近缘菌株在相同骨架上的差异叠在一起。若改变的是哪些样本参与组装,就保持其他参数不变,并在合并所得片段上单独统计每个样本的回贴覆盖。假如一条新片段只由一个样本贡献绝大多数证据,项目报告应把该样本标出来。分样本判断哪些区域稳定覆盖,比把合并输入的总深度当成每个样本各自的证据更有价值。
如果手头只有最终序列,仍可做一个廉价的检验。先把两轮结果彼此对齐,找出新增的内部片段、外延的末端和被拆开的区域,分别记录坐标。外延几十个碱基需要查的是尾端质量和新末端的覆盖。两块原先分开的序列突然连成一条,需要查的则是新增接合处两侧是否同时被独立读段支持。两条旧序列都对到新序列的同一保守区,不能直接证明它们应当合并。这种按变动位置分组的检查能把回贴工作集中到真正改变解释的少数位置。
评价一次试验还应保留失败的判定口径。如果输出文件里没有合格长度的目标,而中间图仍留有较短路径,可以将目标记为“低于输出门槛”,并注明依据。若输入深度图已经有长缺口,就将它记为“缺乏序列证据”。两者后续所需的补救截然不同,在实验记录中给它们单独留一列,下一次增加读数后也能逐个复查。
怎样把试参结果交付给后面的分析
建议把每轮的输入清单、软件版本、词长、最低出现次数、补救设置和最短输出长度放在同一张记录表内。在参考已知的阳性对照中,附上每条模板的覆盖并集和无法唯一归属的片段数。在真实样本中,再补目标片段的回贴曲线、跨边界支持和分类分辨力。如果组装被用于后续分箱或基因预测,额外报告有多少新增片段真正通过了下游的长度过滤。否则上游多拼出来的短片段可能根本没有参与最后结果,分析者却会误把后续的一点变化归功于它们。
复核到最后,可以把结论写得非常具体。例如本次七十三条无错读段在较低阈值下恢复了完整八千碱基,同一阈值收紧一档后没有长于规定门槛的对应输出,而增加目标读段又在较严格条件下恢复了几乎整个模板。每句都给出了比较对象、参数和判断依据。这种写法比公布一套所谓最优配置更便于同行复核,也让后来的实验知道下一次应该补足读段、检查输入质量,还是继续评估参数造成的差别。
需要把这类对照扩展到多样本联合组装时,可带上试跑的输入规模和各轮输出量,和云生信生物分析服务器团队估算工作空间。


