
分箱结果中的一条长片段,看起来属于某个基因组箱,里面却出现与其余成员不一致的分类信号。排查时除了看聚类模型,还要追踪子片段标签如何合回原始序列。CONCOCT 的常见流程会先切长片段,计算每个子片段的组成与覆盖,再把标签合回去。若原始片段本身连接了不同来源的区段,前面的局部分组可能准确揭示了矛盾,后面的合并又会把整条片段交给其中一个箱。我们用两个明确设计的嵌合片段,实际跑完切片、聚类、合并和序列提取,观察这一步到底发生了什么。
切片解决了什么问题,又留下了什么问题
长片段包含的碱基更多,序列组成估计通常更稳定,但长度差异很大的片段放在同一聚类流程中,也可能让信息尺度不一致。CONCOCT 的标准用法包含按固定长度切片,再为这些子片段生成样本覆盖表。这样可以用局部组成和局部覆盖描述一条长序列的不同区段。实际工作中尤其应检查子片段之间是否具有一致信号。若同一原始序列的前后区段被分到不同簇,可能涉及组装嵌合、重复、拷贝数差异、水平转移区域,或者当前模型在该处的区分不确定性。作者工作流程 · CONCOCT 项目代码
观察到分段标签不一致以后,下一步需要判断这个不一致的来源。局部标签提供了检查位置,仍要回到原始读段、组装图和注释证据判断是否存在错误连接。某个基因组里的真实外源区段,也可能在组成上偏离主体。相反,一段人工误拼接在整体长度与平均深度上也可能看起来正常。保存每个子片段的原始坐标、覆盖和聚类标签,能让这些不同解释有机会接受检验。
实跑经验 · 六十条正常片段加两条有意设计的嵌合序列
实验使用 CONCOCT 1.1.0,以固定随机种子生成两类人工序列。每类有三十条两万碱基的正常片段,两类的碱基组成不同,在四个设计样本中也有相反的深度变化。再加入两条嵌合序列。第一条长三万碱基,前一万来自甲类,后两万来自乙类。第二条长两万,前后各一万来自甲乙两类。它们是为了检验后处理而明确构造的反例,来源标签在生成时已经知道,不能用此演示的分离程度估计自然群落的准确率。
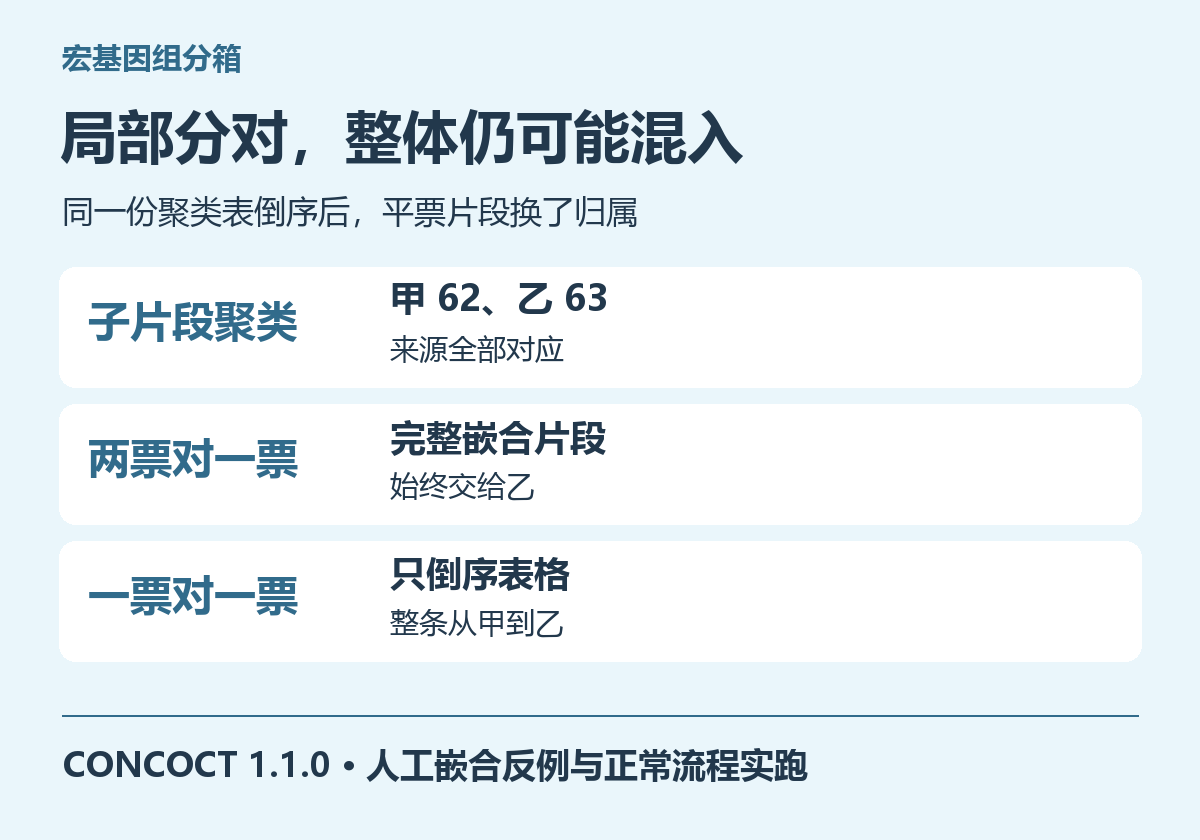
首先执行作者的切片程序,片段长度一万、重叠长度零,并启用合并末尾短片段的选项。六十二条原始序列得到一百二十五个子片段,再按每段已知来源生成四列设计覆盖。随后调用完整聚类入口,固定种子三十七、两个线程、四个初始簇与最多两百次迭代。最终甲类的六十二个子片段全部在本次编号为零的簇,乙类六十三个全部在编号为一的簇。两个嵌合片段内部的不同区段,也分别落到对应来源的簇。输入生成器、完整调用与实测结果
python3 109-concoct/run.py "$(command -v concoct)" \
  "$(dirname "$(command -v cut_up_fasta.py)")" work109

# 单独检查标签合并时,一并保存警告
merge_cutup_clustering.py work109/model/clustering_gt1000.csv \
  > merged.csv 2> merged.warnings.txt
运行环境需要一起保留。本次使用 Python 3.11、NumPy 1.26.4、pandas 1.5.3、SciPy 1.13.1 与 scikit-learn 1.1.3。开始使用较新的 scikit-learn 1.8.0 时,原版入口在主成分分析之前因混合列名类型而报错。固定兼容依赖后完成了全流程。这个错误发生在特征输入检查阶段,不能据此评价数据能否分箱。复跑时先让同一份小例子通过并确认输出字段,再替换自己的输入,可以减少环境差异与生物学差异混在一起的情况。
| 原始片段 | 子片段实际标签 | 原顺序合回后的标签 | 倒序记录再合回后的标签 |
|---|---|---|---|
| 三万碱基嵌合片段 | 甲、乙、乙 | 乙 | 乙 |
| 两万碱基嵌合片段 | 甲、乙 | 甲 | 乙 |
第二次合并沿用已经计算好的聚类表,只把记录行顺序倒置。原始序列、子片段标签和模型都没有重新计算。对于两票对一票的片段,合并仍选乙。对于一票对一票的片段,合并结果从甲变成乙。两次都真正调用了原作者的合并脚本,之后又调用序列提取脚本,从原始 FASTA 生成对应箱文件。第一次完整的平票片段进入甲箱,第二次则完整进入乙箱。
为什么看到警告以后仍然会得到一个标签
在这个版本中,合并脚本按同一原始片段的子片段标签计数,选择出现次数最多的标签。它只读取聚类表,里面没有每个位置的读段支持,也没有每段蛋白的分类证据。因此多数标签的作用是给原始片段确定一个输出归属。前一万碱基来自甲的三万嵌合片段,合并后完整进入乙箱,甲区段的碱基不会在这个操作中被切除。下游如果只看最终箱文件,就会同时看到乙主体和那段甲来源序列。
当同一原始片段的子标签不一致,脚本会在标准错误流写出没有一致归属的警告,同时给出各标签计数和最终选择。两票对一票也会出现警告,所以这句话不能直接解释成程序没有作出选择。需要同时检查合并输出和警告内容。只保留标准输出、把错误流丢掉,会得到一张看起来每条序列都有确定归属的整齐表,却失去追查这些矛盾的入口。合并脚本原始实现
平票时的变化来自记录顺序对计数结果的影响。我们的测试只改变了表格行顺序,就改变了那个一比一片段的选择。这个观察给出一个很具体的复核要求,如果重点功能区落在平票片段上,不能把合并后单个标签当作稳定的宿主归属证据。应把原始子片段标签和坐标一起列出,查看功能区究竟落在甲标签区、乙标签区,还是跨越两者的边界。若关键位点本身处在重复或保守序列中,还要另外检查分类是否可分辨。
子片段分对了,为什么整体评价仍可能受影响
一个箱里多了整条嵌合片段,会影响哪些结论,取决于外来区段携带什么内容。若带有另一个来源的保守标记,质量评估可能显示重复标记增加。若带有目标酶或耐药相关基因,功能归属可能随整条标签改变。若只是没有已知注释的非编码区,标记指标可能几乎不动。由此可见,整体质量分数保持稳定,也不能自动证明每个重点基因的宿主都已确定。沿片段坐标检查研究结论依赖的区域,能补上这种局部盲区。
反过来,出现局部组成差异也不能直接要求拆断原始序列。真实基因组可以包含组成异常的区域,天然连接可能得到大量独立读段支持。若把所有不一致区段都切掉,可能丢失有研究价值的可移动元件或外源区域。合理的检查顺序是先定位标签变化的边界,再查看跨边界读段的数量、独立起点、方向和比对质量,检查组装图是否存在替代路径,最后结合两侧的分类与功能注释判断。把这些证据汇到同一条坐标线上,比单独比较几个全局百分比更容易讨论。
本例之所以能说整条归属含有不同来源,是因为嵌合结构由输入生成器明确设定。对于天然样本,子标签不一致应当写成需要复核的信号,只有拿到独立的结构证据后再说明是否误组装。实验记录可以保留三种状态,证据支持同一真实连接、证据支持错误拼接、以及当前无法判定。后续补测能针对尚未判定的连接提供新信息,也不会把一次算法分歧提前定性成生物学事件。
怎样避免把切片步骤和覆盖坐标弄乱
使用作者切片程序时,应同时保存对应的坐标文件。后续覆盖表要描述这些切片区间,表中的标识也必须与切片 FASTA 一致。如果把原始整条序列的平均深度复制给所有子片段,就丢掉了沿序列的局部变化,影响这一步原本希望获得的信息。真实流程通常需要将各样本读段对齐到同一份原始组装,再利用切片坐标统计局部覆盖。检查一个有明显覆盖变化的长片段,可以快速验证覆盖是否确实按区间计算。
每次改变切片长度或末尾处理方式,重新核对三份文件,切片序列、切片坐标和切片覆盖。旧切片表的名字即便看起来相似,也不代表区间相同。末尾短段并入前段以后,最后一个区间会变长,应检查该区间实际起止位置。若坐标仍沿用旧版本,就可能用一段序列的组成配上另一段区域的深度。记录文件校验值和切片命令,有助于阻止这种在格式层面完全合法的错配继续传入聚类。
给原始片段命名时还要避免与工具添加的切片后缀混淆。合并程序靠可识别的后缀恢复原始标识,后续手工改名、截掉末尾数字或将下划线替换,可能破坏这一对应。建议另存一张原始标识、切片标识、起点、终点的映射表,并在合并前统计每条原始片段实际有多少子记录。某个片段预期三个子段却只出现两个,首先要查缺失记录,再解释剩余两票形成的归属。
还可以在合并前自动统计每条原始片段包含的不同标签数,另存所有超过一个标签的记录。这样即使后续日志被压缩归档,复核对象也有一份结构化清单。对清单里的片段同时保存各标签出现次数,便能直接筛出平票和明显多数两种情况,分别安排后续检查。
交付结果时,把矛盾保留到能够解释的位置
最终分箱表之外,至少保留子片段聚类表、合并后的原始片段表和合并警告。在审查报告中,列出子标签不一致的原始片段数、平票数及相关总长度,然后把重点基因所在片段单独标记。对两种参数或两次运行的比较,应先以子片段身份对齐标签,再看合并选择是否变化。编号本身可能重排,判断两个簇是不是对应同一来源,要依据成员重叠和独立标记,不能只比较编号字符串。
如果后续决定拆开一条有充分证据支持的嵌合片段,新的序列标识、坐标、覆盖和基因注释都要同步更新。原始编号与新编号的映射应保留下来,让下游分析能追到究竟改了哪个区域。拆分后的片段仍需重新接受质量评估。对尚未确定的片段,可以将其标为暂缓宿主归属,并继续保留其中确实观察到的功能序列。这样交付的结果既能用于下游研究,也给补充验证留下了清楚的位置。
这次实跑把聚类与合并的作用分得很具体。局部特征正确分离了两个来源,多数合并仍把完整嵌合序列交给一个箱,平票还会受到记录顺序影响。了解这些行为后,遇到一张整齐的最终标签表,就知道应到哪里查其内部是否存在矛盾,以及哪些连接值得用原始数据再检验一次。
需要对多样本组装批量进行切片覆盖、分箱与局部连接复核时,可依据试跑规模与云生信生物分析服务器团队安排运行环境。


