
同一份宏基因组组装交给几个分箱工具,常会得到数量、成员和质量各不相同的候选箱。某个工具把几条片段放在一起,另一个工具把它们拆开,还有的片段在多份结果中反复出现。整合之前首先需要确定这些文件是不是描述同一批序列,其次才是选择哪些候选更值得保留。我们用 DAS Tool 作者提供的四份示例结果跑了三个分数阈值,从输入成员关系到最终箱表逐项核对,说明箱数增加或减少时,究竟发生了什么。
整合之前,先确认所有工具谈的是同一批片段
DAS Tool 接收原始片段序列和多份“片段属于哪个箱”的对应表,利用单拷贝标记等信息评价候选,再进行去冗余、选择和整合。前提是不同对应表里的同一个片段标识,确实指向同一条序列。如果几份结果分别来自不同组装,只是碰巧都出现类似编号,直接把对应表交进去,就无法建立正确的成员重叠关系。最开始应固定一份 FASTA,核对所有成员标识都能在其中找到,并检查每个原始文件是否含有重复行。DAS Tool 原始研究 · 作者项目与使用说明
对一条片段出现在多个工具结果中的情况,可以继续保留这些候选归属,让整合步骤评估它们之间的重叠。对同一输入表里同一片段重复出现,则应单独检查其对应箱标签。完全相同的成员关系可能来自文件重复拼接,同一标识对应两个箱则描述另一种歧义。把跨工具重叠与单个表内部的重复分别统计,能够避免把多写了几行文件误当成得到了更多独立证据。输入行数与不同片段数,也应始终作为两列指标保留。
实跑经验 · 四份作者示例和三个分数阈值
安装运行 DAS Tool 1.1.7,使用该版本仓库随附的人肠道示例组装,以及 CONCOCT、MaxBin 2、MetaBAT 和 tetraESOM 的四份候选分箱表。四表合计两千一百七十七条成员关系,涉及一千八百零九个不同片段,其中三百五十八个片段出现在不止一份候选表中。另有十个片段在示例的 MetaBAT 对应表内部重复出现。这里描述的是作者随附示例文件的实际内容,不能据此概括某个工具在所有项目中的输出习惯。
本次将作者提供的预测蛋白复制到独立工作目录,以这些蛋白作为正常入口的输入,实际执行单拷贝基因搜索和后续整合。DIAMOND 版本为 2.1.9,所用参考库来自同一份 DAS Tool 版本。没有重新进行基因预测,避免把蛋白预测差异混进阈值对照。三轮保持片段、候选表、预测蛋白和其他参数一致,只把保留分数门槛设为零点五、零点九和零点二。每轮都保留输入候选评分表与最后成员表,默认门槛一轮还实际导出了箱 FASTA。完整驱动脚本与实测输出摘要
python3 112-dastool/run.py DAS_Tool work112

# 查看实际生成的结果表
head -n 5 work112/default/result_DASTool_summary.tsv
head -n 5 work112/default/result_DASTool_contig2bin.tsv
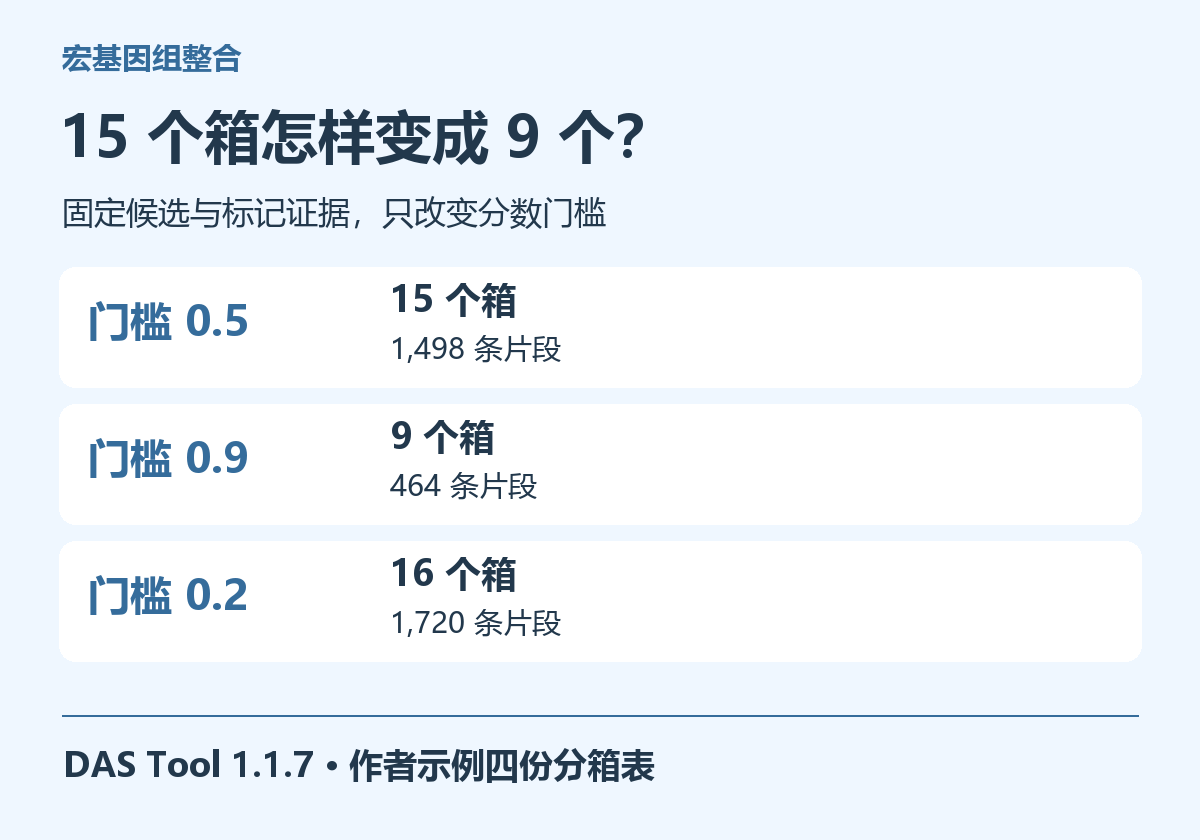
| 分数门槛 | 最后保留的箱 | 写入结果的不同片段 | 同一片段重复分配 |
|---|---|---|---|
| 0.5 | 15 | 1,498 | 0 |
| 0.9 | 9 | 464 | 0 |
| 0.2 | 16 | 1,720 | 0 |
片段数按最后成员表的标识去重后统计,重复分配单独检查。三个输出在这个检查上都没有同一片段进入多个最终箱。这个结果说明整合输出在成员关系上达到了互斥要求,还不能说明每条片段都被分到了生物学上的正确来源。我们没有这个实际群落的逐片段真值,因而将对照解释限制在候选筛选、输出组成及标记评分的变化上。对真实来源的进一步判断还需要独立分类、质量评估和读段证据。
门槛降到零点二以后,具体多出了什么
与默认门槛相比,较宽松设置多保留了一个名为 concoct.95 的候选,包含两百二十二条片段,总长一百四十八万零九百二十六碱基,连续性指标为八千三百七十三碱基。它有二十二个不同单拷贝标记,冗余标记计数为零,软件报告标记完整度百分之四十三,分数约为零点四三一。新增片段数恰好对应两轮最终不同片段数之差,可以从这个箱的成员表直接核对。
这些数字帮助读者明确新结果增加的是什么。该候选有可检测的保守基因信息,当前标记覆盖也明显不完整。若研究目的是尽可能保留一个低完整度候选用于后续补组装,可以单独追踪它。若需要据此宣布某条完整代谢通路不存在,当前缺失背景会影响这种解释。目标功能基因未出现,可能是确实缺失,也可能落在尚未恢复的区域。保留候选与给出较强生物学结论,是两个需要分别设定依据的步骤。
反过来,较严格设置只写出九个箱和四百六十四条片段。它筛掉了当前评分条件下未达到门槛的候选,结果中的箱数也随这套筛选条件改变。不能把从十五个箱降为九个箱写成“样本只剩九种微生物”,也不能因门槛降低多了一个箱就宣称发现了新物种。不同工具可能拆分同一来源,不同近缘来源也可能合在一起,某些成员还可能没有获得足够组装序列。物种层面的结论需要另行建立分类和去冗余依据。
为什么分数和完整度百分比不能混着用
默认输出里有一个 MaxBin 2 来源候选,软件列出三十五个不同标记、两个冗余标记,标记完整度为百分之六十九,最终分数约为零点六三二。这个例子直接说明两个字段在当前结果表里数值不同。DAS Tool 的分数综合考虑保守标记覆盖以及相关惩罚,具体计算取决于程序的定义与参数。筛选时若拿完整度列去代替分数列,就可能得到另一组保留结果。
还要留意单位。命令中的分数门槛使用零到一的范围,表里的标记完整度以百分数展示。两列的数值范围不同,语义也不同。做表格筛选时应保留原始列名,把后来自己定义的过滤条件另写成一列,记录同时使用了哪些字段。若将百分比除以一百只是为了统一作图尺度,图注应说明这是显示变换,不能因此把它当成原本的综合分数。
冗余标记同样需要结合成员来解释。观察到重复的保守标记,可能提示不同来源混入、近缘菌株混合或真实的拷贝数变化。把可疑标记所在片段导出来,查看其分类、覆盖和组成,可以给后续处理提供具体对象。只有一个全局冗余百分比,很难决定该移除哪些片段。若某个片段同时携带研究关注的功能区,移除前应保存其序列与证据,让功能观察和宿主判断都能继续追踪。
为什么要同时保存输入评分与最终成员
开启输入候选评估输出以后,可以把每一个来源工具的候选质量放在同一张评价表里,再与最后选择的结果比较。这样才能回答某个候选没有出现是因为评分不足、与较优候选高度重叠,还是在整合过程中对应成员发生了变化。一个来源工具在最终表中贡献的箱较少,也不能单凭这一数量评价它整体更差。它可能提供了与其他候选重叠的同一组片段,而当前评分规则选择了另一份组合。
在本次示例中,最终保留候选的汇总指标与对应输入评价一致,复核没有发现被选中箱在这次输出中发生成员数量变化。这个观察只适用于当前对照。程序的一般整合流程会利用重叠关系并对候选进行处理,自己的数据仍应逐项比较最终成员。尤其在更换候选工具、加入新的一份分箱结果或改变参数以后,旧箱名称未必意味着内部序列集合没有变化。
建议给每个最终箱保存成员标识的稳定排序及其校验值。比较两个运行版本时,先判断成员集合是否相同,再比较总长、标记完整度、冗余和功能注释。若两次都叫同一个箱名,却有片段被替换,后续功能变化就需要追到这些具体片段。若只是箱名重新编号而成员完全相同,就将它们视为同一个待比较对象,可以避免把文件命名差异写成分析上的新增与丢失。
安装能启动,还要检查中间结果是否真的有效
这次配置测试环境时,候选蛋白抽取程序的运行库一度没有正确载入。首次比对文件已有记录,候选蛋白 FASTA 却是空的,流程最后报告没有识别到单拷贝基因。修正依赖的运行库路径后,完整搜索与整合才得到上面的结果。排查时检查了比对文件、候选蛋白文件与依赖错误输出,没有把空结果解释成样本缺乏保守基因,也没有靠放宽标记阈值掩盖安装问题。
实际项目里可以沿着相同的顺序检查。入口帮助能显示,说明主程序至少可以启动,仍需确认它调用的基因预测、比对和序列提取程序能够真正处理输入。先用作者示例完成一次小规模运行,记录关键中间文件的记录数和最后输出字段。某一步突然变为空时,从最早变化的文件往上游追查,检查标识、输入路径和依赖日志,会比只反复运行最终命令更容易定位原因。
同样要检查完整的输入路径和输出目录。候选表中的片段名应与 FASTA 标识一致,提供的预测蛋白应能按对应格式追溯到其来源片段。若更换了组装版本却继续沿用旧预测蛋白,表面上仍可能有大量比对结果,但这些证据不能自动转移到新序列上。保留组装、预测蛋白和候选表的版本及校验值,让它们作为同一批输入一起更新,能够使后续结果具有清楚的来源链条。
怎样把整合结果交给下游分析
交付时建议保留原始候选表、输入候选评分、最终成员表、最终质量摘要和未进入结果的片段集合。对不同门槛,额外列出新增、移除与发生成员变化的候选。把较低完整度的箱作为明确标记的候选保存,可以支持后续补组装或特定功能搜索,进入主要比较的箱则按项目预先约定的评价条件筛选。读者看到结果时,应当知道每个对象在当前分析中承担什么用途。
对于需要比较丰度的研究,整合之后还要将原始样本读段回贴到确定的最终序列集合,说明多处比对、近缘基因组和重复片段如何处理。只用一个箱里片段条数或总长,无法替代样本丰度。对于需要比较功能的研究,还应把未恢复区域和标记完整度纳入解释。先把基因组对象及其证据固定下来,再进入群落或功能比较,能减少在多个文件版本之间来回改变分母。
本次实跑提供了一条可逐项核对的路径。四份候选表经过同一套标记搜索和评分后,三个门槛分别保留十五、九和十六个箱,新增候选的二百二十二条片段能完整追溯到其来源。把同样的核对应用到自己的结果,便能具体说明一次参数修改保留了什么、丢掉了什么,以及哪些生物学解释还需要额外证据。
若要在更大的队列上重复候选整合、标记评估与回贴核验,可用实测输入规模和云生信生物分析服务器团队安排批量分析环境。


