
扩增子分析进入多样性计算之前,常常需要检查特征表和样本测序量。一个容易令人困惑的情况是,原来有三个样本,经过过滤和抽平之后只剩一个,运行日志却没有报错。要解释这种变化,需要把每一步使用的计数表和保留条件连接起来。
本文实际安装 QIIME 2 的 2026.10 官方发行环境,从一张四个特征、三个样本的人工计数表开始,运行导入、汇总、过滤、固定种子抽平、相对频率转换及导出核对。实验同时检查数据类型与来源记录,读者可以用很小的数据理解完整的表格处理过程。
先确认手里的是哪一种表
特征计数表记录每个样本中各个特征出现多少次。相对频率表则把每列除以该样本的总计数,使每个样本的合计变为一。两者可能采用类似文件格式,但数值含义不同。
QIIME 2 的产物会记录相应类型。计数表使用 FeatureTable[Frequency],相对频率使用 FeatureTable[RelativeFrequency]。导入时正确声明类型,后续命令才能依据数据含义检查是否接受输入。官方特征表导入说明
开始分析前,可以先检查最基本的三个问题。行是否代表特征,列是否代表样本,数值是原始计数还是已经归一化。尤其是从其他软件导出的表格,文件名中写着丰度,并不能完整说明这些问题。
本次四个行名只是教学标签,没有对应真实扩增子序列。我们从计数表开始,因此实验范围不包含读段质控、去噪或分类,也不把这些标签当作已经验证的生物学特征。
三个样本的输入计数怎样安排
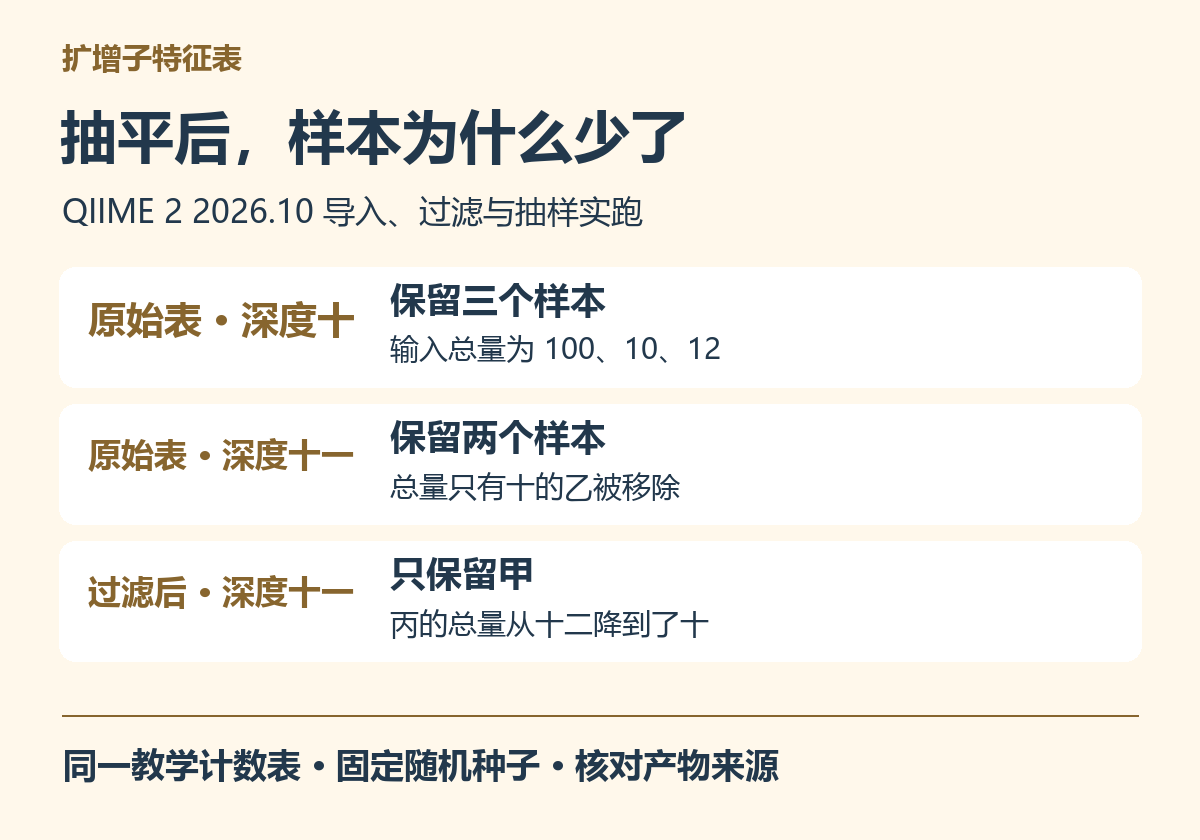
甲样本的总计数为一百,乙为十,丙为十二。第四个特征只在丙中出现两次,其他三个特征分别出现在至少两个样本中。这个安排让特征过滤与样本总量之间的关系能够直接计算。
| 特征 | Sample_A | Sample_B | Sample_C | 出现的样本数 |
|---|---|---|---|---|
| ASV1 | 80 | 8 | 0 | 2 |
| ASV2 | 15 | 2 | 5 | 3 |
| ASV3 | 5 | 0 | 5 | 2 |
| ASV4 | 0 | 0 | 2 | 1 |
| 总计数 | 100 | 10 | 12 | 不适用 |
下载包中的脚本使用 BIOM 库生成文件,将行列名称与数值一同保存。读者也可以先在纸上计算每列总和,再与导入后的结果核对。对于真实表格,这种核对有助于发现转置、遗漏样本和错误归一化等问题。
这里采用十和十一两个很小的抽样深度,只为说明程序行为。正式扩增子项目需要根据实际保留读段、分析目标和样本分布决定深度,不能直接沿用本例的教学数值。
先固定发行环境,再执行导入
本次使用官方的 quay.io/qiime2/qiime2:2026.10 镜像。实际环境显示 Python 3.12.16,框架版本为 rachis 2026.10.1,命令行包为 rachis-cli 2026.10.0,特征表插件为 2026.10.0。镜像摘要记录在下载包中。官方安装说明
命令名称仍然可以使用 qiime。复现时先运行环境信息命令,再查看具体插件的帮助,可以确认手头版本提供哪些输入、输出和参数。
qiime info

qiime tools import \
  --input-path counts.biom \
  --type 'FeatureTable[Frequency]' \
  --input-format BIOMV210Format \
  --output-path counts.qza
输入格式描述文件如何存储,产物类型描述数据代表什么。这里的文件采用 BIOM 的相应存储格式,数值含义是计数,两项都与实际输入一致。
导入以后,我们还会把产物导出并重新读取计数矩阵。这样可以同时核对样本名称、特征名称和数值,确认后续步骤是在预期输入上运行。只看文件存在或命令返回成功,无法完成这些内容层面的检查。
汇总结果怎样帮助选择下一步
本次版本的汇总命令生成三个输出,分别保存特征频数、样本频数以及可视化结果。运行时明确写出各个文件,便于后续按用途查找。
qiime feature-table summarize \
  --i-table counts.qza \
  --o-feature-frequencies feature-frequencies.qza \
  --o-sample-frequencies sample-frequencies.qza \
  --o-summary summary.qzv
样本频数可以帮助确认总计数分布,特征频数可以帮助检查特征出现范围,可视化文件用于浏览汇总内容。配合原始矩阵查看,会更容易理解哪些样本接近后续门槛。
在自己的项目中,可以先列出候选抽样深度,以及每个深度会保留多少样本,再把样本分组信息接入这张表。如果丢失的样本集中在某个组,后续比较的数据组成就会改变,需要在分析设计中明确处理。
本次表格规模很小,十和十一之间只差一个计数,却足以改变乙样本是否保留。因此,在报告深度时给出完整数值,并保存实际保留样本列表,比只写“大约相同的测序量”更便于复查。
第一组抽平,深度为十时三个样本都保留
抽平从各个样本的计数中抽取指定总量。本次采用默认的不放回方式,并显式固定随机种子。样本需要拥有足够计数才能达到所设深度。
qiime feature-table rarefy \
  --i-table counts.qza \
  --p-sampling-depth 10 \
  --p-random-seed 121 \
  --o-rarefied-table raw10.qza
实际输出保留甲、乙、丙三个样本,每个样本合计十。乙原来正好有十个计数,达到门槛,因此保留。甲和丙的计数总量高于十,输出则是抽取后的组成。
这里应区分两个检查问题。总计数是否等于指定深度,可以按列求和确认。每个特征抽到多少,则与输入组成和随机抽样有关,需要读取实际矩阵。总量相同的两个结果,具体特征计数仍然可能不同。
本次通过正常导出命令得到 BIOM 文件,再独立读取每个样本的总计数。这个核对过程可以用在后续任何表格步骤中,帮助确认输出数值符合预期。
第二组把深度提高到十一,乙为何消失
第二组直接使用同一份原始计数产物,将深度改为十一,其他条件保持一致。甲有一百、丙有十二,能够达到门槛,乙只有十,无法从现有计数中抽出十一个不同计数单位。
实际输出只保留甲和丙,两列总计数均为十一。乙没有出现在结果样本列表中,这是当前条件下的正常行为。特征表插件与抽平参数说明
因此,如果某个样本在抽平后消失,可以先核对抽平命令实际接收的输入表,再计算该样本在那张表中的总量。即使早期测序统计显示读段较多,经过其他过滤后传入的计数也可能已经减少。
这一点在较长流程中特别有用。原始读段数、通过去噪的数量、去除特定特征后的总量,以及最终抽平前的计数,属于不同阶段。排查样本丢失时,应找到紧邻该步骤的输入数值。
特征过滤为什么又让丙无法通过
第三类对照先过滤特征,要求每个特征至少出现在两个样本中。第四个特征只在丙中出现,因此被删除。其他三个特征满足条件,全部保留。
qiime feature-table filter-features \
  --i-table counts.qza \
  --p-min-samples 2 \
  --o-filtered-table filtered.qza
实际导出的过滤表仍然包含三个样本,但总计数变成一百、十、十。丙丢掉第四个特征的两次计数,从十二降到十。此时再次设置抽平深度十一,实际结果只剩甲。
| 输入与条件 | 抽平前总计数 | 抽平后保留样本 |
|---|---|---|
| 原始表,深度 10 | 100、10、12 | 甲、乙、丙 |
| 原始表,深度 11 | 100、10、12 | 甲、丙 |
| 先做特征过滤,深度 11 | 100、10、10 | 甲 |
这组结果说明,样本是否能通过抽平,取决于该步骤实际看到的计数。特征过滤虽然直接作用于行,也会改变各样本的列总和,因此可能影响后面的样本保留。
解释过滤规则时,还应确认“至少两个样本”在哪一组样本范围内计算。如果之前已经删掉某些样本,特征的出现次数也会变化。本次过滤明确在原始三个样本上执行,下载包保留了输入产物与参数关系。
固定随机种子后,应该比较什么来判断复现
本次对原始表按深度十一、种子一百二十一重复运行两次。导出后,两次的样本名称、特征名称和计数矩阵一致。我们另用种子一百二十二再运行一次,保存了对应结果,供读者检查抽样条件变化。
固定种子适合让同一输入、同一实现下的随机步骤得到可重复结果。保留种子时,还应一同记录版本与输入产物,因为它们共同决定实际计算条件。
两次相同种子的运行会生成新的产物标识和运行记录。因此,整个压缩产物的字节内容可以不同,即使其中的计数矩阵一致。判断本例的数值复现时,我们比较的是解出后的名称与矩阵,同时检查来源中记录的输入和参数。
这种比较方式也适合协作。交付结果时,可以把数据内容的核对与运行记录的核对分开完成。前者确认具体数值,后者确认这些数值通过哪些条件产生,二者都对复查有用。
本次两个种子的实际差别可以在甲样本中直接看到。种子一百二十一抽到的前三个特征计数分别为九、二、零,种子一百二十二则为八、二、一,合计都为十一。第三个特征在原始甲样本中有五个计数,但一次抽样中没有被抽到,另一次则被抽到一个。
因此,抽平后的零值还需要结合上游表格解释。它可能表示原始表中就没有观测,也可能来自过滤或本次随机抽样。讨论某个特征是否存在时,保留抽平前的计数与处理条件,可以帮助区分这些来源。本次过滤后再抽平的结果只剩甲,第三个特征在保留样本中全为零,最终表也只保留了前两个特征。
把相对频率表拿去抽平,会发生什么
本次还正常生成了相对频率产物,各样本按列归一化。随后尝试把它传给同一个抽平命令,程序因输入类型不匹配而拒绝执行。
这项对照展示了类型信息的实际作用。抽平需要计数形式的输入,相对频率表表示比例,即使也存放在 BIOM 文件中,仍然不能据此恢复原始观测数量。保留原始计数表,可以避免后续需要计数时失去来源。
qiime feature-table relative-frequency \
  --i-table counts.qza \
  --o-relative-frequency-table relative.qza
遇到这类错误时,应回到分析含义选择正确输入。将文件改名、修改后缀或者把比例随意乘以一个常数,都不能保证恢复原来的观测计数。应该找到仍然保留真实计数的产物,再执行需要计数的步骤。
本例将预期失败的类型检查保存在日志中,随后继续完成产物验证。复现脚本会明确检查这一步确实返回失败状态,避免把预期的输入拒绝误读为实验中断。
用来源记录串起整个处理过程
本次读取产物中的来源信息,核对抽平步骤使用的输入产物、深度与种子,以及过滤步骤形成的上游关系。这样可以解释为什么两张看似相似的抽平表,最终保留的样本不同。
同时,我们通过正常导出获取内部数据,再读取样本列表、特征列表及矩阵。导出数据适合继续交给其他工具处理,原始产物适合保留来源关系,两者可以一起保存。官方导出说明
来源记录从导入之后的流程开始提供支持。对于本次人工生成的计数,生成脚本也需要一同保存。真实项目若在导入前进行了其他处理,同样应保存相应方法和输入,才能形成连续的分析记录。
QIIME 2 的价值在于将类型检查、插件操作和来源记录连接起来。使用时需要投入一些精力理解这些对象,但掌握之后,样本丢失、输入误用以及参数差异都会更容易追踪。
本次下载包包含计数生成脚本、全部命令、五组抽平结果、类型检查和产物来源记录,读者可以修改原始计数或门槛后逐项复算。下载实跑脚本与本次结果
当分析需要持续管理多个批次的扩增子数据、插件环境和可追溯结果时,可了解云生信的生物信息学分析计算服务。


