
差异剪接分析最容易被简化成一项筛选操作,打开结果表,保留显著行,再把对应基因送去富集。但如果包含水平、组别方向、重复之间的差异和计数口径没有读清楚,筛出来的列表可能在第一步就带着错误解释。
本篇围绕 rMATS-turbo 的结果含义,使用四组原创虚构计数练习,实际运行独立 Python 脚本核对计算。没有安装或执行 rMATS-turbo,也没有进行事件发现和统计拟合。文中的校正显著性数值均为读表训练而手工设置,不能作为软件实测结果。
先确认对象是剪接事件
一个基因可以有多个可变区域,同一可变区域也可能参与不同结构关系。事件级结果因此不等于基因级表达结果。某个事件的包含水平变化,不能直接改写成整个基因表达上调或下调。
例如,一个外显子跳跃事件的包含形式保留目标外显子,另一种形式跨过它。包含比例增加,描述的是这两类局部选择的相对变化。总转录量可能增加、下降或者保持不变,单独的比例并不能回答。
进一步做基因汇总时,也要先明确一行事件是否代表独立证据。同一基因出现多行,不应直接累计成多个独立验证。如果只需要一个候选基因列表,可以去重,但同时应保留事件坐标和变化方向供回查。
rMATS 的方法设计将读段抽样不确定性和重复之间的变化纳入考虑。原始研究也讨论了简单合并重复不能替代重复层面建模的问题。rMATS 原始研究
这里为什么采用独立读表练习
项目当前许可说明面向学术和非营利研究,并要求商业实体使用时另行联系。在没有确认覆盖本次用途的授权前,我们只查阅公开资料,运行自己编写的算术检查,不下载软件绕过许可,也不把练习称作安装实跑。rMATS-turbo 官方许可
这不影响学习结果解释。下面每个例子的输入都公开,读者可以手算,也可以运行附件脚本复核。练习不会复现 rMATS 的统计模型,不生成真实检验概率,更不能替代正式分析所需的比对和生物学重复。
我们固定包含形式的有效长度为二百,跳跃形式为一百,用来隔离长度归一化的影响。这些长度是练习设定,不能直接复制到自己的所有事件中。真实文件应使用对应事件和计数方式给出的实际长度。
第一课,读段比例不等于包含水平
第一组练习的一个样本有四十条包含支持和二十条跳跃支持。如果直接算四十除以六十,得到约三分之二。但两种形式提供被计数机会的有效长度不同,需要先校正这个差别。
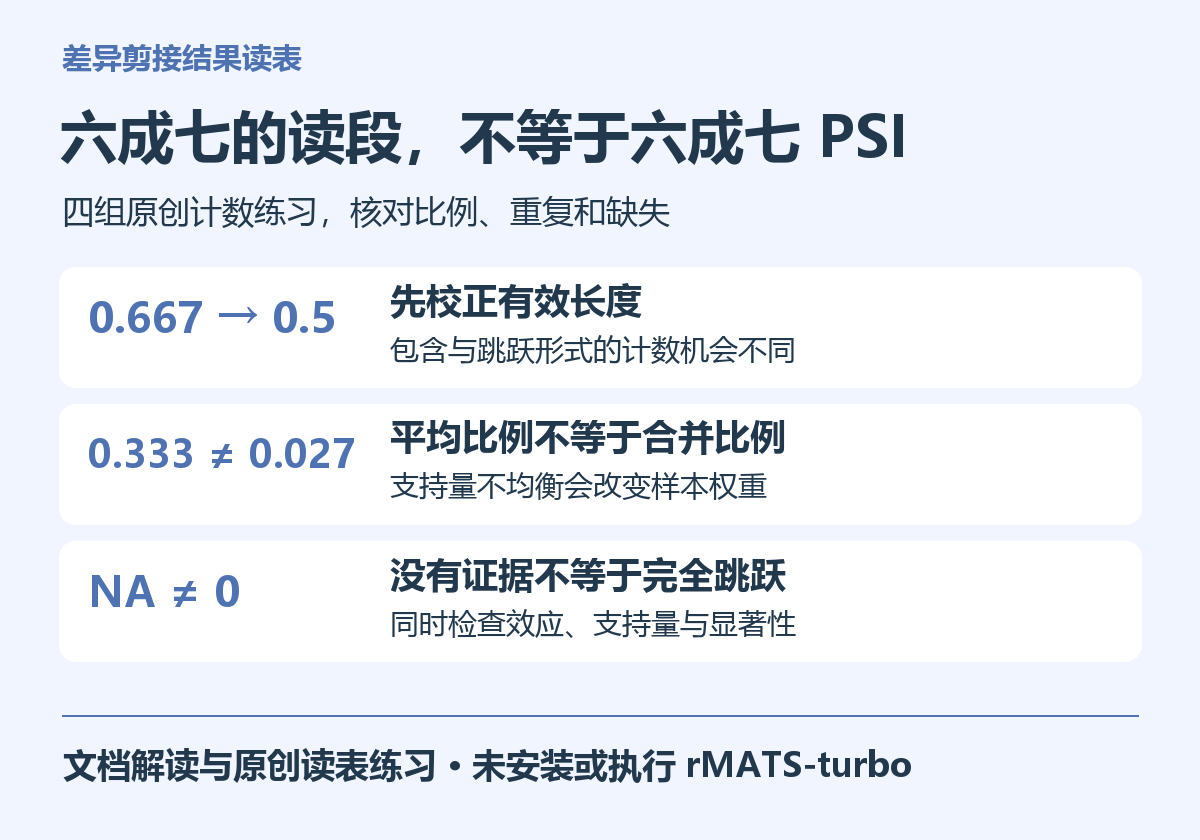
把四十除以二百,得到零点二。把二十除以一百,也得到零点二。随后用前者除以两者之和,结果为零点五。也就是说,原始包含读段比例约为六成七,经过这组长度设定校正后的包含水平是一半。
包含标准化支持 = I / L_I
跳跃标准化支持 = S / L_S
PSI = (I / L_I) / ((I / L_I) + (S / L_S))

本例
I = 40,S = 20,L_I = 200,L_S = 100
PSI = 0.2 / (0.2 + 0.2) = 0.5
这项计算并不是把读段数随意打折,而是在比较两种形式的相对支持时考虑机会空间。若两个长度恰好相同,原始比例与归一化比例才会一致。不能因为某一个例子中两者接近,就永久省略长度项。
也不要把有效长度理解为目标外显子的物理长度。它服务于当前计数模型,和事件类型、读长及计数区域有关。检查结果时,应将包含计数、跳跃计数和两种有效长度作为一组读取。
重复列必须保持原来的样本顺序
第一组虚构事件有三份组一输入,包含与跳跃计数依次为四十与二十、四十四与二十二、三十六与十八。组二分别为二十与四十、二十二与四十四、十八与三十六。
三份组一的归一化包含水平都为零点五,三份组二都为零点二。练习中组一减组二得到正零点三,表示组一的局部包含水平高三十个百分点。
| 练习样本 | 包含计数 | 跳跃计数 | PSI |
|---|---|---|---|
| 组一,第 1 份 | 40 | 20 | 0.50 |
| 组一,第 2 份 | 44 | 22 | 0.50 |
| 组二,第 1 份 | 20 | 40 | 0.20 |
| 组二,第 2 份 | 22 | 44 | 0.20 |
真实结果中,重复值以列表形式保存时,必须与输入分组文件的顺序对应。给列加样本名称之前,应先保存一份编号到样本的映射,避免因为排序方式变化而把支持量关联到另一个样本。
当前官方输出定义的差值方向是组一平均包含水平减去组二平均包含水平。改变两组顺序会改变符号,但不自动改变效应绝对大小。写结果时应注明哪个生物学条件对应组一,而不是只写正向或负向。rMATS-turbo 输出说明
第二课,合并计数与平均比例不是同一个问题
第二个虚构事件故意设置不均衡覆盖。组三份样本的包含与跳跃计数分别为二与零、零与十八、零与十八。归一化比例分别是一、零、零,三个样本的算术平均为三分之一。
如果先合并计数,得到包含二、跳跃三十六。用同样的有效长度计算,合并比例约为零点零二七。三分之一和百分之二点七差得很远,但两次算术都没有算错,它们给不同样本分配了不同权重。
前者把每份样本的比例等权平均,后者让支持量较大的样本在整体比例中占更多权重。读者必须先知道自己要描述的是典型样本,还是合并证据集合,而不能把两种结果当成可互换的统计量。
本练习的组二三份样本都为零点五。因此,按样本平均计算的差值约为负零点一六七,合并后计算约为负零点四七三。一个汇总方法的变化,就能明显改变对效应大小的直观判断。
这并不意味着应当盲目接受低覆盖样本的极端比例。第一份只有两条总支持,比例为一依然缺少稳定证据。正确做法是同时展示支持量和重复分布,再使用合适的正式模型,而不是通过合并把问题隐藏起来。
第三课,没有支持与完全跳跃必须分开
第三个虚构事件的组一第一份样本,包含和跳跃计数都为零。此时计算式的分子与分母都是零,包含水平没有定义。它既不是完全包含,也不是完全跳跃。
剩余两份样本的比例都是零点五。若只描述有观察值的样本,均值是零点五。若把缺失值填成零再平均,均值会降到三分之一。后者把没有观察到事件的信息,改写成观察到了完全跳跃。
本练习明确采用对已观察值计算均值的约定,同时另外标记是否所有重复都有结果。这个约定仅用于展示算术差异,并不是声称 rMATS 在所有版本和场景下都会这样处理缺失值。
正式整理结果时,应保留缺失状态,核对覆盖、可用读段和流程日志。没有支持可能与局部表达低、比对或过滤等因素有关,不能只用一个零就把原因抹掉。
如果下游绘图或筛选函数不接受缺失值,应明确选择处理规则,并报告哪些事件因此被排除。技术上让函数顺利执行,不等于这个缺失值已经获得合理的生物学解释。
第四课,显著性和效应大小需要一起读
第四个虚构事件给两组设置很高的支持量,但平均包含水平只从零点五变成零点五一,差异为一个百分点。我们手工给它设置一个很小的校正显著性值,用来练习识别变化很小但统计标签很醒目的情形。
这个数值不是从当前计数计算出来的,也没有经过软件拟合。练习的目的,是让读者区分变化幅度和不确定性这两个问题。真实分析中,是否值得进一步验证,还需要结合研究目标和可检测的变化范围。
| 虚构事件 | 平均差值 | 预设 FDR | 本练习检查重点 |
|---|---|---|---|
| 长度归一化 | 0.300 | 0.04 | 支持完整,变化明确 |
| 覆盖不均衡 | −0.167 | 0.30 | 极低覆盖样本 |
| 存在缺失 | 0.300 | 未设置 | 有样本没有事件支持 |
| 变化很小 | 0.010 | 0.0001 | 显著标签不代表大幅变化 |
练习规则要求所有重复有定义的比例、每份总支持至少十、预设 FDR 不超过零点零五,并且差值绝对值至少零点一。最终只有第一种事件通过。这里的数字用于教学,不是适用于所有项目的通用阈值。
不要把某条结果的 FDR 直接解释成该事件为假的概率。它涉及检验集合与多重比较控制的含义。更不能在挑出感兴趣事件后,只对这个很小的子集重新解释原始统计阈值,而不交代选择过程。
不同计数口径不能直接拼成一列
rMATS-turbo 提供只使用连接支持,以及同时使用连接和外显子区域支持的结果。两种口径会改变计数来源和相应归一化条件。比较时应保留文件类型,不能把一份样本的某种口径与另一份样本的另一种口径直接拼接。
遇到同一个候选在两类结果中表现不同,可以先检查额外区域是否具有覆盖支持,再观察连接层面的证据是否一致。这样的差异值得解释,但不能简单把数值更显著的一份挑出来当成唯一结果。
实际输入还受到读长、链方向、比对处理和事件定义影响。放宽读段接纳条件与改变有效长度不是同一件事。解释参数前,应对照当前版本的帮助和输出,而不是把多年以前的命令原样当成永久规则。
如果研究只围绕明确的一类事件,通常先把事件结构和支持来源读透,比同时打开大量开关更有效。rMATS-turbo 的优势是提供较清晰的事件级组织方式,方便连接到后续结构核查与验证设计。rMATS-turbo 方法文章
坐标、方向和基因名称要分别核对
定位候选时,最好保留染色体、链方向、事件类型和相关区间。基因名称可能存在别名、更新或重复,仅靠名称合并结果容易把不同事件混在一起。
带有零基制起点标记的列,也不能直接复制到采用一基制显示的工具中而不检查。例如一个从一千零一开始的外显子,零基制起点是一千。差一碱基看起来很小,却会影响位点匹配和验证引物设计。
负链上的事件还需要按其生物学方向理解,不能仅凭坐标数字从小到大就命名上游、下游或包含形式。对不熟悉的事件类型,应画出结构或查看相应定义,再解释正负差值。
一个可靠的候选记录应当能够回答,哪段结构改变、哪个条件更倾向于包含、每个重复有多少支持,以及结果用的是哪套参考和计数方式。缺少其中任何一项,后续验证就容易失去明确目标。
怎样运行这份练习
附件脚本只依赖 Python 标准库,会生成虚构计数表、计算结果及逐项检查记录。脚本和结果均明确标记没有执行 rMATS,不需要相应软件环境,也不会把手工设置的 FDR 包装成统计输出。
python3 153-rmats-turbo/run.py results/rmats-review
最小计算函数如下。先检查计数非负、长度为正,再在总标准化支持为零时返回缺失,而不是把分母随意加一个常数来制造比例。
def psi(inclusion, skipping, inclusion_length, skipping_length):
    assert inclusion >= 0 and skipping >= 0
    assert inclusion_length > 0 and skipping_length > 0
    inc = inclusion / inclusion_length
    skip = skipping / skipping_length
    return inc / (inc + skip) if inc + skip else None
下载本组三篇的脚本、结果与说明。运行后先核对第一例原始比例约为零点六六七、校正比例为零点五,再比较第二例的平均比例与合并比例。最后检查缺失值是否仍然保留,以及第四例为何没有通过练习的效应门槛。
完成这些检查后,再回到真实结果表,更容易发现样本顺序、归一化、缺失处理和筛选口径中的错误。读表能力的价值,是让每个候选都有可以复述和核查的证据,而不只是拥有一个醒目的显著性数字。
如果后续需要维护转录组差异剪接分析环境和项目结果,可了解云生信生物分析服务器服务,统一管理样本清单、参考版本及分析记录。


