
差异表达分析里,最容易被误用的往往不是一条复杂命令,而是一张看起来已经完成的结果表。倍数变化为正,究竟代表哪组更高。校正后的显著性为空,是没有表达、没有差异,还是程序主动没有给出判断。把批次写进设计公式以后,导出的标准化计数是否已经去掉批次影响。这些问题若没有解释清楚,后面的火山图和富集分析也可能沿着错误方向继续。
本次实际安装 DESeq2 1.50.2,用固定随机种子生成十二个模拟样本,完成模型拟合与多组结果对照。文章直接使用实跑输出说明设计错误、比较方向、异常计数和独立过滤。数据完全由脚本生成,不代表某种疾病或处理的真实变化,也不是方法准确率测评。
从样本表开始,而不是从差异基因列表开始
实验包含两个批次,每个批次各有三个对照和三个处理样本。因此两个因素彼此交叉,既能在同批次内比较处理与对照,也能区分批次之间的整体变化。拟合采用批次加处理条件的设计,比较目标始终是控制批次后的处理效应。
| 批次 | 对照样本数 | 处理样本数 | 本次作用 |
|---|---|---|---|
| 第一批 | 3 | 3 | 提供批次内比较 |
| 第二批 | 3 | 3 | 提供另一组批次内比较 |
模拟矩阵共有三千零二行。其中两千行按负二项分布生成,部分行加入处理效应,另一些行加入批次效应。同时加入一条全零行、一条单个样本极端偏高的行,以及一千条只有一次计数的稀疏行。它们分别用来检验不同结果状态,而不是凑成一张只会产生漂亮显著结果的输入表。
分析设计要先于看结果确定。实际项目里的批次、供体、处理时间和配对关系,应来自样本采集与实验记录,不能为了让某个候选显著而事后更改。模型只能利用已经存在的比较信息,无法替代缺失的实验设计。方法的计数建模背景可参阅 DESeq2 原始论文。
三种输入错误,我们都实际触发了一次
第一种是给所有计数加上零点二五,再尝试从矩阵创建分析对象。程序明确报出输入含有非整数值。本练习走的是直接计数矩阵入口,因此保持未经标准化的整数计数。若使用转录本定量结果,应使用与该来源匹配的导入方式,不能先把任意连续数值四舍五入,再假装它们都是同一种原始计数。
第二种是把计数矩阵的样本列倒序,样本信息表却不调整。程序指出两边的样本名称顺序不一致。这个失败非常有价值,因为同样十二列、同样十二个名字,并不意味着每一列都对应了正确的分组。只检查集合相等不够,必须检查顺序一一对应,且名称没有重复。
第三种是人为把第一批全部标成对照、第二批全部标成处理,同时保留两个因素的设计。程序报告设计矩阵不满秩。这里处理与批次表达了同一件事,无法从这些样本中区分是哪一个因素导致差异。删掉批次项可能让命令运行,但不会凭空获得原本缺失的识别能力。
这三次失败都在结果记录中保留了原始报错。它们不是让读者模仿的正式输入,而是用于验证入口检查。处理自己的数据时,应先解决这些结构问题,再考虑调参。特别是设计不满秩,不应简单理解为软件故障,也不应靠更换一套统计软件来绕过。
stopifnot(identical(colnames(cts), rownames(samples)))

dds <- DESeqDataSetFromMatrix(
  countData = cts,
  colData = samples,
  design = ~ batch + condition
)
dds <- DESeq(dds)
标准化计数没有自动消除批次
本次拟合得到十二个文库大小因子,范围约为零点七三到一点三二。这些因子用于计数尺度调整,与生成数据时人为设定的倍数不要求完全相同。估计依赖整张矩阵的组成及方法规则,不应根据它是否等于一个预想值,就直接判断标准化正确或错误。
我们另外导出了标准化计数,检查专门加入批次效应的一行。编号为 G0201 的特征,在第一批的标准化计数均值约为二百八十七点四九,第二批约为一千零四十五点五八。虽然拟合设计已经包含批次,导出的这张计数表仍明显保留批次差异。
这说明在模型中控制批次,与把展示用矩阵中的批次成分消去,是两件不同的事。前者改变效应估计的条件,后者属于另外的数据处理目标。本次没有执行批次校正后的可视化变换,也没有把标准化计数称为去批次矩阵。读者做热图或主成分图时,应明确希望展示原始差异,还是某种调整后的结构。
同样,不宜把已经处理过的标准化计数重新输入计数模型,再期待程序第二次调整得更准确。每一步输入都应符合对应方法的假设。计数来源和转换过程应保存在分析记录中,让接手的人能够知道一张矩阵到底经历了哪些处理。
比较方向必须写在代码里
本次显式指定处理相对对照,而不是依赖默认选择。随后在同一个已拟合对象上反转比较,得到对照相对处理。两个结果表逐行核对,所有可用效应估计相加后的最大绝对误差为零,两次可用原始 P 值的最大差也为零。
| 特征 | 处理相对对照 | 对照相对处理 | 原始 P 值 |
|---|---|---|---|
G0001 |
1.714 | −1.714 | 2.5e-21 |
G0081 |
−2.046 | 2.046 | 5.7e-14 |
表中的效应是以二为底的对数倍数变化,表内数值作了适当舍入。第一行正值意味着在本次明确指定的比较中处理组更高,反向比较自然变成负值。不能脱离比较定义,单凭正负号写上调或下调。更稳妥的交付方式是在列名、图注和结果文件说明中同时写出比较方向。
也不要把反转比较看成新的独立验证。两次结果使用同一组样本和同一个拟合对象,方向变化只是在重新表达同一个对比。本实验验证的是代码与解释一致,不能据此说同一个发现得到了两次实验支持。
forward <- results(
  dds, contrast = c("condition", "treated", "control"), alpha = 0.05
)
reverse <- results(
  dds, contrast = c("condition", "control", "treated"), alpha = 0.05
)
第一类 NA 来自全零行
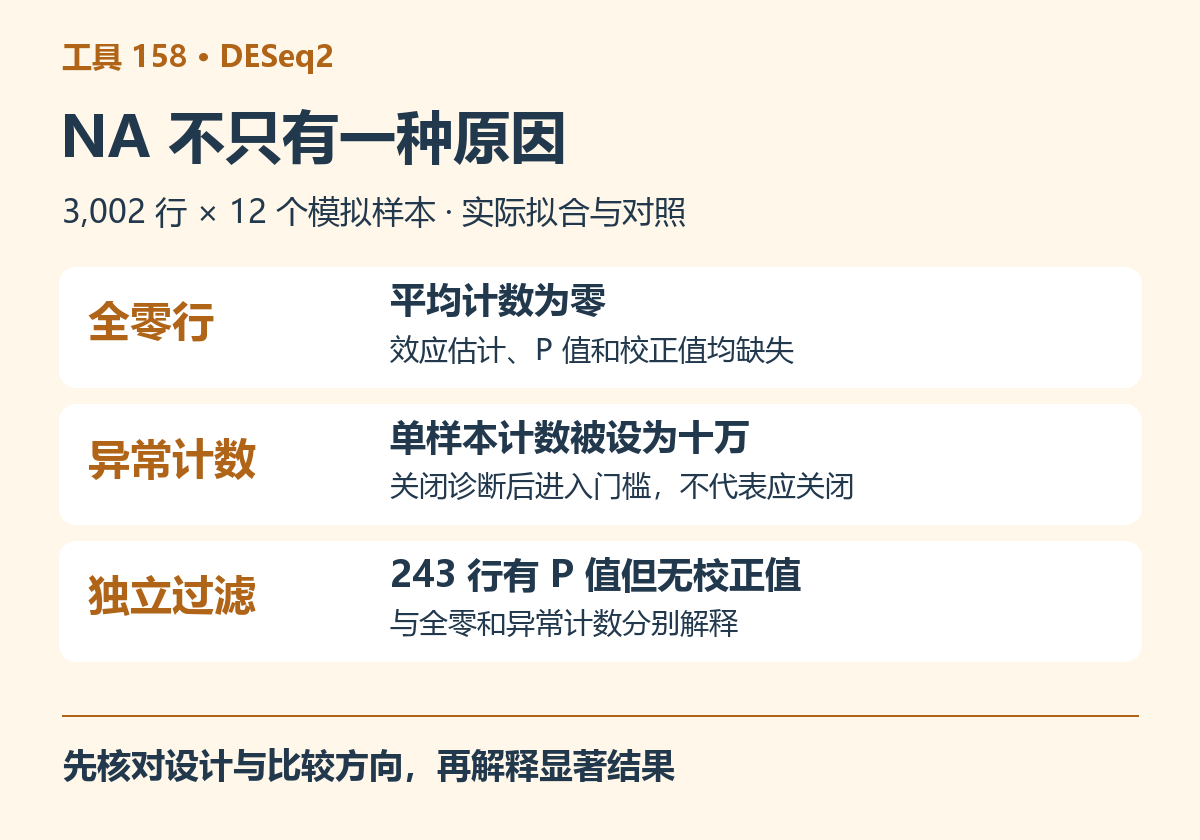
人为加入的全零行在十二个样本中都没有计数。输出的平均标准化计数为零,效应估计、原始 P 值和校正值均为空。这里没有足够的观测信息支持该行的比较,不能把空值替换成零,再把它理解为最显著的一行。
也不应把缺失校正值统一替换为一,随后在报告中说所有这些行都证实没有差异。将缺失值设为一有时是作图程序的显示处理,但那属于展示约定,需要说明,不能改变原来的统计状态。保存原始结果表,比在导出时一次性填满所有空格更可靠。
更实用的做法是为缺失结果保留原因分类。例如先检查整行是否全零,再检查原始 P 值是否缺失,最后检查是否仅校正值缺失。分类过程能告诉读者当前缺的是观测、可接受的检验结果,还是进入多重比较校正的资格,而不是只给出一个笼统的不可用标签。
第二类 NA 与异常计数有关
异常行的前十一个样本计数均为三十,最后一个样本被人为设为十万。默认结果给出了约四点八零二的对数倍数变化,但原始 P 值与校正值为空。这正说明不能只根据效应很大,就把该行排在结果前列。
我们在同一拟合对象上关闭结果提取阶段的 Cook 距离筛查,原始 P 值变为约零点零零二六二六,校正值约零点零四三三七,刚好进入常见的零点零五门槛。这个对照不是推荐关闭筛查,而是展示一个异常样本如何影响你最终得到的候选名单。
面对类似情况,应先查看各样本计数、样本质量和实验记录,理解异常来自真实异质性还是技术问题。未经调查就保留或删除某个样本,都可能改变问题本身。异常值处理还与重复结构和方法设置有关,本次观察不能推广成任意重复数下都会产生同样的空值行为。
因此,报告里应同时保留异常行的计数分布和诊断状态。读者看到很大的效应但没有显著性时,首先需要理解为什么没有给出检验结论,而不是将其视作程序漏算。我们没有在本实验中执行样本剔除或重新测序,也不把一次参数切换当成异常问题已经解决。
第三类 NA 只出现在校正列
默认结果中,原始 P 值缺失的行共有两条,校正值缺失的行共有二百四十五条。两者相差的二百四十三条,有原始 P 值,但因独立过滤没有得到校正值。这个数字来自本次实际运行,不能作为其他数据集的预期比例。
其中 LOW0007 的平均标准化计数约为零点零七零二,原始 P 值约零点八九三七,校正值为空。关闭独立过滤后,同一行的原始值不变,校正值变为约零点九五八。与此同时,全零行和异常行的缺失并没有因此消失,证明这些空值并不是同一个开关造成的。
本实验的一千条稀疏行并非全部被过滤。它们虽然都只有一次计数,但计数落在哪个样本,会影响标准化后的平均水平。把过滤规则简化成凡是低计数就删掉,会遗漏这里的具体计算条件。需要复核时,应查看结果对象保存的过滤阈值及设置,而不是根据肉眼印象猜测哪些行应该为空。
独立过滤和异常诊断等选项的完整定义,可在 DESeq2 官方教程 中查阅。本文所列数值均来自固定的旧版本实跑,不能用在线文档的版本号替换运行记录中的版本号。
显著不为零,与显著超过两倍并非同一个问题
默认比较在校正值小于零点零五时得到一百六十八条。接着我们明确检验绝对对数倍数变化是否超过一,得到一百五十条。这个问题对应的是是否有证据支持变化幅度超过两倍,而不只是是否偏离零。
以第一条特征为例,效应估计仍约为一点七一四,但检验较大效应门槛时的原始 P 值约为零点零零零零三九一四,与默认检验的极小值不同。估计值没有改变,统计问题改变了。结果表不能只根据同样的列名合并,还应记录检验的假设与阈值。
这里也要区分统计检验与结果后的筛选。先检验不为零,再按估计倍数大于两倍截取,与直接检验效应超过两倍,回答的问题不同。本次实际执行了后者。文章没有进行效应收缩,因此也没有把原始估计写成收缩后的排序结果。
large_effect <- results(
  dds,
  contrast = c("condition", "treated", "control"),
  alpha = 0.05,
  lfcThreshold = 1,
  altHypothesis = "greaterAbs"
)
安装与复现中得到的经验
本次使用 R 4.5.2 和 DESeq2 1.50.2,对应 Bioconductor 3.22 的软件系列,版本关系见 该版本软件页面。首次从源包下载主软件时因网络超时失败,随后使用校验过的预编译包放入独立库,再完成加载与拟合。依赖版本和运行提示都保留在记录中。
环境曾提示一个依赖包由较新的 R 补丁版本构建。我们没有把提示删除或描述成完全一致的构建环境,而是记录当前组合已经完成的具体运行。对于需要长期重现的分析,应保存完整会话信息及包来源,不能只记住安装命令。更新依赖之后,也应重新核对关键结果,不应默认与旧环境逐位相同。
下载 本组实跑脚本和结果 后,在有 Docker 的 Linux 环境中运行 DESeq2 目录下的驱动脚本。脚本内含数据生成与分析代码,输出原始计数、样本表、各组结果和会话信息。它使用固定镜像与独立软件库,不需要修改已有项目的 R 包。
python3 run.py run158
优点和局限应放在具体问题中评价
DESeq2 的优点在于能够用明确设计表达比较目标,并提供可检查的效应、标准误和诊断状态。本次同一拟合对象上提取不同对比,使比较方向和检验目标能够被直接核对。对有生物学重复、计数来源清楚、设计可识别的表达分析,这是很有价值的工作方式。
局限在于,它不会替你纠正样本标签,不会从完全混杂的设计中恢复独立效应,也不会把所有空值自动解释成同一个原因。模拟计数上的成功拟合还没有验证读段质控、比对和基因定量。本篇也未运行可视化变换、单细胞分析或真实数据比较,不能把这些能力算作已完成实测。
读完后最值得立即检查的是已有结果的三个位置。比较方向有没有明确写出,样本设计能否支持这个比较,缺失值有没有按来源解释。把这三处补齐,通常比再加一张火山图更能提高结果的可复核性,也能让后续的通路分析围绕正确的候选集合展开。
当这些分析规则需要在多批次数据中稳定复用时,可按项目规模了解 云生信生物信息学分析服务器服务。


