
两张热图颜色差异明显,并不一定说明处理组发生了更强的生物学变化。参考点、链方向、缺失值处理、筛掉哪些区域、按哪个样本排序,以及色标范围,都可能改变读者看到的图形。先核对矩阵中的数值和区域身份,比先调整配色更有帮助。
本文实际运行 deepTools 3.5.6,使用两条自行构造的 bigWig 信号轨道、七个区域,以及独立生成的一百条单端比对记录。我们运行了矩阵计算、热图绘制、顺序恢复和覆盖轨道生成。数据全部用于演示,不来自真实细胞或组织,不进行差异富集检验,也不据此评价真实实验的质量。
一、先拆开信号生成与信号展示
这次实验包含两部分。第一部分直接写入已知信号,方便逐格检查矩阵。第二部分从人工比对记录生成覆盖轨道,核对原始计数与归一化数值的关系。两部分没有混用,热图中的甲、乙轨道并不是后面那一百条比对生成的结果。
矩阵部分包括正链区、负链区、乙高区、甲高区、零值区、缺失区和部分缺失区。甲高区在甲轨道上的四个分箱都为八,在乙轨道上都为一。乙高区则相反。这样,不用观察任何生物学标签,就能判断排序和配色是否把正确的数值呈现在正确的位置。
零值区被明确写入数值零,缺失区则没有写入任何记录。这是本次最重要的输入区别。有些项目导出的轨道会把没有覆盖的位置省略,有些会显式写零,还有些会因为屏蔽或过滤而缺失。仅看到文件没有记录,无法判断缺失的原因,更不能自动认为这些位置经过观察且真实为零。
使用 bigWig 的好处是能够按基因组范围读取已有信号,后续矩阵与绘图可以围绕同一份轨道反复比较。但这个文件本身不携带完整的分析决策。归一化方法、过滤规则和生成命令应另外保存,否则即使图能够重画,也可能已经无法解释纵轴数值。
二、参考点和链方向决定四个格子的含义
本次使用起始参考点,上下游各取一百碱基,分箱宽度为五十。因此每个区域在每条轨道中对应四个格子,两条轨道合计八列。这里的参考点只是对输入区域端点和方向的操作约定,演示区域并没有被验证为真实转录起始位点。
正链区的起点为 1000,在甲轨道上,从参考点上游到下游,四格依次为一、二、三、四。负链区的基因组坐标是 2000 到 2200,我们在参考点附近按基因组从小到大的顺序写入四、三、二、一。实际输出中,负链区同样变成一、二、三、四,说明方向已经按区域链信息统一。
computeMatrix reference-point \
  --referencePoint TSS \
  -R regions.bed -S A.bw B.bw \
  -b 100 -a 100 --binSize 50 \
  --sortRegions keep -p 2 \
  -o default.gz \
  --outFileNameMatrix default.tab \
  --outFileSortedRegions default.bed
读图时,上游和下游因此不总是基因组坐标递增的左右两侧。若将负链基因也按染色体坐标直接画出来,再与已经统一方向的热图比较,容易误判信号峰移动了。一个有效的检查方法是挑选一正一负两个已知区域,分别导出局部数值,确认方向对应关系。
还要区分固定参考点窗口与按区域长度缩放。前者比较的是参考点附近相同距离,后者会把长短不同的区域映射到统一长度。本文只实跑前者,没有把区域缩放后的图拿来当作真实碱基距离。本次四格的宽度可以直接解释为各五十碱基,改变模式之后应重新解释横轴。
三、缺失值补零,为什么把六变成三
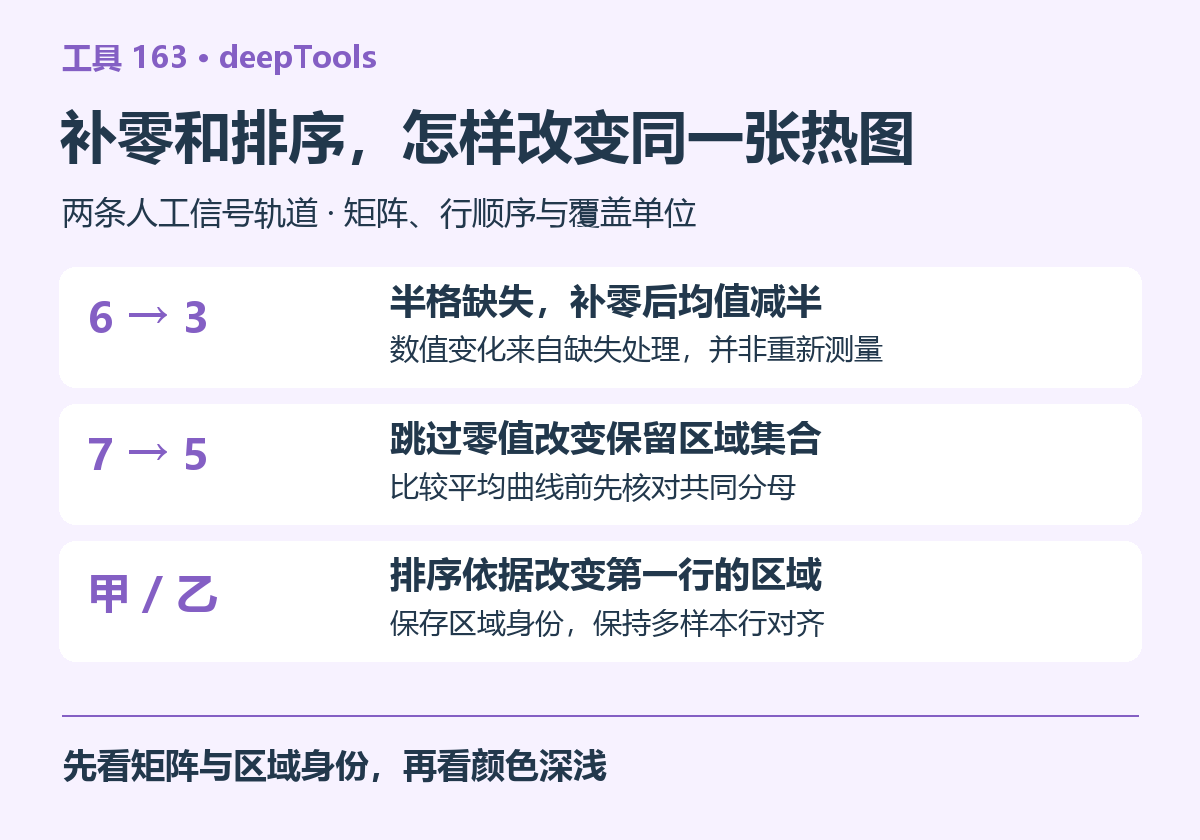
部分缺失区的第一个五十碱基分箱中,只有前二十五个位置被写入数值。甲轨道写入六,乙轨道写入十二,其余二十五个位置没有记录。默认计算得到的第一格分别为六和十二。启用缺失值补零后,第一格分别变成三和六。
这个变化不是信号重新测量,也不是程序做了额外的深度归一化,而是参与均值计算的数值发生变化。原先只对有记录的位置计算,甲轨道得到六。补零后,相同的非零总和被分配到五十个位置,结果减半。对部分被遮蔽或部分不可用的区域,这种差异可能持续影响整张图。
| 区域类型 | 默认处理 | 缺失值补零后 |
|---|---|---|
| 明确写零 | 保留零 | 仍为零 |
| 全部没有记录 | 保留缺失值 | 变成零 |
| 半格有甲信号 | 第一格为 6 | 第一格为 3 |
| 半格有乙信号 | 第一格为 12 | 第一格为 6 |
因此,补零是否合理,要回到轨道生成过程。如果文件省略的位置确定表示观测到的零覆盖,补零与数据含义可能一致。如果它们代表被过滤、无法评估或未提供的数值,补零会额外引入“这些位置没有信号”的假设。参数开关只能执行假设,无法替我们证明假设成立。
我们同时保留了缺失状态与补零状态的完整矩阵。实际项目也可以这样做,选取一小部分区域进行敏感性检查,看看结论是否由大量缺失位置驱动。若两种处理的趋势差异很大,应在图注和方法中交代来源,而不是只保留颜色更好看的一张。
四、删除零值区域,会改变平均曲线的分母
默认矩阵保留七个区域。启用跳过全零区域后,本次输出剩五个,明确零值区与全缺失区都没有保留。缺失值补零再跳过零值,也剩五个。这个结果来自本版本在本输入上的实际行为,不应把参数名称简单理解为“只删除文件里明确写了零的行”。
筛选后,部分缺失区仍在,因为它至少有非零分箱。也就是说,“一行有没有有效信号”和“一行里有没有缺失位置”是两个问题。跳过零值不等于完成缺失值质控,更不等于保证每个留下的区域都被完整观测。
可以用甲轨道第一格做一个手工核对。补零状态下,七行数值相加为十四,按七个区域平均得到二。再去掉全零的两行,总和还是十四,按五个区域平均却变为二点八。这是由本次矩阵直接计算的算术示例,并非另一次真实实验中信号增强了四成。
因此,比较不同条件的汇总曲线时,要检查它们是否针对同一组区域。如果每个样本各自删除无信号行,再分别画平均值,图中变化就同时包含信号变化和区域集合变化。更容易解释的做法是先确定需要比较的区域集合,把多个样本放入同一矩阵,并报告最后保留的区域数量与筛选条件。
五、排序后第一行变了,身份不能靠位置猜
我们对补零并筛选后的同一份五行矩阵绘制三张热图。第一张保持输入顺序,第二张按甲轨道的行均值降序排列,第三张按乙轨道的行均值降序排列。所有图都使用同样的颜色范围,唯一区别是行顺序。
按甲排序,第一行是甲高区。按乙排序,第一行是乙高区。同一张多样本热图内,两个样本的行会共同移动,区域身份仍然对齐。如果把两个样本分开画图、各自排序后再拼在一起,视觉上同一高度的行就未必是同一个区域。
| 排列方式 | 第一行 | 最后一行 |
|---|---|---|
| 保持输入顺序 | 正链区 | 部分缺失区 |
| 按甲信号排序 | 甲高区 | 部分缺失区 |
| 按乙信号排序 | 乙高区 | 甲高区 |
plotHeatmap -m zeros-skip.gz -o sortA.png \
  --sortRegions descend --sortUsingSamples 1 \
  --outFileSortedRegions sortA.bed \
  --colorMap Blues --zMin 0 --zMax 12

plotHeatmap -m zeros-skip.gz -o keep.png \
  --sortRegions keep \
  --colorMap Blues --zMin 0 --zMax 12
第一条明确指定用第一条轨道计算排序依据。第二条明确要求保留矩阵顺序。不要因为矩阵计算时设置过保序,就认为绘图阶段一定不会再排序。本次保留排序后的区域清单,并按区域名称核对第一行与最后一行,让图形变化能够与文本记录对应。
只保存最终图片不足以复现这一步。至少还应保存压缩矩阵、用于绘图的参数、排序后的区域清单,以及样本列顺序。以后增加一个样本时,才能判断应该沿用原来的排序依据,还是有意重新排序,并解释新旧图片为什么出现位置变化。
六、导出区域清单后,还要验证它能否安全复用
这次核对导出文件时,遇到了值得记录的细节。我们输入的是没有外显子分块的普通六列区间,但当前构建导出的排序清单包含更多列。其中一个区域范围为 3000 到 3200,附加的块起点字段却为 2997,不能直接将这组附加字段当作普通单块 BED12 结构使用。
本文没有据此推断所有版本都存在同样问题,也没有修改原始实测输出来掩盖它。因为我们只需要恢复普通区域的排列顺序,脚本提取前六列,另存为顺序清单,再交给矩阵操作工具排序。实际运行后,恢复出的区域名称顺序与目标顺序完全一致。
awk 'BEGIN{FS=OFS="\t"} !/^#/ {print $1,$2,$3,$4,$5,$6}' \
  sortA.bed > sortA.bed6

computeMatrixOperations sort \
  -m zeros-skip.gz -R sortA.bed6 -o restored.gz
下载脚本用等价的 Python 文件处理完成前六列提取,并实际运行后一条命令。这里舍弃附加列是因为输入对象本来就没有分块结构。如果真实任务需要转录本外显子信息,不能照搬这个操作,把分块列删除后仍声称保留了原来的转录本定义。
七、一百万的覆盖数值,并不表示测了一百万条读段
独立的覆盖实验写入一百条单端比对,每条长五十碱基,起点与方向相同,名称不同,且没有启用重复过滤。它们全部覆盖同一个五十碱基分箱。运行不归一化的覆盖计算,输出该格为一百。改为按百万比对归一化后,该格变为一百万。
计算很直接,一百条计数除以一百条总比对所对应的百万单位,即一百除以零点零零零一。这个人为例子说明轨道数值带有单位,较大的归一化值可能只是分母较小,不意味着测序量非常大,也不能单独证明富集可信。
bamCoverage -b fixture.bam -o raw.bedgraph \
  --outFileFormat bedgraph --binSize 50 \
  --normalizeUsing None --exactScaling -p 2

bamCoverage -b fixture.bam -o cpm.bedgraph \
  --outFileFormat bedgraph --binSize 50 \
  --normalizeUsing CPM --exactScaling -p 2
我们故意让这些比对具有相同位置,目的是让数值可以立即核对,不是在提出真实数据保留重复的建议。真实文库的重复处理应考虑实验类型、文库复杂度及上游流程,并在比较样本时保持一致。本例也没有双端片段、输入对照或外源参照,不能把其计数单位推广成所有实验中的分子数量。
八、从一张能画出的图,走向一张能解释的图
这组实验的经验是,绘图问题可以分层排查。先确认区域和方向,解释横轴。再确认轨道的生成方法,解释数值单位。然后检查缺失与零值,解释分箱均值。最后核对筛选、排序和色标,解释图中区域集合与颜色差异。前一层没有确定,后一层的美化很难补救。
deepTools 的优势是把覆盖轨道、数值矩阵和图形连接起来,能够保留适合复查的中间文件。限制是这些连接依赖明确的输入语义。热图的聚集或分离可以帮助发现模式,却不能替代重复样本的统计检验。本次只构造两条轨道,没有估计生物学变异,也没有计算显著差异区域。
下载本组三篇复现脚本与实测记录,在有 Docker 的 Linux 环境运行本工具目录下的脚本,即可重建轨道、矩阵和三张热图。本次固定使用 3.5.6 环境,实际 Python 为 3.12.8,读取轨道与比对文件的依赖版本也写入结果。固定版本是为了复现本次行为,不表示它是当前最新版本。
python3 run.py output
定义与参数可以进一步查阅 computeMatrix 文档、plotHeatmap 文档、矩阵操作文档 和 bamCoverage 文档。本文所列数值与顺序来自本次可下载记录。
当轨道单位、区域集合和绘图口径都核对清楚后,若需扩展到多样本的大批量信号计算,可携带样本数量、轨道规模和复现参数,通过云生信生物分析服务器服务评估环境与任务安排。


