
同样一份目标基因型,Minimac4 为什么默认没有 GT 列,增加一个参数后又多出一个位点?为什么任务显示完成,结果却只有表头?这些问题与补全算法的准确率不同,却会直接影响后续关联分析有没有读对数据。本文实际安装并运行 Minimac4 4.1.6,用有已知答案的合成数据拆开输入、输出和质控之间的关系。
本次使用八十个参考样本、三十个目标样本和六百个参考位点。目标保留四百八十个参考位点,另加一个目标独有位点。所有正常输入已定相且没有缺失,单倍型由八条原创模式分块组合,不包含真实个体或第三方参考面板。这个设计适合检查参数行为,不能用于评价真实人群的填补准确率,也不构成速度比较。
一、先确定任务边界,再选择文件
Minimac4 的任务是借助参考单倍型推断目标中未检测的变异。输入已经完成定相,是这里最重要的前提。定相决定同一个个体的等位基因怎样沿染色体连接,补全则利用这种连接寻找参考中的相似片段。把杂合位点的斜线换成竖线,只是改变记录方式,没有增加任何相位证据。官方示例明确把目标文件描述为已定相且有索引的基因型数据。官方仓库与用法
因此,整理输入时不能只查看文件是否存在。应先核对参考基因组版本、染色体名称、位点坐标和等位基因方向,然后确认样本标识唯一、位点有序、索引与文件匹配。一个位置相同但参考和替代等位基因不同的记录,不应直接当成同一标记。插入缺失还涉及表示方式和规范化,不能只凭变异编号连接两份表。
参考面板与目标数据承担的角色也不同。参考提供单倍型模式和候选补全位点,目标提供该样本已经检测到的锚点。增加目标样本不会自动增加参考面板所覆盖的变异。对于参考中不存在的位点,保留原始观测与预测未观测基因型是两件事,后面增加的目标独有位点正是用来检查这一区别。
二、固定版本,并保留一个可重做的小实验
本次在 Linux 中使用固定摘要的容器运行,辅助工具为 BCFtools 1.25。镜像摘要、输入生成种子、完整命令和原始日志都包含在练习包中。下面展示的是实际使用的主要命令,运行脚本会自动生成输入并执行各组对照。
docker pull quay.io/biocontainers/minimac4@sha256:cdf67fb7fe83cc2aeeb4dac927777e68d6edc4d95bff79a969326d4b49b80f08
python3 195-minimac4/run.py output-minimac4

# 以下命令在已有 minimac4 的环境中执行
minimac4 --version
minimac4 --compress-reference reference.vcf.gz -o reference.msav
minimac4 reference.msav target.vcf.gz --threads 2 -o default.vcf
minimac4 reference.msav target.vcf.gz --threads 2 \
  --format GT,HDS,DS,GP --empirical-output empirical.vcf \
  --sites sites.vcf -o all_fields.vcf
这里使用当前实测版本的位置参数形式。网上旧教程中的参数名、参考压缩格式和默认输出,不能不加核对地复制到另一版本。先查看本机帮助,再固定运行命令,通常比在报错后反复调整文件名更有效。参考压缩是单独的准备步骤,应保留原始文件摘要和压缩命令,方便后续区分参考内容变化与软件变化。
本例压缩参考得到一万九千六百零二字节的文件,但这个数字没有通用容量规划意义。输入具有刻意设计的重复单倍型模式,规模也很小。实际数据中的样本数、变异密度和局部单倍型复杂度都会改变文件规模。本文只把它作为本次实验的可核对结果,不用它推算全基因组资源需求。
三、六百行与六百零一行各自代表什么
| 实际运行 | 输出位点数 | 其中参考独有位点 | 目标独有位点 |
|---|---|---|---|
| 默认运行 | 600 | 120 | 不保留 |
| 显式输出四类字段 | 600 | 120 | 不保留 |
| 增加 all-typed-sites | 601 | 120 | 保留 |
| min-r2 设置为 0.95 | 585 | 105 | 不保留 |
| 独有位点移到参考末端之外,再开启 all-typed-sites | 600 | 120 | 不保留 |
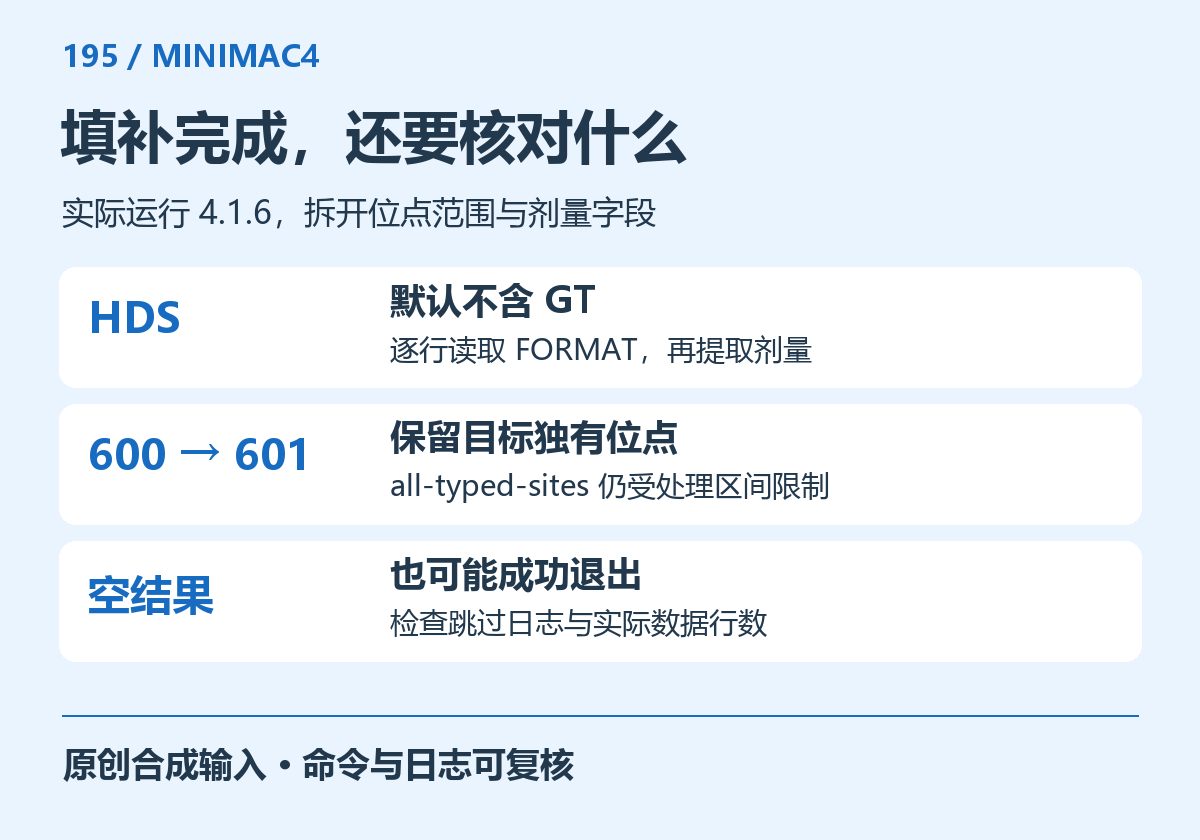
正常实验把目标独有位点放在参考覆盖范围内部。默认结果没有这个位点,开启 --all-typed-sites 后才出现。它的输出带有 TYPED 标记,基因型仍为输入的零竖线一,剂量为一。这表示已有观测被保留下来,不能把新增的这一行归功于参考预测能力。
我们又把同一个位点移到六百零一万的位置,参考最后一个位点则在六百万。即使开启上述选项,输出仍是六百行。运行日志显示这次处理的区间止于六百万。因此,选项是否保留目标独有记录,还受到实际处理区间限制,不能理解为对整份目标文件无条件取并集。版本源码也在当前处理区间内统计这类记录。区间与目标独有位点处理
这次对照给出的实用经验是,检查位点丢失时先建立分类表。区分参考独有、目标独有、双方共有,再分别检查坐标范围和筛选条件。如果只比较输入与输出总行数,同样少一行可能对应完全不同的原因。对于分块作业,还应记录每块的实际输出起止位置,避免将范围外的记录误判为质量过滤。
四、默认没有 GT,并不代表没有结果
实际默认输出的 FORMAT 只有 HDS。显式要求四类字段后才出现 GT、HDS、DS 和 GP,而且不同记录的字段排列顺序并不完全一样。我们的解析程序逐行读取 FORMAT,再按字段名提取数值。依赖固定的冒号位置读取剂量,会在文件正常、列数正常的情况下拿到错误字段。
对于本例的二倍体、双等位基因位点,HDS 给出两条单倍型各自的替代等位基因剂量,二者相加得到 DS。GP 按替代等位基因数为零、一、二给出概率,因此剂量也可以用第二个概率加上第三个概率的两倍计算。这个关系需要位点类型和概率顺序成立,不能直接套到多等位基因或不同倍性的记录。
例如,位点 v5 的样本 T1 输出 HDS 为零点九四四和零点九九九,DS 为一点九四三,GT 为一竖线一。GP 分别约为零点零零零零五六、零点零五六八八八和零点九四三零五六。硬判定保留的是一个离散类别,剂量保留的是概率期望。后续若需要剂量,就应读 DS 或按明确规则计算,不能用硬判定的整数计数替代而不说明。
脚本逐个检查所有含相关字段的记录。此次 DS 与 HDS 和的最大差异处于浮点误差量级,与 GP 推导剂量的最大差异约为十的负七次方。检查时应允许打印精度造成的小误差,同时拒绝明显超界和概率和异常。也要区分没有字段与数值恰好为零,缺失标记不能转换成零剂量。
五、高 R2 不能代替外部验证
设置最低 R2 为零点九五后,输出从六百行减少到五百八十五行。本例减少的十五行全部来自参考独有位点。默认填补中,这些参考独有位点共有三千六百个样本基因型,硬判定剂量与生成真值不一致的有三十三个。筛选后保留的那部分恰好没有此类错误,但这不能解释为阈值对其他数据也保证无错。
筛选改变了被评价的对象。只报告保留部分的正确率,会隐藏被排除位点的数量、频率范围和难度。一个可比较的结果应同时报告保留率和错误指标,并按频率分层。否则提高阈值使困难位点消失,看起来更好的数字可能只是评价集合变容易了,而不是预测方法有了进步。
还要区分模型内部质量指标与拿独立真值计算的经验一致性。前者可以用于筛选和诊断,后者才直接比较预测与已知答案,但也受验证样本和位点选择影响。我们的合成数据共享简单的祖先模式,既不覆盖真实群体差异,也不包含测序错误。它可以证明检查脚本确实发现了差异,不能支持人群层面的性能结论。
六、经验输出与位点信息表不要混着读
本次 --empirical-output 产生四百八十行,每行包含 GT 和 LDS。文件头将 LDS 定义为假定该位点未检测时的留一法单倍型剂量。这与主结果中直接利用已检测位点信息的输出不同,适合用来理解锚点在被遮蔽后能否由其他信息恢复。它不是额外采集的一批独立样本。输出字段的版本实现
另一方面,sites 文件有六百行,但没有三十个样本的基因型列。它用于保存位点层面的信息。把这种文件交给需要每个样本剂量的下游程序,不能因为记录数与主结果一致就认为输入完整。文件名只是提示,真正的判断依据是表头、字段定义和样本列。
实际交付时,建议同时写清每个文件的分析单位。主结果是一条变异对应多个样本的推断,经验输出是一组已观测锚点的遮蔽诊断,位点表则不包含逐样本结果。先确认单位,再连接表格,可以避免把一个位点的质量数值重复当成每个样本各自独立的证据。
七、退出码为零,还必须检查输出是否为空
目标与参考共有四百八十个位点,参考共有六百个位点,本例日志中的比例为零点八。我们故意把 --min-ratio 调高到零点九,使条件不满足。默认行为返回非零退出码。改成 --min-ratio-behavior skip 后,程序返回零,却跳过了整个区块,输出只有表头,没有数据行。
这不是一组推荐参数,而是用于验证任务管理流程能否识别不完整结果的负对照。不能为了让任务显示成功就长期采用跳过模式,又不核对区块覆盖情况。更完整的完成条件应包含退出码、数据行数、实际区间、样本数和日志中的跳过记录。只看文件存在,甚至只看文件能正常打开,都不足以判断分析完成。
如果一个全基因组任务分成很多块,个别空块也可能被总文件大小掩盖。应逐块生成清单,再汇总预期范围与实际范围的差异。遇到密度异常,应回到输入检查共享锚点是不是太少、坐标有没有错位、参考版本是否匹配,而不是先放宽阈值掩盖问题。
八、能接受未定相符号,不等于能替你定相
最后一组负对照只把目标中的竖线改成斜线,保持每个位点两个等位基因的排列顺序不变。软件仍完成运行,计算出来的一万八千个剂量与正常输入一致。随后我们随机交换部分杂合位点的左右顺序,未定相基因型本身没有改变,但相邻位点原有的连贯关系被破坏了。
第二份未定相输入也成功运行,其中六千八百七十八个剂量发生变化,最大差异约为一点二四三。这个结果说明,成功读取文件不能替代输入相位的验证。软件没有因为本例中的斜线就替我们恢复原来正确的跨位点连接。若把随意排列的杂合记录直接投入填补,输出仍可能外观正常,却已经换了推断依据。
复现时请先检查练习包中的预期结果,再替换为自己的小区间。保留样本顺序、位点集合、字段关系和跳过日志四类检查,比单独保存一条运行命令更有用。真正扩大任务规模前,应先用独立验证数据建立适合研究目的的质量标准,再决定保留哪些位点和怎样向下游传递不确定性。
当这套输入核验、分块记录与结果检查流程需要扩展到更多样本时,可了解云生信生物信息学分析环境与计算服务。


