
运行贝叶斯建树时,很多人习惯盯住日志中的平均分支频率标准差。数值变小,看起来就可以结束分析。但这个指标主要比较独立运行对分割关系的采样情况,并不保证所有连续参数已经得到充分采样。
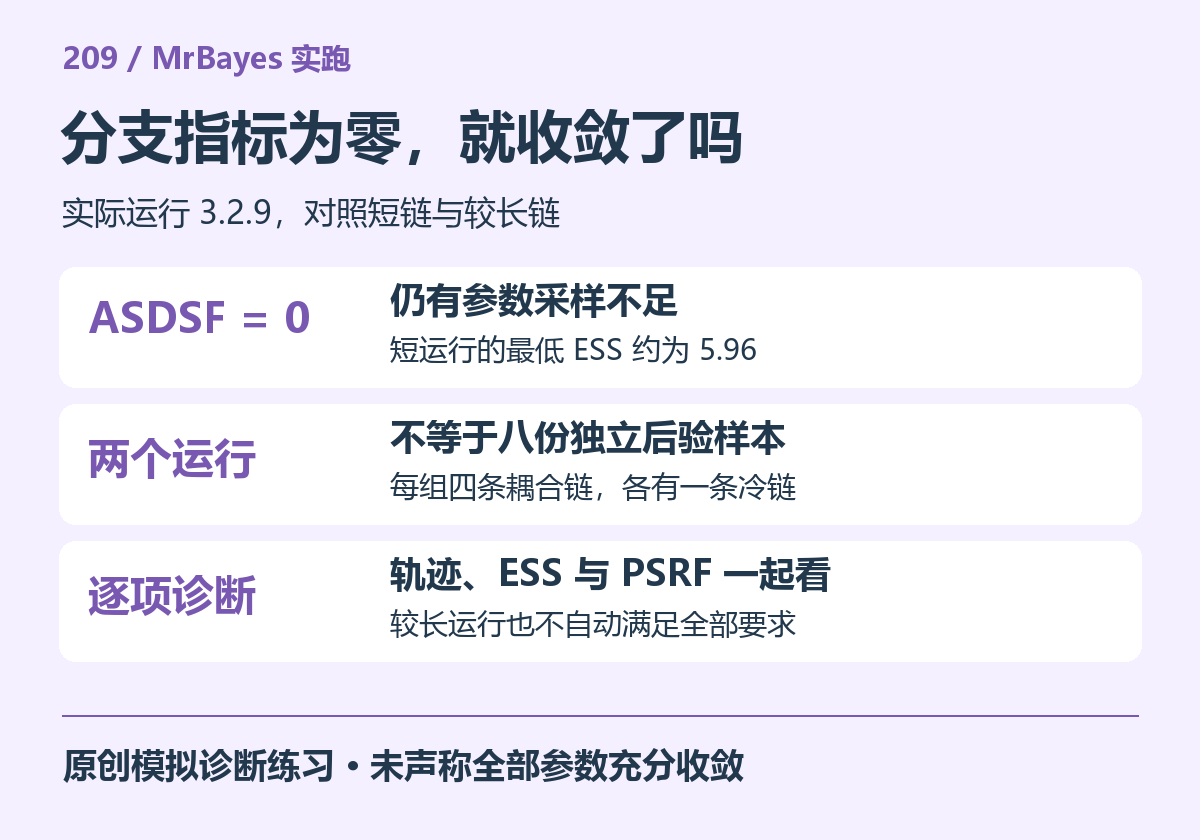
本文实际运行 MrBayes 3.2.9,用同一组人工序列分别完成两千代的试运行和五万代的较长运行。两组的分支频率差异都为零,但短运行中有参数的有效样本量不足六,较长运行中也仍有参数采样效率偏低。这个例子可以帮助理解,树看起来稳定与整套分析充分收敛之间还有哪些检查。
后验推断需要检查的不止一棵树
MrBayes 通过马尔可夫链蒙特卡洛方法,对树及模型参数的后验分布进行采样。最终看到的树通常是样本集合的汇总,而不是一次优化得到的单个最佳结果。
后验分布依赖输入、似然模型和先验。若采样尚未充分探索该分布,即使能够输出带概率标签的树,也不能把这些标签当成可靠的最终估计。计算完成与采样质量合格是不同的验收条件。
不同诊断关注不同层面。分支频率差异用于比较运行之间的树分割频率,参数尺度诊断关注连续参数在运行间的表现,有效样本量关注相关采样所提供的信息量。没有一个单独数字能够完整替代其余检查。
官方项目介绍说明了后验采样与收敛诊断功能。官方手册入口还介绍了命令帮助和模型设置查询。本文除了查看文档,也实际运行了模型显示与帮助命令,将当前版本的设置一并保留。
输入与两组运行怎样设置
本次生成八条人工 DNA 序列,每条六百列。输入来自固定树结构上的简单替换模拟,使用固定随机种子,没有真实物种来源、缺失数据或生物学研究结论。
分析模型使用六类可逆替换率,并允许位点速率按四类别离散伽马变化。每组设置两个独立运行,每个运行包含四条耦合链。试运行执行两千代,每二十代保存一次。较长运行另行启动,执行五万代,每五十代保存一次。
较长运行不是在试运行的文件上追加,而是使用另一个随机种子开展的独立任务。因此,两者可以用来比较当前设置下的诊断表现,但不能把差异严格归因于仅改变代数这一个因素。
两组都在汇总时丢弃前百分之二十五的样本,并关闭根据诊断自动提前停止的选项。这样能够检查指定代数的实际输出,而不是让某个单独指标决定本次练习何时结束。
完整生成、运行与结果解析代码见本组三篇复现包。在具备 Python 3 和 Docker 的 Linux 环境中,运行 209-mrbayes/run.py 并指定新工作目录即可复现。脚本固定镜像摘要,实际版本为 3.2.9,并保存参数采样与汇总文件。
两个运行乘四条链,不是八套独立后验样本
每个独立运行中的多条链通过不同温度帮助探索参数空间。用于通常后验汇总的是冷链样本,较热的链用于辅助探索与交换。不能把四条耦合链当成四份相互独立的目标后验样本直接合并。
本次设置两个独立运行,因而产生两份主要参数采样文件。它们用于观察不同运行是否获得相近的后验分布。每个运行内部的四条链负责改善探索,两种数量有不同含义。
如果把链数增加误当成独立运行数增加,就可能高估独立重复的数量。相反,只增加独立运行数量,而每组都混合很慢,也不能自动解决采样问题。应先观察当前困难出现在探索、交换还是参数相关性上。
较长运行的配置片段如下。文件前半部分还包含完整的 NEXUS 数据块,由复现脚本自动生成。汇总命令对参数与树分别执行,并明确使用相同的丢弃比例。
begin mrbayes;
set autoclose=yes nowarn=yes usebeagle=no seed=210 swapseed=310;
lset nst=6 rates=gamma;
mcmcp nruns=2 nchains=4 ngen=50000
      samplefreq=50 printfreq=5000 diagnfreq=5000
      relburnin=yes burninfrac=0.25
      stoprule=no filename=longer;
mcmc;
sump relburnin=yes burninfrac=0.25;
sumt relburnin=yes burninfrac=0.25 contype=halfcompat;
end;
先验必须看实际设置,不能只凭旧教程记忆
本次模型显示结果中,六类替换率比例使用六个参数均为一的狄利克雷先验,四种碱基频率同样使用对称的狄利克雷先验。速率形状参数使用参数为一的指数先验。
分支长度的实际默认设置则显示为 GammaDir(1.0,0.1000,1.0,1.0)。因此,不能看到命令里没有显式修改先验,就沿用其他版本教程中的默认值描述本次运行。版本固定和实际模型输出都需要保存。
这些先验会参与后验推断。本文没有比较不同先验,也没有把默认值当成所有真实项目的最佳选择。对数据较少或参数不容易识别的情况,先验的影响尤其值得结合研究问题检查。
复现记录应包含似然模型与先验,而不仅是一个常见模型缩写。相同的替换模型、不同的先验或分区设置,仍可能形成不同的分析。报告完整条件,才能让读者判断结果适用于什么范围。
分支频率差异为零,参数诊断却不理想
本次试运行在各次诊断中报告的平均分支频率标准差均为零。较长运行中也同样为零。若只使用这个指标作为结束条件,两组看起来都已经非常稳定。
但参数汇总显示,试运行中碱基 A 频率的最小有效样本量约为五点九六,某个替换率参数的尺度诊断约为一点三七五。也就是说,不同参数的采样表现并不与树分割指标同步。
| 检查项 | 2000 代 | 50000 代 |
|---|---|---|
| 分支频率差异 | 0 | 0 |
| A 频率最小 ESS | 5.96 | 113.10 |
| G/T 速率 PSRF | 1.375 | 1.000 |
| 总枝长最小 ESS | 76.00 | 641.04 |
这里的最小有效样本量来自程序在两个运行之间汇总的参数表,不是将两个运行的样本简单相加。尺度诊断趋近一,是运行间表现相近的一项证据,也不能单独证明已经充分探索所有可能区域。
较长运行确实改善了多项诊断,但仍有参数的最小有效样本量约为四十八点三一。因此,本文没有将五万代结果宣布为所有参数均已充分采样,也没有用它交付任何真实生物学结论。
这个控制说明,清晰的树分组可能较早稳定,而连续参数仍然存在明显相关性或探索不足。一个漂亮的共识树图,可能让人忽略这些尚未解决的问题。验收时应逐项查看参数,而不能只挑表现最好的一个指标。
保存一千个样本,为什么不等于一千个有效样本
试运行每个独立运行实际保存一百零一个状态,包括第零代。丢弃前百分之二十五后,剩七十六个。较长运行每个独立运行保存一千零一个状态,按同样规则留下七百五十一个。
有效样本量与这些计数不同。相邻状态通常相关,很多看起来不同的行并不提供同等数量的独立信息。因此,参数表中的有效样本量可以远小于文件行数,而且不同参数也可能有不同的有效样本量。
简单增加输出频率,通常只是更密集地记录相邻状态,不会让链自动探索得更充分。输出文件变大,不等于有效信息按比例增加。是否需要更长运行、调整探索方式或重新审视模型,应结合实际诊断判断。
本次总枝长在较长运行中的有效样本量较高,但某些替换率参数较低。这提醒我们,不应拿一个参数的良好表现代表全部参数。尤其当研究结论直接依赖某个速率或形状参数时,应优先审阅那个参数的轨迹和估计精度。
还要注意不同汇总文件的内容。参数汇总表与树分支参数汇总表可能给出不同的诊断范围。看到树汇总末尾的一个平均值,并不能据此替代替换率、碱基频率和形状参数各自的检查。
丢弃前四分之一样本,不是自动修复办法
本次使用固定的百分之二十五丢弃比例,是为了让两组练习具有明确的汇总规则,并不是因为这个比例能够保证所有分析摆脱初始状态影响。
真实任务应查看轨迹是否仍有趋势,独立运行是否停留在相近区域,关键参数是否具有足够的信息量。若链长时间停留在不同区域,简单多删前面的样本,可能减少本就有限的数据,却没有解决探索不足。
参数与树的汇总也应使用一致、可解释的丢弃规则。如果参数汇总丢弃四分之一,而树汇总采用了另一个范围,就需要说明原因。否则,报告中的参数估计与共识树可能来自不同的样本集合。
在检查采样文件时,应先确认代数范围、保存频率和实际行数。第零代是否写入,会影响简单的行数计算。本文直接读取原生文件核对,而不是仅用总代数除以保存间隔推算。
对于续跑任务,还要明确汇总是否包含旧样本,是否出现重复代数,以及追加文件与原模型设置是否一致。重复追加或错误拼接可能让文件看起来样本更多,实际却没有增加独立信息。
共识树中的概率需要怎样解释
共识树中的分支频率来自保留的后验树样本。它与最大似然流程中的自举支持度具有不同计算背景,不能仅因两者都能显示成百分比,就用同一含义解释。
如果采样充分,后验分支概率表达的是在给定数据、模型与先验条件下的结果。它没有排除模型不适合、输入比对有误或先验选择不合理等问题。采样不充分时,还额外受到数值探索不足的影响。
多数规则共识会保留满足相应频率条件的分组,并不要求所有分支都形成完全二分的树。存在未解决关系时,不应为了图形更整齐而随意补分支。展示上的完整与证据上的充分是不同要求。
本文保存共识文件用于检查流程,但不将人工样本标签解释为真实物种关系。读者更应该关注怎样从运行记录走到可审阅的后验汇总,而不是记住本例中某一条分支的具体概率。
实际工作中怎样决定下一步
先检查运行是否按预期完成,样本文件是否覆盖目标代数,再逐项看轨迹、有效样本量和运行间诊断。对表现不佳的参数,应判断是运行太短、探索效率低,还是当前数据对复杂模型中的某些部分约束较弱。
如果继续运行,应保留新的诊断过程,并重新核对估计是否稳定,而不是只等到文件达到某个固定大小。若改变温度、先验或模型,则应记录为新的设置,避免把不同条件下的样本不加说明地合并。
MrBayes 的优势是能够表达树与参数的不确定性,并提供丰富的诊断信息。相应的要求是,使用者需要真正审阅采样过程。程序能够生成概率标签,并不代表这些标签已经达到可以交付的精度。
本次实跑最有价值的结果,恰恰是分支频率指标为零而其他诊断仍不充分。把这个现象保留下来,比把所有输出都包装成“成功收敛”更有助于建立可靠的分析习惯。
当多组独立运行、较长链和参数敏感性比较需要统一管理时,可按实际任务了解云生信生物分析服务器服务。


