
修改结构预测模型时,损失下降通常是最先看到的好消息。但同一个分数变小,可能来自坐标更准确,也可能来自参与比较的点变少,或者大误差被截断。只看训练曲线,无法区分这些情况。尤其是把自己的坐标、残基掩码接入已有模型时,一次没有报错的前向计算,远不足以说明输入含义正确。
本文安装 OpenFold 2.2.0,直接调用其官方 FAPE 函数,并对输出做反向传播。实验使用人工构造的局部坐标系与空间点,检查整体刚体变换、局部位移、误差截断和有效掩码。本次没有下载预测权重,没有训练网络,也没有生成蛋白质结构,属于已安装软件的损失组件实跑。读者可以用同样的检查定位自己的训练数据接口问题。
为什么从一个损失函数入手
OpenFold 提供了可研究和修改的 AlphaFold2 类模型实现,适合需要检查训练流程、数据处理或网络组件的研究者。它的价值不只在于运行一次预测,还在于可以把某个环节拆出来观察。有关完整模型的训练和泛化结论,应阅读原始研究,不能由本文的几个小算例推导。
对多数刚开始读源码的人,直接启动完整训练很难排查问题。数据、模型、优化器、并行和损失同时参与,一条异常曲线可能有许多解释。先固定其他条件,只改变一个输入因素,能够得到方向明确的预期。例如整个物体换了空间朝向,内部形状没变,合理的结构误差不应该因此大幅增加。
FAPE 可以理解为在局部坐标系中比较对应点的位置误差。对于一对对应的预测与参考坐标系,分别把点变换到各自的局部坐标,再比较位置。这里既有“哪个坐标系”,也有“哪个点”,所以最基本的比较对象是坐标系与点的配对。把它误当成每个残基仅贡献一个独立距离,会影响对掩码、平均方式和链间误差的理解。
这也决定了本文的教学顺序。先证明整体刚体变换没有改变分数,再观察真正的局部偏差,最后改变参与平均的配对集合。只有先知道正常情况应该怎样,后面遇到异常小的损失才有检查依据,而不是凭经验判断一个数字看起来是否合理。
安装的是固定版本,验证的是指定组件
本次使用 Linux、Python 3.10.12、PyTorch 2.5.1+cpu、NumPy 1.26.4、Biopython 1.84、ml-collections 0.1.1 与 dm-tree 0.1.9。OpenFold 固定在 v2.2.0 对应提交,使用该版本自带的 CPU 编译分支构建安装包,没有修改损失函数源码。
下面是本次组件环境的安装方法。系统还需要可用的 C++ 编译工具。这不是完整预测环境的替代方案,完整推断与训练应另行遵循官方安装文档,准备对应资源及依赖。
python3 -m venv of-fape-env
source of-fape-env/bin/activate
pip install pip==24.3.1 setuptools==75.8.0 wheel==0.45.1 packaging ninja
pip install torch==2.5.1+cpu --index-url https://download.pytorch.org/whl/cpu
pip install numpy==1.26.4 ml-collections==0.1.1 biopython==1.84 \
  dm-tree==0.1.9 scipy==1.14.1 einops==0.8.1
git clone https://github.com/aqlaboratory/openfold.git
cd openfold
git checkout e938c184a291bf053af3b14c1e3e8bb29aee57e2
MAX_JOBS=1 pip install --no-build-isolation --no-deps .
cd ..
python 233-openfold/run.py ./openfold-fape
下载实跑脚本与完整结果。脚本直接导入安装后的函数,输出版本、源码校验值、实验参数、分数和梯度。本次安装后的损失模块校验值以 e82c0b9c 开头,完整值保存在结果文件。复核时,应先确认自己导入的是目标环境中的模块,避免当前目录下的旧源码遮蔽已经安装的版本。
这里把编译并发限制为一个任务,把计算线程设为两个,只是为了让小实验的环境容易控制。它不构成完整模型的性能测试,也不能拿运行小张量的时间估算训练耗时。是否安装成功、某个函数是否可执行、整个训练流程是否可用,是三个需要分别保留证据的结论。
整体旋转平移后,为什么误差几乎不变
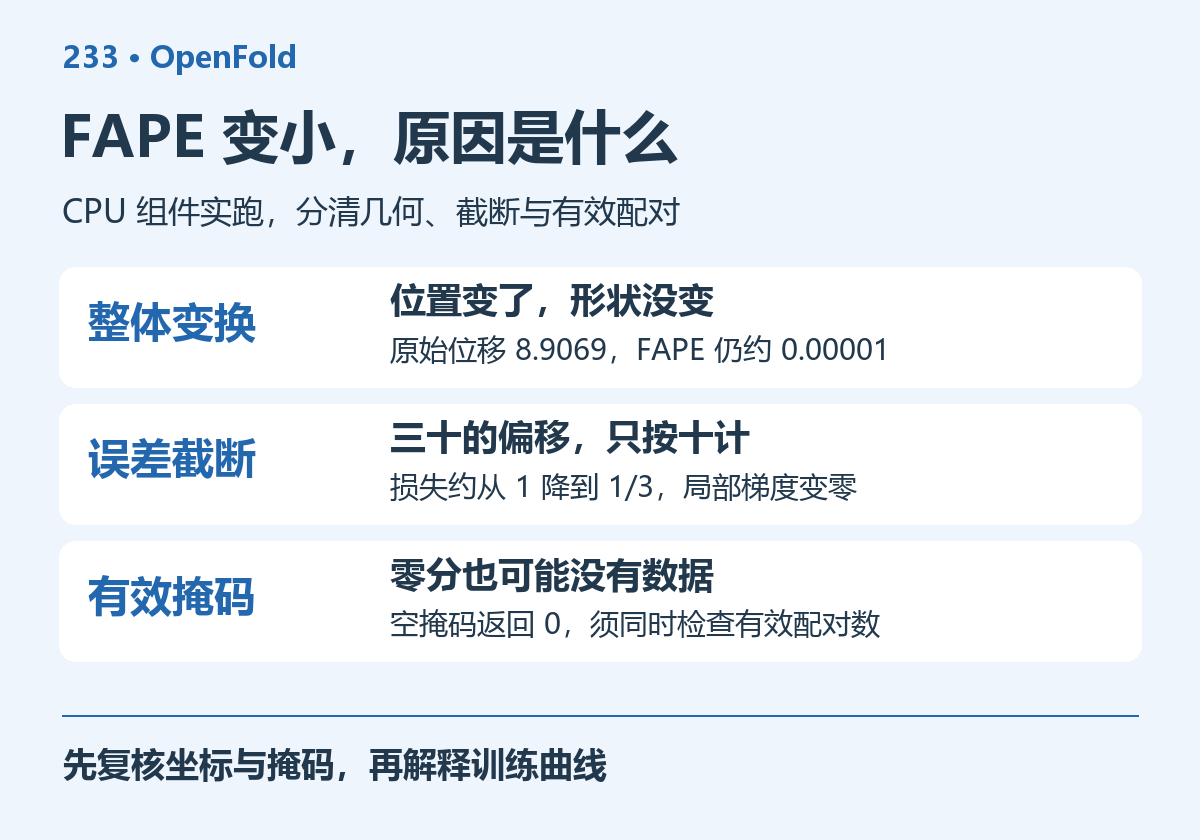
第一个实验包含三个参考坐标系和三个参考点。我们先让预测与参考完全一致,再把预测侧所有坐标系和所有点一起旋转九十度并平移。对应点在原始空间中的均方根位移约为 8.9069,但两次 FAPE 都约为十万分之一。
这个结果说明,整体改变物体在空间中的位置和朝向,没有改变其内部几何关系。未经叠合的坐标位移很大,与局部坐标中的结构误差很小,并不矛盾。这里报告的是原始坐标位移,没有进行最优结构叠合,不能把它与其他软件报告的叠合后均方根偏差直接比较。
随后我们故意只移动点,不更新预测坐标系,分数升至约 0.881913。程序仍然可以执行,因为张量形状完全合法,但坐标与坐标系不再描述同一个变换后的对象。这个对照非常适合检查数据增强,旋转了原子坐标,却遗漏了局部框架或其他几何特征,会造成一种不容易从维度检查发现的错误。
真实项目中,整体变换测试应尽量放在完整数据转换之后。如果只测独立数学函数,却没有覆盖自己生成坐标系的代码,仍可能漏掉上游方向约定或残基对应错误。变换之后比较的不仅是一个总分,还应检查点数、掩码和残基顺序是否保持一致。
| 人工实验 | 实测 FAPE | 检查重点 |
|---|---|---|
| 预测与参考一致 | 0.000010 | 数值基线 |
| 整体旋转并平移 | 0.000010 | 内部几何保持 |
| 只移动点 | 0.881913 | 坐标系是否同步 |
| 一个点偏移三十 | 1.000007 | 未截断误差 |
| 同一偏移,截断十 | 0.333340 | 大误差饱和 |
完全一致为什么不是严格零
本次调用显式使用长度尺度十,数值稳定项为一亿分之一。在距离的平方和中加入这个稳定项,再开平方并除以长度尺度,就会出现约十万分之一的基线。输入完全一致时出现这个小正数,不表示结构仍存在可解释的生物学差异。
因此,验证程序时不宜直接断言结果必须严格等于零。更合适的做法是根据本次参数和数据类型设置容差,并同时比较变换前后的差值。如果改了稳定项、归一化尺度或上层包装函数,基线也可能变化,不能把本文数值当成所有调用方式的固定答案。
尤其要注意,底层函数的默认参数与上层骨架损失包装函数并不完全相同。本文计算的是直接调用的组件,不是整套训练目标。读取日志时,首先确认记录的是哪个函数的输出,以及是否已经乘上损失权重、合并多轮预测或加入其他项,再讨论不同实验的数字大小。对应版本源码可以帮助核对这些边界。
截断降低的不只是数字,还会改变局部梯度
第二组实验只把第三个预测点沿一个轴移动三十,其他点与所有坐标系保持不变。三个坐标系分别观察三个点,一共九个配对,其中三个配对出现同样大小的偏差。除以长度尺度十并取平均后,未截断结果约为一,符合这个可手算的预期。
把截断距离设为十后,同样的三十位移只按十计入,结果降至约三分之一。结构坐标完全没有改善,下降来自损失定义改变。把不同截断设置下的训练曲线直接画在一起,容易制造“模型明显更准”的错觉,实际上它们使用的评分尺度已经不同。
我们还对第三个点的坐标求了梯度。未截断时,位移方向梯度约为 0.0333333。截断后,该点三个方向的梯度均为零。这次实验固定了坐标系,只让点坐标参与求导,因此结论范围非常清楚,在这个已经超过上限的误差项里,继续增大位移不会继续增加截断后的损失。
这不意味着真实模型一定无法纠正大误差。完整训练中还可能有未截断项、不同权重或其他几何约束,坐标系也可能随模型输出变化。实际排查时应列清每个分量及其权重,观察哪些路径仍然提供梯度,而不是看到一个局部分量饱和,就给整个模型下结论。
掩码会改变评价对象,空集合尤其要单独处理
接下来保持三十的错误位移,但把第三个点设为无效。原来九个有效配对减少为六个,所有错误配对都被排除,FAPE 回到约十万分之一。此时剩余数据确实匹配得很好,但被排除的那个点并没有变准确。
缺失原子或没有有效标签的位置通常需要掩码,这本身是合理处理。问题在于比较两个实验时,如果有效位置集合不同,总分变化可能只是评价对象变化。训练记录除了损失,还应保留有效坐标系数、有效点数以及有效配对数,至少能看出一个异常低分是否伴随大面积标签缺失。
我们还测试了全零点掩码和全零配对掩码,两者都返回零。这个零是空集合经过该实现的数值处理得到的结果,没有任何结构比较在支持它。业务层应先检查有效数量,再决定跳过样本、记录缺失或中止批次,不应把空样本作为优秀预测混入平均成绩。
如果自己在外部重新计算平均值,要格外注意分母。删除部分点后仍除以原来的总点数,会人为压低结果。掩码不只是把某些误差乘成零,还决定了剩下哪些比较应当参与归一化。检查分母通常比观察小数点后更多位更有价值。
局部正确,仍然可能存在整体装配错误
最后一个实验把四个点及其坐标系分成两组,每组两个。我们把第二组整体平移十二,同时移动它的点和局部坐标系。组内形状保持不变,两组之间的相对位置发生改变。这个人工例子只演示几何关系,不代表真实蛋白质结构域或分子复合物。
四个坐标系与四个点一共产生十六个配对,其中组内八个,组间八个。只评估组内配对时,损失仍约为十万分之一。只评估组间配对时,分数约为 1.2。全部配对一起平均,得到约 0.600005,与一半配对没有偏差、一半配对有偏差的构造一致。
加入距离十的截断后,组间分数变成一,全部配对约为 0.500005。这个例子同时说明两件事,选择哪些配对会改变问题本身,截断上限会改变大误差的贡献。一个局部几何指标很好,不足以证明相对位置也正确,应把组内与组间关系分开检查。
对于真实的多链训练,这种检查思路可以用于确认链标识有没有错位,以及组间掩码是否意外全零。但本文没有验证任何实际复合物,也没有证明某一种链间权重最优。能带走的是诊断方法,而不是一个可直接用于所有模型的参数答案。
怎样把这些实跑经验用于自己的项目
如果正在接入新数据,先保存一个极小样本,核对残基顺序、坐标系方向、坐标单位和有效标签。然后依次运行完全一致、整体变换、局部扰动和空掩码四类检查。每一步都有明确预期,失败时可以缩小排查范围,避免在完整训练日志里反复猜测原因。
如果正在比较两个模型,应固定评价集合和参数,并把组内与组间、截断与未截断结果分开记录。总分可以用于概览,但不能替代对应结构区域的检查。对于没有参考结构的预测任务,FAPE 也不能凭空计算出真实误差,更不应与模型自己输出的置信度混为同一种量。
OpenFold 的优势是组件透明、便于插入自己的验证与研究逻辑,代价是使用者需要理解输入约定和实现层次。本次最有用的收获是建立了几个能够被证伪的预期,整体变换应保持结果,局部扰动应产生响应,截断会限制大误差贡献,空掩码必须单独识别。掌握这些检查,比单独记住某个训练损失的数值更能帮助你判断流程是否可信。
当这些组件检查需要纳入团队的批量建模流程时,可以带上软件版本、任务规模和环境清单,向云生信的生物信息学分析服务器服务咨询适合的运行环境与支持范围。


