
把一个蛋白质骨架交给序列设计模型,很快就能得到一批氨基酸序列。真正需要检查的却不只是文件有没有生成,还包括必须保留的位点是否保持原样,设计位置是否对应正确编号,以及评分究竟覆盖哪些残基。一个候选在结果表中排名靠前,并不能自动回答这些问题。
本文安装运行官方 ProteinMPNN 代码和预训练权重,以公开结构 1CRN 的四十六个残基作为输入,实际完成五组序列设计,并保留一次错误编号触发的失败。我们比较无固定位点、固定六个半胱氨酸、改变采样温度、整体平移残基编号和改变批量大小。这里的设计序列用于检查软件行为,未做重新折叠或实验验证,不应直接作为功能优化结果使用。
先分清骨架条件、序列约束与实验目标
ProteinMPNN 根据给定骨架生成或评价序列,属于结构条件下的序列设计工具。输入骨架提供几何条件,固定位置、可设计链和氨基酸限制决定允许探索的空间。研究者还需要另外说明希望保留的功能、界面或化学特征,因为这些目标不会仅凭一个坐标文件就自动变成完整约束。
它适合把已经确定的骨架转成一组可筛选的序列,也适合在明确范围内重设计部分位置。优点是可以直接控制位点,并使用同一个模型对候选进行条件评分。局限在于这种分数反映模型与输入条件的关系,不等于折叠自由能、表达量、结合能力或实验成功率。后续是否能得到稳定且有功能的分子,仍需要独立证据。
本次选择短小的公开结构,是为了让每一步都能人工核对。结构来自 RCSB 的 1CRN 条目,下载文件中的 A 链被解析为四十六个残基。我们没有将它当成模型未见过的测试集,也没有据此估计泛化精度,实验重点是数据、约束和输出之间是否一致。
六个半胱氨酸的位置是三、四、十六、二十六、三十二和四十。本例把这些身份保留下来,方便逐项检查设计规则。保留某个残基的字母,不能证明它在设计产物中形成了正确空间关系,更不能单凭这一项就宣布原有结构或功能已被保留。
固定代码、权重和输入,再执行设计
本次使用 Python 3.10.12、PyTorch 2.5.1+cpu 和 NumPy 1.26.4,在 CPU 上运行官方完整骨架模型 v_48_020。代码固定在下面的提交,使用仓库随附权重,输入文件和权重的完整校验值写入结果附件。模型权重校验值以 c9cb4a67 开头,便于复核是否拿错文件。
python3 -m venv mpnn-env
source mpnn-env/bin/activate
pip install torch==2.5.1+cpu --index-url https://download.pytorch.org/whl/cpu
pip install numpy==1.26.4
git clone https://github.com/dauparas/ProteinMPNN.git
git -C ProteinMPNN checkout 8907e6671bfbfc92303b5f79c4b5e6ce47cdef57
curl -L https://files.rcsb.org/download/1CRN.pdb -o 1CRN.pdb
python 237-proteinmpnn/run.py \
  --repo ./ProteinMPNN --pdb ./1CRN.pdb --out ./mpnn-check
下载驱动与完整实跑结果。驱动会调用官方解析脚本、固定位点辅助脚本及预测程序,不是用自编规则生成序列。它还会读取保存的逐位置概率重新计算评分,检查生成数量、约束位置和编号对照。本次将计算线程限制为两个,没有把这个短蛋白实验作为速度或吞吐量基准。
模型名称和输入类型需要配套。官方还提供其他骨架模型、可溶蛋白训练模型及仅使用部分骨架信息的模型,具体入口见项目说明。不能只替换一个权重文件名,就默认所有输入特征和参数都仍然适用。复现实验至少应同时记录代码提交、权重、坐标文件和实际命令。
另一个容易忽略的细节是随机种子。本次显式设为二百三十七,并在每组运行时保存参数。但固定种子不意味着更换批量大小、软件版本或设备后仍会得到完全相同的序列。种子用于控制特定运行条件下的随机过程,不能替代对环境和输入的记录。
固定的位置,必须是解析后序列中的位置
解析之后,固定文件以结构名称为键,再按链保存位置列表。这里的编号对应解析后链序列中从一开始的位置,不应直接照搬可视化软件显示的作者残基号。尤其是截短构建体、非一开始的编号或含缺失区段的结构,两套编号可能看起来相似,实际却已经错位。
{"crn": {"A": [3, 4, 16, 26, 32, 40]}}
为了检验这一点,我们复制输入文件,把坐标记录中的残基号全部加一百,原子坐标和氨基酸身份保持不变。官方解析得到的链序列与骨架坐标仍然相同。使用正确的序列位置列表,在相同运行参数下,两份输入得到的六条设计序列及评分逐项一致。
随后故意把固定列表也加一百。程序因索引越界退出,报告索引一百零二超出长度四十六的范围。这次错误很容易发现,但真实项目中更危险的是错位后仍落在合法范围内,那样程序可能成功运行,却固定了另一个残基。不能把“不报越界”当成编号正确的证据。
可靠做法是在运行之前建立一张映射,包含链标识、作者残基号、插入码、解析序列位置和氨基酸字母。把要固定的位点逐个映射过去,再检查其参考身份是否符合预期。本文只验证了连续编号整体加一百的情况,缺失残基、插入码及多模型文件需要针对自己的输入另做检查。
禁止生成半胱氨酸,为什么输出仍然可以含有它
本次所有设计都使用 --omit_AAs CX,让可重新设计的位置不采样半胱氨酸和未知字符。这个设置只是为了使约束作用更容易观察,不是对实际设计项目的普遍建议。没有固定位点时,六条生成序列都不含半胱氨酸。
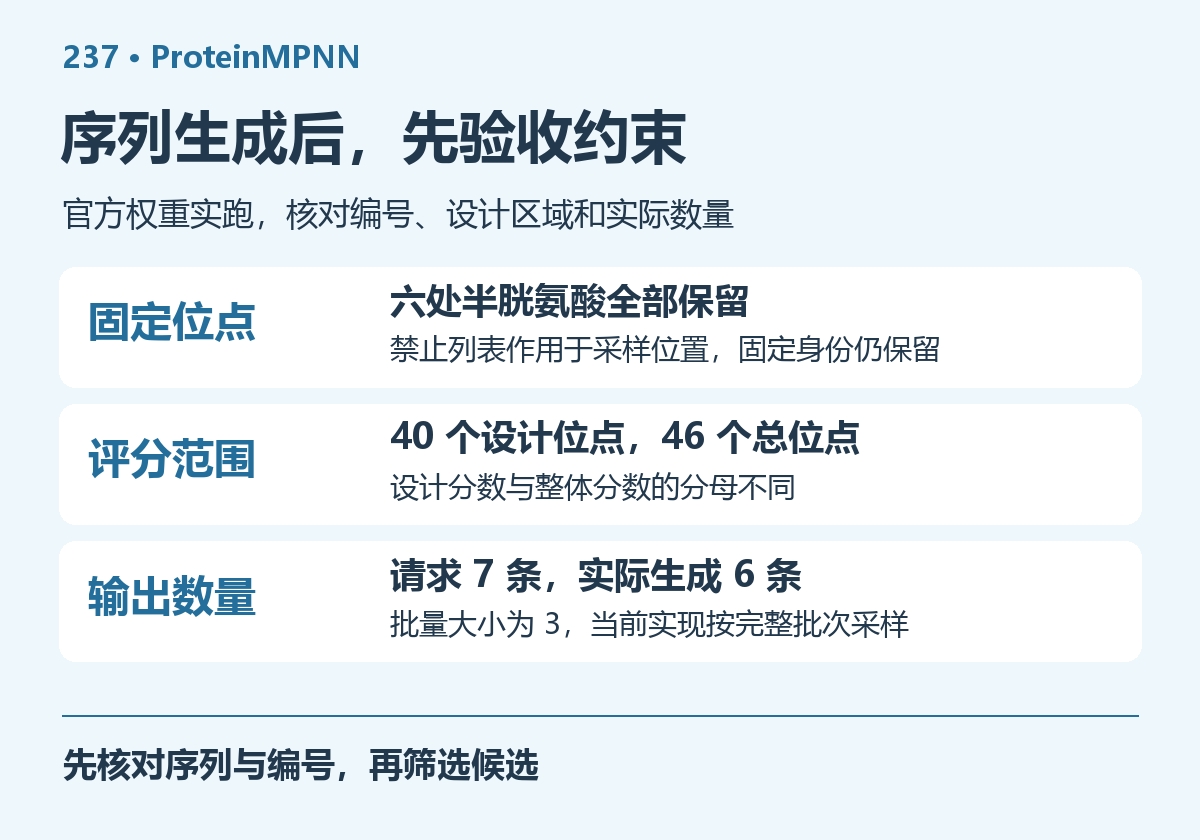
固定六个位点后,所有生成序列都保留了这六个半胱氨酸,其他位置没有新增半胱氨酸。两种设置没有冲突,因为固定位置直接保留输入身份,而禁止列表作用于允许采样的位置。看到输出中仍然存在被禁止的字母,首先应该核对它是否属于固定部分。
本次第一条固定设计序列如下,读者可以直接核对六个位置。但这条序列并未证明会形成目标折叠,也没有经过任何功能筛选,不能仅凭保存了几个残基就用于替代后续验证。
TVCCPSKEAKEKYLECLKSGTPKEECAKKTGCIIIPGTTCPPEYPY
在真实项目中,建议将约束检查写成独立验收步骤。对每个候选核对长度、链划分、固定身份、禁止字符和允许变化的位置,不依赖结果标题里的参数文字。标题能说明程序收到过哪些选项,序列本身才能说明最后交付的候选是否满足要求。
还要区分固定残基与固定整条链。多链体系中,某些链可以作为结构和序列背景参与设计,而另一条链才是改造对象。如果后处理时把这些链全部拼成一个字符串再统计突变,很容易把背景链的保留误计为设计质量提高。比较候选时应使用明确的设计区域。
score 和 global_score 为什么不同
官方输出同时给出设计区域评分和整体评分。前者对可重新设计且有效的位置计算平均负对数概率,后者覆盖有效的整体位置。我们用保存的逐位置对数概率重新计算两项结果,与程序输出的最大差异小于百万分之一,确认了本例中的实际分母。
没有固定位点时,四十六个位置都参与设计,两种分数相同。固定六个位点后,设计分数使用四十个位置,整体分数仍使用四十六个位置。第一条固定候选的两项分数分别约为 0.9730 和 0.8559。这种差别不表示整体结构一定更稳定,而是评价集合和各位置的概率贡献不同。
| 本次设置 | 可设计位置 | 第一条评分 |
|---|---|---|
| 无固定,温度 0.1 | 46 | 两项均为 1.1668 |
| 固定六处,温度 0.1 | 40 | 设计 0.9730,整体 0.8559 |
| 固定六处,温度 0.3 | 40 | 设计 1.0588,整体 0.9305 |
这些分数通常越低表示模型在对应条件下越偏好该序列,但比较之前要确认骨架、模型、设计区域和评分方式可比。不能把不同固定比例的结果混在一起,直接按某一列选最低值,更不能将小于一的数理解为某个成功概率。评分的定义比数字是否好看更重要。
序列恢复率同样有分母问题。第一条固定候选的输出恢复率为百分之四十五,对应可设计的四十个位置中十八个与参考相同。如果把六个固定位置也算进去,则是四十六个位置中的二十四个相同,约百分之五十二点一七。后者包含人为保证不变的部分,用它评价模型恢复能力会混入约束带来的贡献。
对于功能设计,恢复率高也未必是目标。研究者可能希望保留少数关键位点,同时探索其余区域。此时应把固定位置合规、设计区变化程度和模型评分分别报告,而不是用一个恢复率承担所有判断。它描述相似程度,并不直接描述功能、可溶性或创新性。
改变温度,要同时看多样性与候选质量
我们在相同固定条件下分别用温度 0.1 和 0.3 生成六条序列。两组都得到六条互不重复的候选。如果只统计去重数量,会得出两组多样性一样的印象,但逐位置比较显示差异明显。
对每组十五对序列,仅在四十个可设计位置计算两两不同的比例,再取平均。温度 0.1 的平均差异约为百分之十一点八三,温度 0.3 为百分之三十六。这个统计比“有几条独特序列”更能说明候选彼此相隔多远,而且没有让固定位置稀释变化程度。
本例中较高温度组的设计分数也整体更高,说明探索到了模型相对不那么偏好的序列。不过,每组只有六条候选,不能据此宣布某个温度在所有蛋白上最优。温度选择应结合允许的探索范围,以及后续能够验证多少候选,而不是追求多样性越高越好。
如果准备比较温度,建议保持输入骨架、固定规则和评价方法一致,并保存完整序列。除了平均差异,还可以检查变化集中在哪些区段、是否引入不希望出现的模式,以及候选之间是否只是少数位置反复替换。多样性是候选集合的一个属性,不能替代每条候选的可接受性检查。
请求七条却只得到六条,应检查批量整除
最后一组设置请求七条序列,批量大小为三,实际生成六条。检查固定提交的主程序可以看到,它先用整数除法确定批次数,再按完整批次采样,本次没有为余下的一条追加部分批次。
这不是运行被中断,也不是某条序列在后处理时被过滤掉。退出状态正常,输出文件也存在,因此只检查命令是否成功无法发现数量差异。统计时还要排除 FASTA 最前面的参考序列记录,不能把文件记录总数直接当成新设计数量。
如果需要指定数量,可以先选择能够整除的批量设置,或使用批量大小一,再在运行结束后核对实际设计条目。多个温度组合还涉及每个温度分别采样的数量,应按照所用版本的实现核对总数。对于后续合成或筛选安排,真实候选数量和去重后的数量都应在交付表中单独列出。
此次实跑最有用的经验,是把一次生成过程拆成可以核验的环节。先确认解析对象,再确认约束映射,随后检查生成数量和序列合规,最后解释评分并安排独立验证。ProteinMPNN 能有效地提供结构条件下的候选,但只有把这些环节连接起来,结果表才真正具备继续分析的基础。
当候选设计扩展到多个骨架与参数组合时,可以把模型版本、骨架规模和批次计划交给云生信的生物信息学分析服务器服务,先确认运行环境与资源需求。


