
分子对接结束以后,最容易被直接抄进结论的数字是最低分。有时换一个随机种子,分数又低了一点,于是被解释成结合更强。有时把聚类阈值调小,结果从一个簇变成七个簇,又被解释成发现了更多结合模式。这两种判断,都跳过了一个关键问题,究竟是搜索结果变了,还是分析这些结果的规则变了。
本文实际安装并编译 AutoDock-GPU v1.6,用官方小样例完成三组对接,再对同一批结果进行两次重新聚类。运行后端是 CPU OpenCL,不是 GPU 性能测试。我们重点观察搜索预算、随机种子和聚类阈值如何影响读表,并保留命令、原始输出与核验脚本,让每个数值都能追溯到对应操作。
名字中有 GPU,也要确认实际使用的设备
AutoDock-GPU 提供 CUDA 与 OpenCL 路径,OpenCL 路径也支持 CPU。本文机器使用 Ubuntu 22.04.5,处理器为 AMD Ryzen 5 3600,通过 PoCL 7.2 提供 CPU OpenCL 设备,运行日志中的设备名称也明确指向该处理器。不能因为执行的是这个项目,就把所有结果称为显卡加速实测。官方 v1.6 说明与参数表
软件的优势是能够并行开展对接搜索,并提供批量处理及搜索控制。实际限制则包括设备运行环境、输入准备和结果解释。并行执行可以帮助完成更多搜索,却不能自动纠正配体质子化、受体状态或网格范围等问题。错误输入被更快处理,仍然会产生需要重新分析的结果。
本次编译目标是 CPU,生成的文件为 autodock_cpu_64wi。文件名中的六十四来自工作组大小设置,不表示使用了六十四个物理核心。我们还设置了 PoCL 工作线程上限,避免把这次教学任务误写成充分利用整台机器的性能测试。具体运行时间虽然保留在记录里,但没有据此比较不同硬件的速度。
安装时先分清三层 OpenCL 依赖
编译所需的头文件、用于加载实现的运行库,以及真正提供计算设备的 OpenCL 实现,是不同部分。系统能找到一个 OpenCL 库文件,不保证能够枚举出可用设备。排查时可以先运行 clinfo,确认实际平台和设备,再编译并检查软件帮助输出,最后用小样例验证真正的计算路径。
本次在独立环境中安装 Python 3.10、PoCL、OpenCL 加载库、头文件、clinfo 和 make,保留完整包版本清单。源代码固定为官方 v1.6 发布标签,未修改上游代码。需要复现时,应使用相同发布版本,并对照安装记录检查依赖,而不是把将来下载到的任意主分支当成相同实验。
第一次编译失败的原因很具体,我们只设置了 GPU 头文件和库的路径,但此版本 CPU 编译分支读取的是 CPU 对应变量。补齐这两项以后编译成功。下面给出成功设置的整理版,其中环境目录需要替换为读者实际安装位置,并在源码目录执行。系统仍需具备适用的 C++ 编译器。官方安装说明
export ADGPU_ENV=/absolute/path/to/opencl-env
export PATH="$ADGPU_ENV/bin:$PATH"
export CPU_INCLUDE_PATH="$ADGPU_ENV/include"
export CPU_LIBRARY_PATH="$ADGPU_ENV/lib"
export LD_LIBRARY_PATH="$ADGPU_ENV/lib"
export OCL_ICD_VENDORS="$ADGPU_ENV/etc/OpenCL/vendors"
export POCL_MAX_PTHREAD_COUNT=4
clinfo
make -j2 DEVICE=CPU NUMWI=64
./bin/autodock_cpu_64wi --help
这个经验的价值是定位错误发生在哪一层。头文件缺失属于编译阶段,设备枚举为空属于运行环境,输入地图找不到又属于数据路径。把三类错误都归结为“显卡没装好”,只会增加无关的尝试。这里的配置针对本文已经验证的 CPU 环境,不能直接当成所有 CUDA 或 OpenCL 设备的安装方案。
官方样例的网格也属于实验输入
我们使用发布源码中的 input/1stp/derived 数据,配体文件包含十八个原子和五个可旋转键,直接复用随样例提供的预计算地图。本次没有重新准备配体或生成地图,因此不能把结果描述成从原始结构开始完成了全套对接流程。输入文件摘要随结果保存,便于确认比较时没有换入另一套地图。
地图描述文件记录间距零点三七五埃,三个方向的网格点数为二十五、二十三、三十三。相应的间隔数是二十四、二十二、三十二。点数与间隔数相差一,是边界端点计数带来的区别。检查范围时要先确认某个字段表示什么,不能把两个约定混用后直接计算盒子大小。
对自己的数据,应同时核查网格中心、空间范围、需要的原子类型地图和配体准备方式。配体文件能被读入,并不证明预计算地图覆盖了所有相关位置和类型。尤其在修改受体或结合区域以后,不能因为文件名没变就继续复用旧地图,应确认它们是否仍然代表当前输入条件。
三组搜索只改变预算或随机种子
每组设置八次 LGA 搜索,最大代数保持四万两千,输出聚类阈值保持二埃。第一组评分评估预算设为五万,第二组增至二十五万,两组使用同一个种子。第三组沿用较高预算,更换种子。为观察这组人为指定的预算条件,我们关闭了自动预算启发式和自动停止,其他未列出的搜索参数保留该版本默认值。
这样设置是为了教学比较,并不表示实际筛选都应该关闭自动控制。默认自动策略有自己的用途,改变它们就改变了运行条件。复现实验时应记录显式参数和软件版本,并关注日志中实际采用的搜索方法,而不是只保存一个输出前缀。
下面是低预算组的命令结构。输入路径应指向官方样例复制后的目录,输出放到单独的新目录。第二组把评估预算改为二十五万,第三组再把种子改为二零二六一一一九。配套脚本为每组创建独立目录,防止后运行的文件覆盖前一组。
autodock_cpu_64wi \
  --ffile input/1stp_protein.maps.fld \
  --lfile input/1stp_ligand.pdbqt \
  --nrun 8 --nev 50000 --ngen 42000 \
  --heuristics 0 --autostop 0 \
  --seed 20261118 --rmstol 2 --gbest 1 \
  --resnam dock
预算字段也不能简单等同于恰好完成的评估次数。高预算第一组设置为二十五万,日志的实际评估字段记录为二十五万零九百九十三。实际停止和批量推进机制会影响记录数值,阅读时应把设置值与完成值分开保存。本文称五万与二十五万为预算条件,不宣称每次实际计数严格等于它们。
分数改善是本次样例的观察,不是普遍保证
实际结果如下,最低分单位沿用软件报告的千卡每摩尔。参考偏差取该组最低分构象对应的 RMSD,而不是另找最接近参考的构象填到同一行。最后一列统计八次搜索结果中参考偏差不超过二埃的数量,这里的二埃只作为明确的统计条件。
| 条件 | 最低分及其参考偏差 | 参考偏差不超过 2 Å |
|---|---|---|
| 五万预算,种子一 | -7.01,0.81 Å | 7/8 |
| 二十五万预算,种子一 | -7.62,0.69 Å | 8/8 |
| 二十五万预算,种子二 | -7.76,0.62 Å | 8/8 |
这个小样例中,提高预算以后找到了更低分的构象,最低分构象也更接近所用参考。换种子又产生了一点差异。但三组实验不能估计所有靶点的平均改善,更不能证明预算提高五倍就一定获得固定幅度的进步。复杂配体、不同口袋和不同输入准备方式,都会改变搜索难度与结果分布。
还应避免把最低分的微小差距直接解释为真实结合强弱。对接评分属于指定模型下的近似评价,不能仅凭负七点七六比负七点六二更低,就判断实验亲和力确实更好。这里比较的是同一配体、同一地图条件下的搜索结果,不是比较两个候选药物的实验表现。
参考 RMSD 首先取决于参考是什么
本次没有额外指定参考文件,按照该版本设置,以输入配体坐标作为 RMSD 参考。样例的这一参考用于检查对接构象与所提供位置的接近程度。报告中应把参考文件及其来源讲清楚,而不只是写一个看起来很小的偏差数字。
如果读者换成一个任意摆放的待筛配体,默认参考依然可能是那份输入坐标,此时接近参考并不自动等于接近实验结合构象。参考是不是经过验证的结合位置、原子对应如何处理、是否启用对称性处理,都会影响偏差的解释。没有适当参考时,就不能沿用重对接验证的语言。
八次中有八次低于某个阈值,也不等于获得百分之百的实验成功率。分母是当前条件下的搜索结果数量,不是独立靶点、候选化合物或生物实验。这个比例可以帮助描述搜索集中程度,但不能替代独立样本上的方法评估。
一簇变七簇,构象却一条都没有增加
接下来取高预算、种子一的同一份 XML,分别使用二埃和零点五埃阈值重新生成聚类报告。我们使用软件的 XML 转 DLG 功能,没有重新搜索。脚本核对了输入 XML 摘要未变,两份 DLG 的全部 DOCKED 记录逐行一致,每次运行对应的能量与参考 RMSD 也相同。
| 重聚类条件 | 簇数量与成员数 | 最低分与参考偏差 |
|---|---|---|
| 阈值 2 Å | 1 簇,含 8 个成员 | -7.62,0.69 Å |
| 阈值 0.5 Å | 7 簇,成员为 2 和六个 1 | -7.62,0.69 Å |
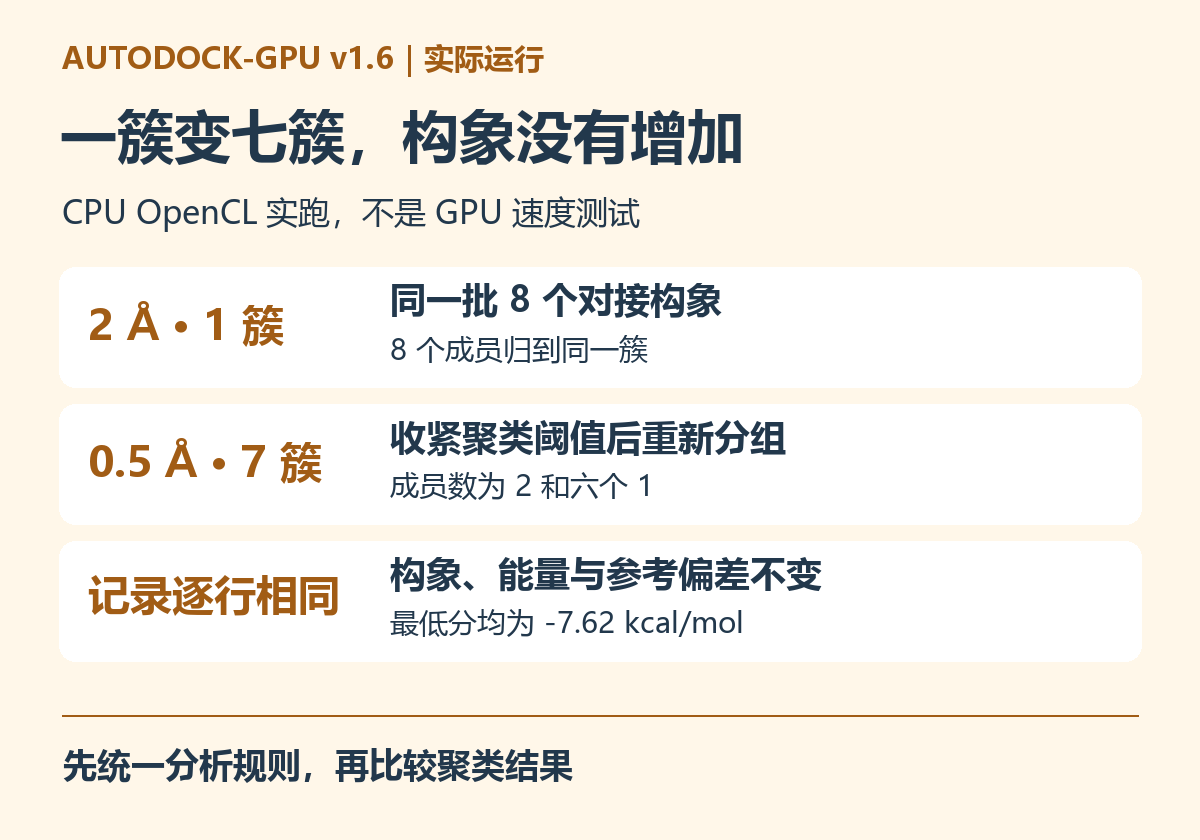
变化来自分组规则变严格,而不是找到了额外的构象。因而“簇更多”本身不能作为搜索更充分的证据,也不能直接说明存在七种经过验证的结合模式。如果比较两批结果的聚类数量,必须先确认阈值、距离定义和处理设置一致,否则差异可能主要由分析规则造成。
autodock_cpu_64wi --xml2dlg high_seed1/dock.xml \
  --rmstol 0.5 --resnam cluster05
autodock_cpu_64wi --xml2dlg high_seed1/dock.xml \
  --rmstol 2 --resnam cluster20
这一步还遇到一个实际读取问题。最初脚本误以为转换过程会再生成 XML,但本次版本和调用路径输出的是 DLG。软件转换已成功,失败的是我们的后续文件读取。改为解析实际生成的聚类直方图和排序表后完成核验。排查时应该区分计算失败和结果整理失败,先保留成功输出,再修正读取逻辑。
簇大小描述搜索结果,不能当成占据概率
二埃条件下八个成员进入同一簇,可以说明它们在当前分组规则下比较集中。但对接搜索的结果不是按平衡统计力学权重抽取的轨迹帧,成员数占比不能直接作为结合模式的热力学占据概率。也不能因为某簇有七个成员,另一簇只有一个,就宣布前者概率是后者七倍。
挑选结果时可以联合查看分数、聚类分布、关键相互作用和明显空间冲突,但每个指标都需要对应自己的问题。分数反映所用评分模型,聚类反映指定距离规则下的相似性,接触检查帮助审阅局部几何。将它们一起报告,比只贴一个最低分更有助于判断后续需要验证什么。
本文实际复用了预计算地图,未测试柔性受体、共价对接或大规模化合物库,也没有进行实验亲和力验证。CPU 后端的小样例足以检查命令、输出和解释逻辑,但不能用来推算 GPU 吞吐量。首次运行还可能包含内核编译等开销,跨硬件计时需要独立设计相同输入和清楚的计时范围。
这次实跑最实用的经验,是把输入准备、搜索条件和输出分析分开记录。先确认实际设备与输入,再区分预算、种子和阈值分别改变了什么,最后才比较结果。完整记录不是为了保存更多文件,而是为了在某个数字变化时,能够找到它变化的原因。官方常见问题说明
下载实跑驱动与结果记录(ZIP)。包内包含运行说明、已执行脚本和结果 JSON,需自行取得官方源码及其样例并配置 OpenCL 环境。脚本保留每组原始输出,复现时应比较分析字段并考虑环境差异。
当小样例与结果检查流程已经跑通,需要扩展到多受体或大批配体任务时,可了解云生信生物信息分析服务器,按实际运行后端、输入规模和任务安排沟通计算环境。


