
一份对接结果同时给出经验评分、CNNscore 和 CNNaffinity,究竟按哪列排序?如果三个指标没有选中同一个姿势,是否说明计算出了问题?理解这些数字的第一步,是确认每一列在评价什么,而不是把它们都当成结合强弱的不同写法。
本文安装 GNINA v1.3.3,用官方测试数据实际完成一次小规模对接,再对输出的六个姿势做固定坐标重评分。运行明确使用 CPU,未进行 GPU 性能比较。三种指标得到不同排序,恰好提供了一个具体例子,帮助区分搜索、姿势评价、亲和力预测和结果整理。
三列数值回答三个不同问题
本文显式选择 Vina 经验评分,其数值越低通常代表该评分规则下越有利的候选。CNNscore 则是学习模型给出的姿势质量评分,较高数值表示更倾向于被判为接近正确姿势。CNNaffinity 是另一项输出,用于预测亲和力相关的对数尺度数值,较高通常对应较强的预测结合。项目作者对评分含义的解释
因此,经验评分通常从低到高排序,后两项通常从高到低排序。把三列都按升序处理,会把神经网络分数的方向弄反。也不能把 CNNaffinity 的正数与经验评分的负数直接相加,然后把更负的结果称作“综合更好”,因为它们的定义和尺度不同。
CNNaffinity 的 pK 尺度可以用负对数帮助理解。例如数值七对应十的负七次方摩尔量级,也就是一百纳摩尔。但当这个数值来自模型时,换算仍然只是对预测量的表达转换,不会因此变成实验测量。它也不能替代具体实验条件、测量类型和误差说明。
CNNscore 的高值同样不能直接解释为某个真实项目中相同百分比的成功率。模型训练目标与新任务之间可能存在分布差异,实际校准需要另外检验。一个输出为零点九的姿势,不意味着已经通过实验确认它有百分之九十的正确概率。
先说明模型在流程的哪一步参与
GNINA 提供多种 CNN 使用方式。本文采用 rescore,在经验评分驱动的搜索之后对候选姿势进行神经网络评价与排序。其他方式可以让 CNN 更深入参与优化或搜索,计算成本与流程含义也会改变。因此,“用了神经网络”并不是足够完整的方法描述。GNINA v1.3.3 参数与模式说明
只在搜索末尾重排,主要改变的是候选集合中的优先顺序。它不能保证找回从未被搜索到的结合方式。若候选集合本身缺少合理姿势,给这些候选换一种评分也无法证明已经解决采样不足。评价重评分效果时,应把候选生成和候选排序两个问题分开。
该版本默认使用多个模型组成的集成,而不是一张固定神经网络。复现时需要同时记录软件版本、模型选择和使用模式。仅保留“GNINA 默认参数”这句话,过一段时间重新安装后未必还能对应同样的模型组合。GNINA 1.3 原始研究
安装文件能下载,还不等于程序能启动
我们下载官方发布的 v1.3.3 预编译文件,并按发布页给出的摘要核对完整文件。首次远端下载连接超时,之后改为本机下载并校验,再传入计算环境。完整性检查很有用,可以区分传输不完整与后续运行依赖问题,避免对着一个残缺文件排查软件参数。
这次文件名带有 static,但直接启动仍提示缺少 cuDNN 和 CUDA 相关动态库。随后通过独立环境补齐 CUDA 12.8 运行库、cuDNN 9.7 及对应数学库,才成功读取版本和帮助信息。不能仅凭文件名判断所有依赖都已经打包,也不能因为计划使用 CPU 就假定二进制不需要加载这些库。
实际运行环境为 Ubuntu 22.04.5、AMD Ryzen 5 3600,Python 驱动版本为 3.10.22。每次调用显式设置 --no_gpu 和两条 CPU 工作线程,并限制相关线程环境变量。运行库存在与使用 GPU 是两件事,本文所有结果都来自 CPU 路径,安装过程也没有配置新的显卡驱动。
下面是本次依赖安装命令的路径整理版,需要先有 micromamba,并具备足够磁盘空间。版本与完整依赖清单保存在复现说明中。命令中的环境目录仅用于展示,不是读者可以原样使用的机器路径。
micromamba create -y -p /absolute/path/to/gnina-env \
  --override-channels --strict-channel-priority -c conda-forge \
  python=3.10 cuda-version=12.8 cuda-cudart \
  libcublas libcufft libcusparse libcusolver cudnn=9.7

export GNINA_ENV=/absolute/path/to/gnina-env
export LD_LIBRARY_PATH="$GNINA_ENV/lib:$GNINA_ENV/targets/x86_64-linux/lib"
./gnina --version
这套设置解决的是本文机器上的依赖问题,不是所有平台的通用安装保证。遇到启动报错时,先查看缺少哪个库、是否能加载所选环境,再测试帮助输出。帮助能打开以后,还要执行实际计算,才能确认所需模型与计算路径确实可用。
官方小样例与完整项目之间的边界
输入来自官方 v1.3.3 对应提交的测试目录,使用 184L 受体文件和配体 SDF。配体记录名为异丁基苯,输入包含十个重原子。我们直接复用这些已准备文件,没有重新确定受体质子化、补建结构或枚举配体状态,所以不能把这次实验描述成从原始结构开始完成了全部准备流程。
搜索区域通过输入配体确定,适合检查已知局部区域中的命令与输出。这不等同于在整条蛋白表面寻找未知结合位点。若读者把它改成盲对接,需要重新定义搜索空间与验证目标,不能把本文的小区域设置不加检查地搬过去。
本次设置搜索强度为二,最多输出六个姿势,随机种子固定为 20261118。较小设置是为了完成可审阅的教学例子,并不作为真实筛选任务已经充分采样的证明。最多输出六个也不意味着所有输入都必然返回六个,应以实际记录为准。
./gnina -r 184l_rec.pdb -l 184l_lig.sdf \
  --autobox_ligand 184l_lig.sdf \
  --scoring vina --cnn_scoring rescore \
  --exhaustiveness 2 --num_modes 6 --seed 20261118 \
  --no_gpu --cpu 2 -o dock.sdf
六个姿势,三种排序
这次实际得到六个姿势,下面先列出前三条的部分分数。姿势编号按照第一次对接输出中的顺序确定,后续无论按哪一列重新排序,都保留这个标识。表中数值经过四舍五入,完整精度在结果 JSON 和原始 SDF 中。
| 姿势 | Vina 经验评分 | CNNscore 与 CNNaffinity |
|---|---|---|
| 1 | -6.95705 | 0.92531,4.89567 |
| 2 | -6.73061 | 0.91161,4.93357 |
| 3 | -6.83793 | 0.91033,4.70158 |
按经验评分排序,前三名是姿势一、三、二。按 CNNscore 排序,则是一、二、三。按 CNNaffinity 排序,第一名变成姿势二。两种评价对第二、第三名甚至第一名作出不同选择,不需要预先判定为程序错误,因为它们本来就在衡量不同目标。
完整排序也提供更多信息。CNNaffinity 把姿势五放在第三位,而 CNNscore 把它排第五。一个姿势的预测亲和力数值相对较高,并不保证它同时获得最好的姿势质量评价。筛选时应保留这种分歧,而不是只展示最有利的一列,把其他列从报告中删掉。
还要记住,这六条记录属于同一个配体,并不是六种化合物。不同姿势的预测值反映模型如何评价不同输入构象,不能被当作六次独立亲和力实验。若用于比较不同化合物,还需要明确每个化合物如何选择代表姿势,并保留没有产生有效结果的输入,避免只在成功输出中统计筛选表现。
| 排序依据 | 方向 | 本次完整顺序 |
|---|---|---|
| 经验评分 | 从低到高 | 1、3、2、4、5、6 |
| CNNscore | 从高到低 | 1、2、3、4、5、6 |
| CNNaffinity | 从高到低 | 2、1、5、3、4、6 |
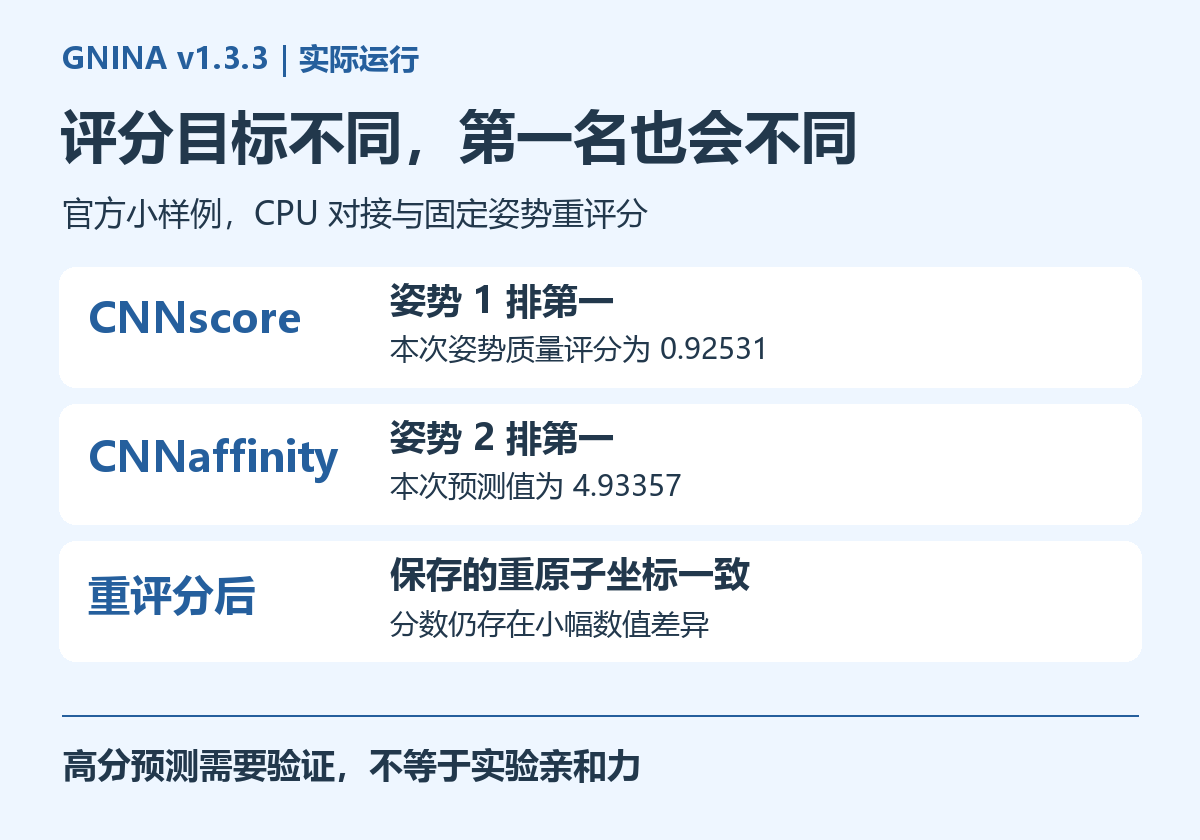
本文没有用实验结构偏差验证哪一项排序更准确,也没有进行外部靶点评测。因此能够得出的结论是,这次输出中的评分排序确实不同,需要按任务目标解释。不能进一步宣称 CNNscore 或 CNNaffinity 在所有项目里一定优于另一项。
固定姿势重评分,不会自动修复构象
接下来把原始对接输出作为输入,使用 score_only 对这六个姿势重新评价。脚本逐条解析前后 SDF 中的重原子元素和坐标,确认保存的重原子坐标列表完全一致。这验证了本次固定姿势处理没有把这些重原子换到另一个位置。
./gnina -r 184l_rec.pdb -l dock.sdf \
  --score_only --scoring vina --cnn_scoring rescore \
  --no_gpu --cpu 2 -o rescored.sdf
如果希望优化构象,需要采用相应优化方式并核对前后结构变化。不能把“重新评分”写成“重新对接”,也不能只因为新文件有一个更好的数值,就推断分子已经移动到了更合理的位置。每种命令到底改变输入中的什么,应根据实际操作和输出确认。
一个值得保留的细节是,重原子坐标列表一致,并不意味着前后分数逐位相同。本次经验评分的最大绝对差约为零点零零四四三,神经网络分数也有很小变化。写出精度和重新读入后的处理都可能影响比较,但本次没有把各项影响逐一分解,不能指定其中某一项为唯一原因。
因此,核验应分别报告坐标一致性和数值差异,而不是先假定所有字段必须完全一致。若真实任务出现大幅差异,应继续检查模型选择、评分设置、输入准备、原子类型及坐标来源。若只是微小变化,也不应立刻把它解释为生物学意义上的改善。
解析 SDF 时不要丢掉姿势身份
一个 SDF 文件可以包含多条结构记录,每条记录又有自己的属性。读取时应按记录边界分开,保留姿势标识,再提取相应分数。不能把整份文件里第一次出现的 CNNscore 当作所有姿势的值,也不能因为分子名称相同就把多个姿势覆盖成一行。
本文驱动使用标准库读取这个已确认格式的小样例,检查结构记录和分数属性,并输出三种排序。它只针对当前 V2000 数据布局,不是处理任意 SDF 的通用化学解析器。实际项目如果包含其他格式、不同原子顺序或复杂属性,应使用适用的解析工具并增加相应检查。
数值列也应检查是否缺失、是否能够转换成有限数值,以及是否确实来自本次启用的评分模式。没有计算某一项时,不应为了方便排序就填成零。零可能被当作有效低分继续参与排名,随后产生一个看似精确但来源错误的候选列表。缺失原因应单独保留,和真正计算出的数值区别处理。
导出排序表以后,最好保留原始记录号和文件摘要。读者点开某个高分候选时,应能找到它对应的具体构象,而不是仅凭相同化合物名称打开另一条姿势。后续添加几何或接触评价时,也通过同一姿势键连接,避免把不同构象的优点拼成不存在的综合结果。
把速度、评分和验证分别安排
本次对接与重评分都在短时间内完成,但输入很小,搜索区域已知,参数也用于教学。时间记录包含这个环境下的程序初始化和计算,不能据此推算大库吞吐量,更不能外推 GPU 加速倍数。真正比较硬件时,需要一致的数据、线程、模型、缓存条件和计时范围。
GNINA 的价值在于可以把学习模型与对接流程结合,用不同信息帮助审阅候选。它的限制则包括训练数据覆盖、输入构象质量以及评分目标与真实实验之间的差距。一个高分结果仍需结合结构合理性与适当验证,多个模型分数相近也不等于已经排除了共同偏差。
读者可以先用小样例检查安装、实际运行后端和字段解析,再扩展到自己的输入。报告时写清模型版本、搜索范围、评分模式、排序依据和验证范围。只有这些条件明确,分数变化才有可解释的上下文,候选选择也才方便复核。
下载实跑脚本与结果记录(ZIP)。选择包内 GNINA 目录,按说明获取官方程序与输入并配置依赖,使用新的工作目录运行。包内另有两项人工审阅练习,执行性质分别标明,不混作软件实跑。
当小样例和结果整理流程已经验证,需要扩展到多批配体或多种受体条件时,可了解云生信生物信息分析服务器,结合实际运行后端、模型和输入规模沟通环境需求。


