
面对一张对接排名表,最容易跳过的是最前面那一步。同一个配体、同一个受体、同一个口袋,再算一次,能否找到相近的姿势?我们用 AutoDock Vina 的官方教学体系做了四次刚性受体对接。一次低强度搜索给出的第一名与另一次相距十二埃以上,而在较高搜索强度下,两次第一名的距离不到一埃。这些数值都是一次小规模复现的结果。下面用它们说明怎样从输入、搜索和输出三头核账,再决定虚拟筛选排序值不值得往下追。
先固定受体、配体和口袋,再比较搜索参数
本例选用教程中以晶体结构 1IEP 为基础准备的 c-Abl 激酶受体和配体伊马替尼。直接取得作者准备好的两个 PDBQT 文件与对接盒配置,固定版本并记录文件校验值。这样四次运行公用同一套坐标、原子类型、电荷和可旋转键定义,差异更容易追到搜索本身。若换成自己的研究对象,应先检查配体的价态和质子化形式、受体的链与辅因子取舍,以及已知配体所在口袋是否被正确保留。一份能被程序读取的文件,并不保证它描述的是实验条件下想研究的化学物种。官方 1IEP 对接教程
盒子中心为三维坐标 15.190、53.903、16.917,三条边长都是二十埃。对接盒前三个数是中心,后三个数是沿三轴的完整跨度,容易与某些网格工具使用的格点数或半径混淆。检查时将盒子和共晶配体叠在同一个受体坐标系里,既看配体有没有落在盒内,也看跨出口的柔性部分是否有空间转动。若受体与盒配置曾分别居中或旋转,中心数值仍然合乎语法,却可能已经把搜索送到蛋白另一侧。为了让同事能重现这个步骤,保存实际使用的盒文件比在笔记里写“围绕活性中心设置”更明确。本次使用的作者示例文件
实跑经验|把两个种子和两个搜索强度交叉起来
在 Ubuntu 安装 AutoDock Vina 1.2.5,使用默认 Vina 打分,不启用受体柔性。设一个执行线程,请求最多九种模式。先将搜索强度设为一,分别运行随机种子三十七和九十三。再把强度改为八,保持其他输入并重复两个种子。下面的首位分数取自各次写出的构象文件,单位为每摩尔千卡。构象数是各输出文件实际记录的模型数,分数只能在此处固定的准备方式与打分函数下解读。
| 搜索强度 | 随机种子 | 首位分数 | 文件中实际构象数 |
|---|---|---|---|
| 1 | 37 | −7.641 | 1 |
| 1 | 93 | −13.282 | 1 |
| 8 | 37 | −13.242 | 3 |
| 8 | 93 | −13.220 | 3 |
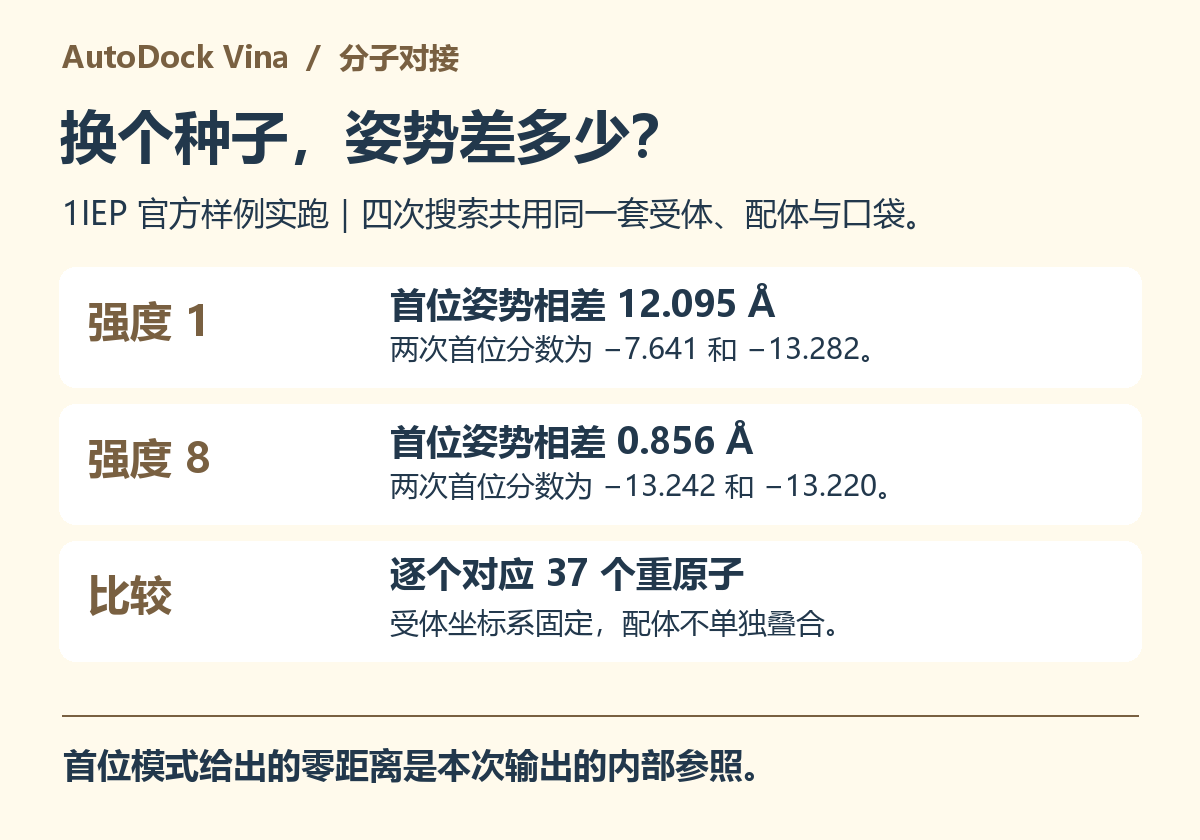
低强度下,仅交换随机种子,两个首位分数就相差 5.641。强度提高到八后,两个首位分数相差约 0.022。不过四次里数值最负的一次仍出现在低强度搜索。增加搜索强度给了程序更多机会找到能量较低的区域,并不保证每个随机种子的首位分数都比之前更低。实际筛选若只看到某一个种子排出的第一名,可以先做这样的重复,再决定是否把一个配体排在另一个前面。尤其是两个候选只差零点几分时,还要衡量同一分子重复搜索本身会浮动多少。
vina --receptor 1iep_receptor.pdbqt --ligand 1iep_ligand.pdbqt \
  --config 1iep_receptor.box.txt --cpu 1 --seed 37 \
  --exhaustiveness 8 --num_modes 9 --out e8_s37.pdbqt
# 两个文件量的是不同的东西,分别查看
grep '^MODEL' e8_s37.pdbqt
grep '^REMARK VINA RESULT' e8_s37.pdbqt
还碰到一个容易被批处理脚本掩盖的细节。强度八、种子三十七时,终端打印九行候选,输出文件里却只保存三份模型。第一名为负十三点二四二,第四名在日志中约为负九点八七一,两者相差已经超过默认写出能量窗口的三。因而应清点输出文件里的模型段,再按实际存在的构象提取坐标。如果表格预先创建九行,又把没写出的构象补零,那些零经后续聚合便可能被误当成真实结果。作者对输出模式数和能量窗口的说明
如果已经跑完整块化合物板,可以抽一个高分候选和一个边缘候选,把相同配体的不同构象成组记录,先检验组内分数和关键接触是否稳定,再做组间排序。一个长而灵活的配体可能有多种尾部朝向,若核心基团和同一残基持续接触,单报全分子偏差会把尾部变化与核心定位混在一起。可另存核心原子集合,再同时比较全配体和核心的坐标偏差,并在图注写明原子选择。这样交给实验同事时,究竟要验证哪一处相互作用就清楚得多。
分数相近时,还要比较两次的首位姿势
Vina 输出中首位模式后面的两列距离都可以是零,因为它和本次运行自己的第一名作比较。把四次结果横向排列,看到四行零,并不能推出四种姿势相同。我们取每次第一种模型,在固定受体坐标系内核对三十七个配体重原子的序号和名字,再从对应坐标计算均方根偏差,全程没有对配体做独立叠合。低强度两次第一名相距 12.095 埃,较高强度两次相距 0.856 埃。这项计算使用固定原子对应关系,没有对化学上对称等价的原子置换取最小值。若换一套会重排配体原子的准备流程,只按文件行号求距离会得到没有根据的数字。
接下来才有必要问姿势是否有实验支持。回看受体上的关键残基、配体埋藏方向、是否存在明显碰撞,若手中有可靠的共晶结构,可以在统一的受体坐标系与正确的原子映射下另算相对实验姿势的偏差。本次求的是不同搜索运行之间的距离,没有把上述数字当成相对晶体结构的准确率。两次找到相近姿势,说明在这组条件下重复找到了相近的解,不能独立证明在溶液中确实结合,更不能把打分换算成实验亲和力报告给读者。
对一批配体做筛选时,可以先挑柔性差别大的少数代表分子,保存输入校验值、种子、搜索盒、每个实际写出的构象和首位姿势的重复差异。这样某个分子排名异常时,能回头检查是口袋设置、构象搜索还是文件抽取造成变化。要把同样的复核扩展到整个配体库和多个受体构象,可了解云生信的生物信息分析服务器。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)