生信论文返修实战20讲 · 第13讲 · 审查模型与功能证据
系列目录:生信论文返修实战20讲(当前第13讲)
- 第01讲:收到返修意见后怎么办?把审稿问题拆成可执行任务
- 第02讲:返修前先冻结分析:输入、版本与结果怎样重放
- 第03讲:样本量为什么对不上?核查纳入、排除与重复测量
- 第04讲:样本太少怎样回应?报告效应、区间与真实限制
- 第05讲:差异分析被质疑:模型、方向和多重检验逐项核查
- 第06讲:要求校正年龄和批次?先判断资料是否支持
- 第07讲:换个阈值还成立吗?做有边界的敏感性分析
- 第08讲:独立验证不一致怎么办?保留全部候选与证据
- 第09讲:富集结果怎样返修?检查背景、方向和贡献成员
- 第10讲:单细胞显著性可靠吗?先认清细胞、文库与供体
- 第11讲:细胞注释与比例被质疑:标记依据和分母怎样交代
- 第12讲:拟时序和通讯怎样改写?避免把推断写成机制
- 第13讲:模型性能过高先查什么?用随机标签识别数据泄漏(本篇)
- 第14讲:只有ROC不够:校准、误差与简单基线一起评价
- 第15讲:生存分析怎样返修?事件、截点与模型假设核查
- 第16讲:审稿人要求补实验:公共数据能支持到哪一层
- 第17讲:图形与图注怎样修改?展示样本、效应与不确定性
- 第18讲:方法写到哪里才够?参数、版本与数据代码可用性
- 第19讲:逐条回复怎么写?把动作、证据和修改位置对应起来
- 第20讲:提交返修前最后一查:正文、回复与附件保持一致
点击目录按篇次顺序学习;文末复现包包含全系列代码与起始数据。
模型性能太漂亮,先检查测试信息有没有泄漏
预测模型返修中,最值得警惕的错误往往发生在训练开始之前。例如先用全部样本筛选差异基因,再把筛后的矩阵分成训练集和测试集。即使后续交叉验证写得很规范,测试标签已经参与了特征选择,性能仍可能偏高。本篇用纯随机数据演示这个问题,让信息边界变得直观。
教学审稿意见:请说明特征选择、标准化与参数选择是否全部在训练数据内完成,并排除数据泄漏。
本篇没有建立真实疾病诊断模型。每次生成一百个样本、一千个随机特征以及与特征独立的平衡标签,重复二十次。比较两种流程:先在全数据选特征再交叉验证,以及每个训练折内部重新选特征后预测对应测试折。数据、标签与结果都明确属于模拟。
泄漏不是只有把结局放进特征这一种
最直接的泄漏是把结果变量或结果发生后才可获得的信息放入预测输入。更隐蔽的情况包括在全部数据上筛基因、估计缺失值填补规则、选择阈值或反复根据测试性能调整模型。某些预处理是否构成泄漏取决于它学习了什么信息,但保守而清晰的流程通常把需要拟合的步骤放在训练范围内。
同一受试者的重复样本分到训练和测试两侧,也可能让模型利用个体特征而非目标疾病规律。随机按细胞或切片分折尤其容易发生这种问题。分割单位应与未来应用对象一致,并保留供体、家庭、中心或时间结构中需要隔离的层级。
本例使用相同的分层五折,两种流程都选十个特征并采用线性判别分析。这样主要差别集中在特征选择是否接触测试标签。正确流程中,每折的特征可能不同,这不是错误,而是反映选择过程本身的变异。不能为了得到一套统一名单,提前用全体样本决定特征再声称仍是严格验证。
| 步骤 | 训练内可以做什么 | 测试集应该承担什么 |
|---|---|---|
| 特征筛选 | 估计与结局关联并选特征 | 只接受已确定的输入规则 |
| 预处理拟合 | 学习填补和缩放参数 | 应用训练得到的参数 |
| 模型拟合 | 估计系数 | 生成未见样本预测 |
| 参数选择 | 训练内部验证比较 | 不反复指导选择 |
| 最终评价 | 冻结流程后评估 | 报告所有预定指标 |
为什么随机标签也能得到高分
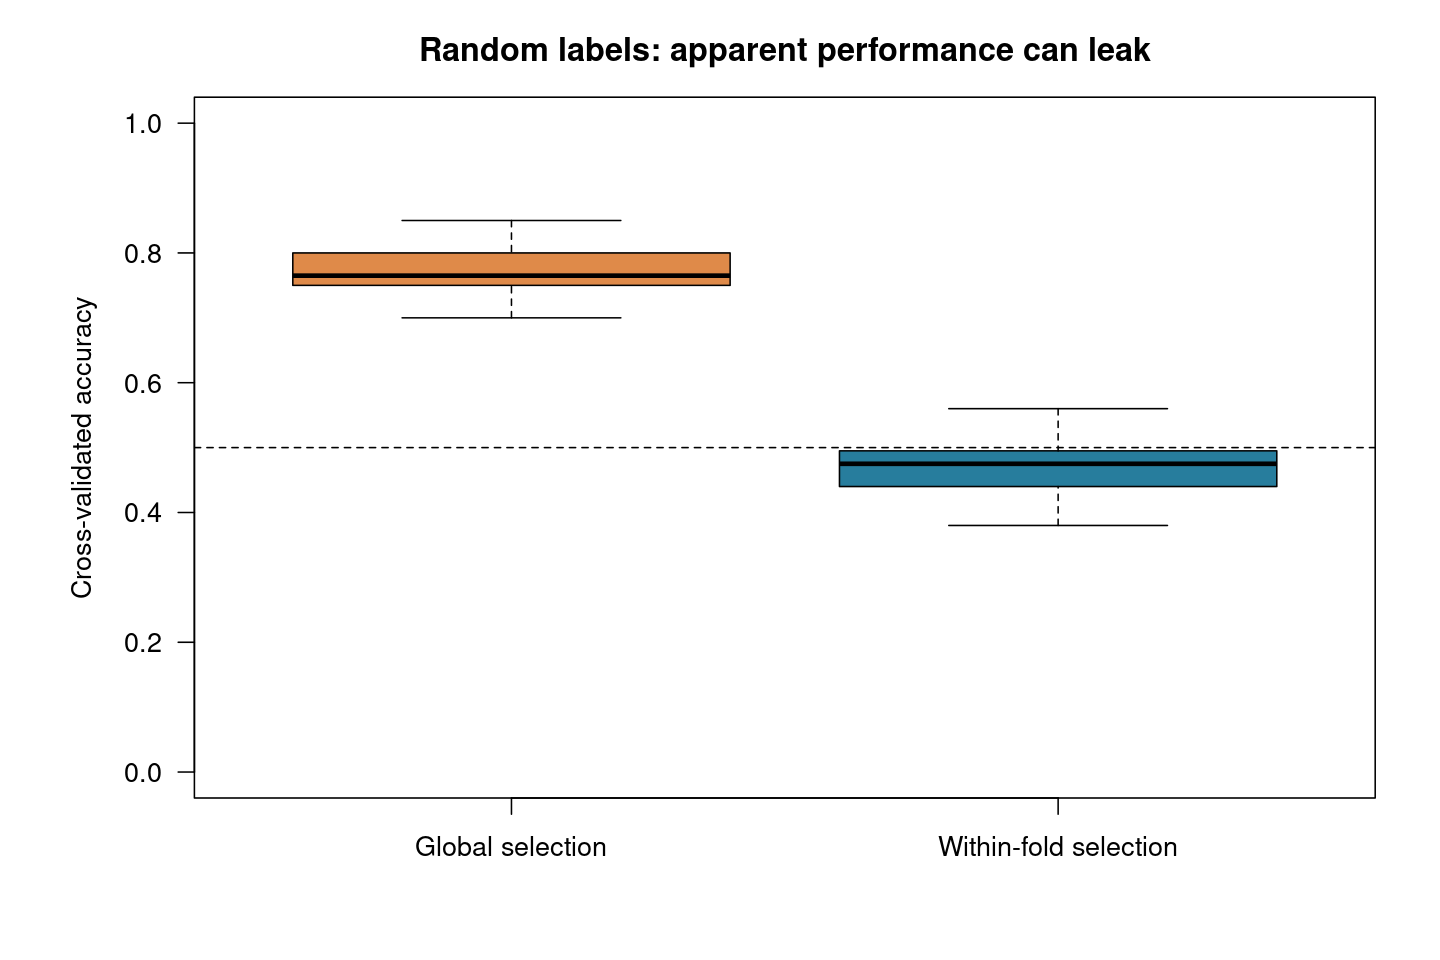
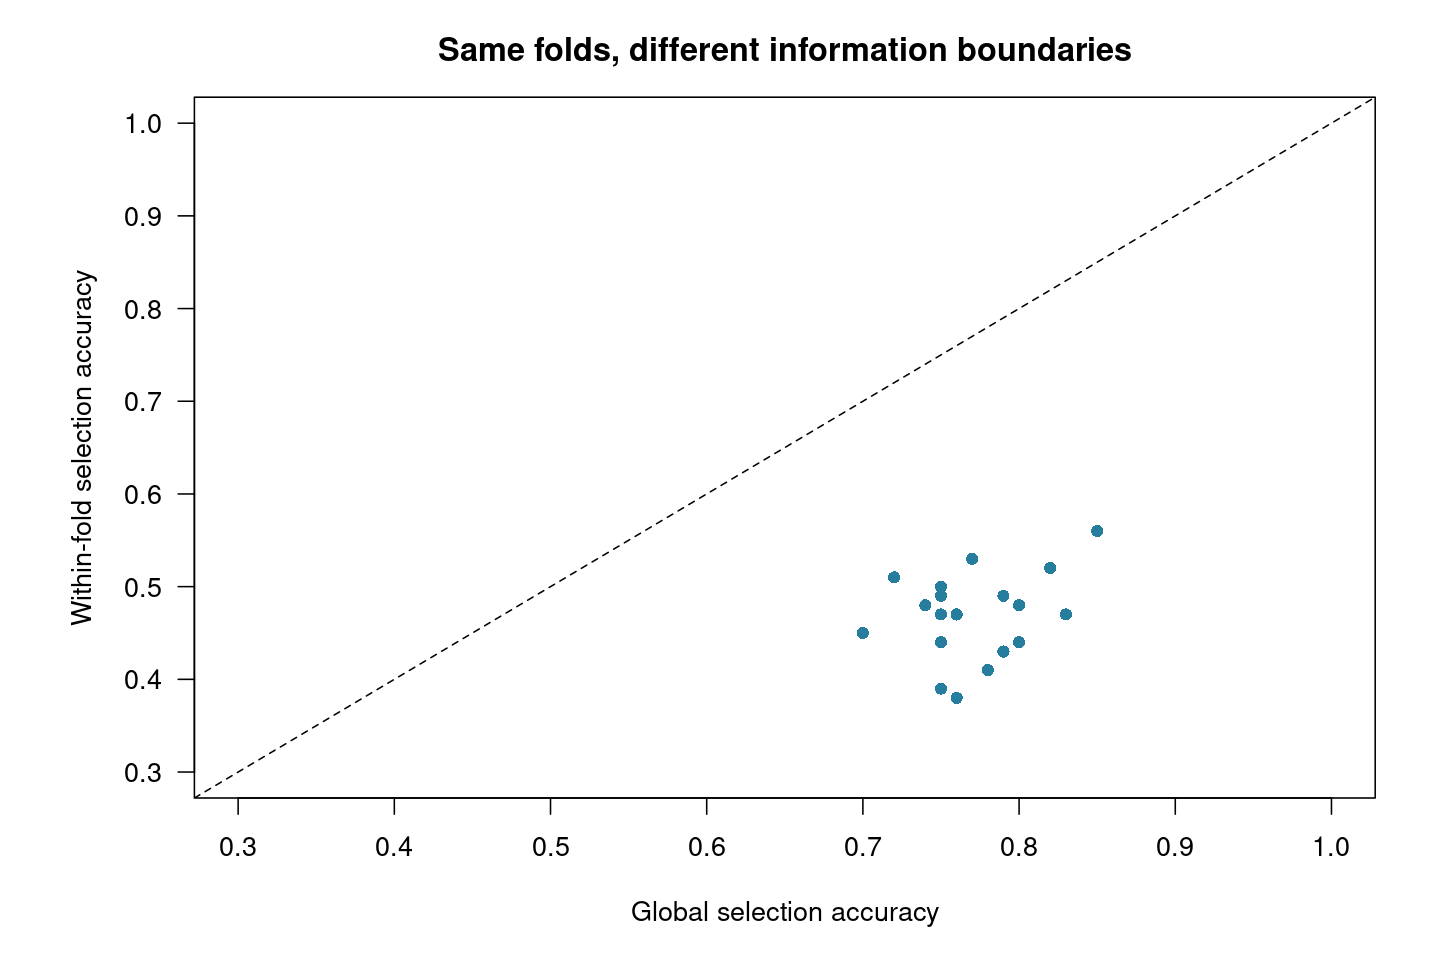
本次二十次模拟中,全数据筛选流程的平均交叉验证准确率约为零点七七三,训练折内筛选约为零点四六九五。两者使用相同折分和纯随机特征标签,差异展示信息边界的重要性;这些数字不是实际患者模型性能,也不是任何算法的普遍准确率。
在一千个纯噪声特征中,总有一些偶然与当前标签相关。全数据筛选会挑出这些偶然相关,而测试折标签已经参与了挑选。后续看似独立的预测,实际上继承了测试信息。样本相对特征越少,这种选择偏差往往越值得关注。
训练折内筛选仍然会找到偶然相关,但这些关系未必延续到未参与筛选的测试折,因此性能更接近无信息水平。模拟图并不保证每次恰好等于随机猜测,有限样本存在波动。重点是两种流程在相同数据与折分下的系统差异,而不是追求某个固定准确率。
本例没有调节模型超参数,所以“折内筛选”不等于已经演示完整嵌套交叉验证。如果真实流程还需要选择特征数、惩罚强度或算法,应在外层训练数据内部安排相应选择,再用外层测试评估整个选择流程。不能把代码变量名中的“nested”当作已经实现所有嵌套步骤的证据。
怎样审计自己已有的模型
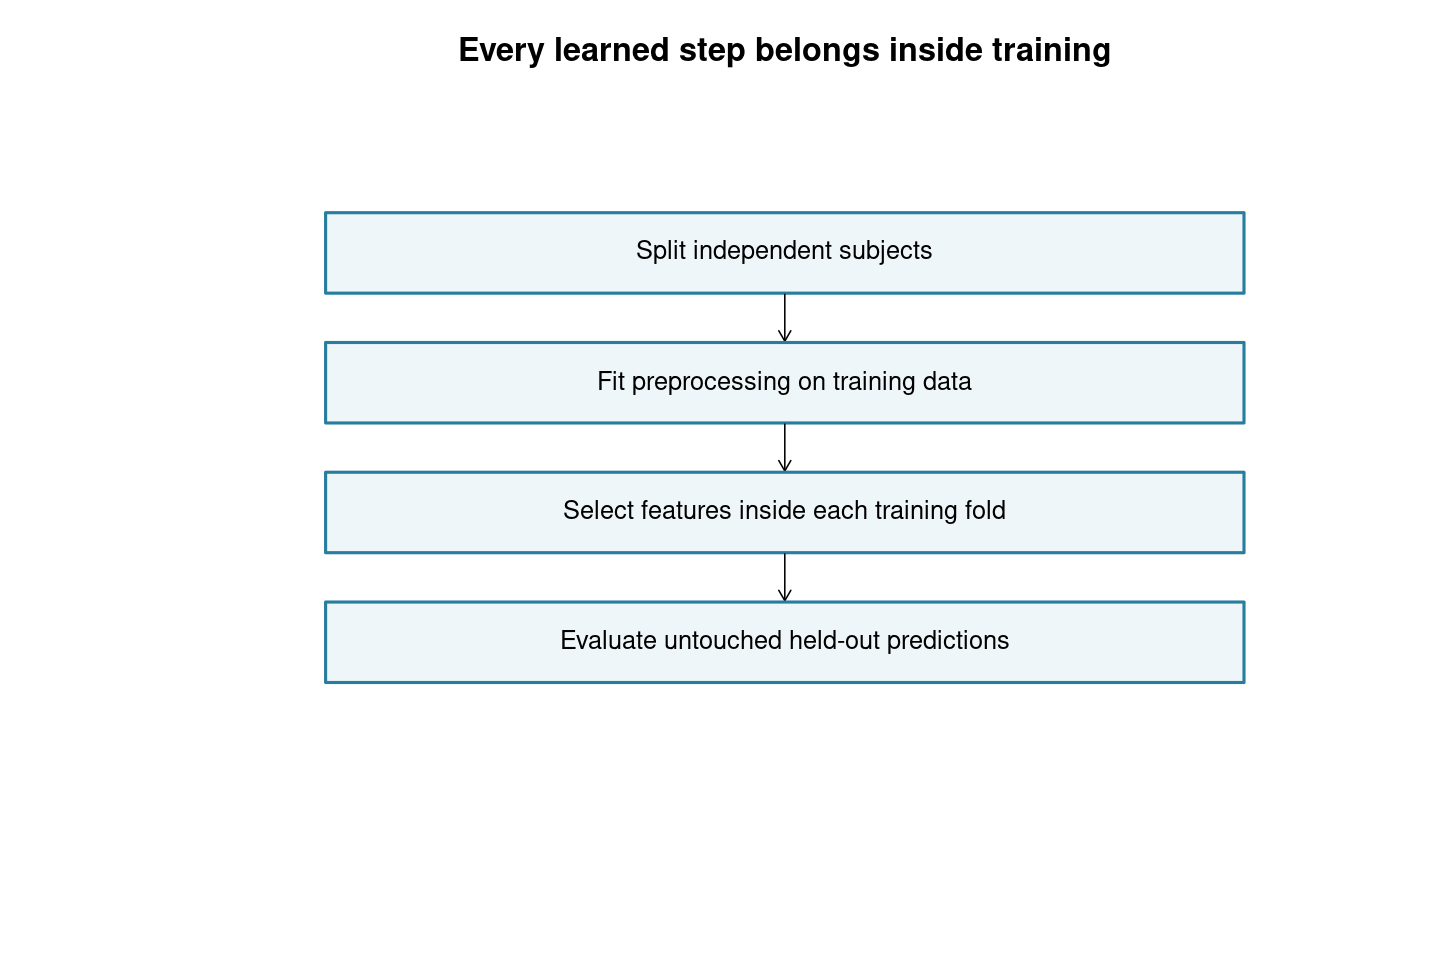
从最终测试预测向前追踪:每个系数、每个特征、每个填补值规则、每个阈值分别看过哪些数据。把流程画成图,在每一步标出训练、内部验证和最终测试的范围。如果某个选择使用了最终测试结局,就应重新评估该测试集能否继续承担独立评价角色。
若发现泄漏,不应只在方法中补一句“采用交叉验证”。需要重新构建完整流程并重算性能,可能还要重新评估候选稳定性和模型复杂度。性能下降是合理的修正结果,不应通过更换随机种子、删除困难样本或增加尝试次数来恢复原来的高分。
随机种子用于重放分割,不应被当作优化参数。报告一个特别幸运的分割会低估不确定性。可以采用事先说明的重复验证策略并保留全部结果,但需要注意重复折之间并非独立研究,不能把大量折数写成大量独立外部验证。
特征名单与模型验证是两个交付物
交叉验证评估的是一个学习流程,而最终部署模型通常会在允许的开发数据上重新拟合。最终特征名单可以与各折名单不同,需要说明其来源。不能用开发集重拟合后的表现替代交叉验证性能,也不能把最终系数直接当成经过外部重复的生物学效应。
如果模型用于临床或其他实际场景,还需要考虑目标人群、测量条件和部署后的可获得信息。本篇纯噪声演示仅用于理解信息边界,不构成可使用的诊断模型。下一篇使用公开教学资料展示评价方法,同样不作临床应用建议。
运行方法与交付文件
下载文末完整复现包,先解压并保留目录结构,将R的工作目录切换到workbook目录。输入位于data,公共函数位于scripts/common.R,分篇结果位于results。附件保留前序输出,便于单篇学习;如果改变输入、模型或前序参数,应顺序重跑所有受影响步骤,避免新数据与旧结果混用。
Rscript scripts/13.R
本篇脚本会生成三张图和对应表格。先检查日志是否正常结束,再核对实际输出的样本、字段、尺度与正文,不要仅凭文件存在判断运行成功。环境记录来自实际验证,包版本不是自动锁定;安装时需保持R与依赖相容。完整顺序运行入口和原始公开数据整理方法见包内说明,模拟与公开观测数据分别标注。
下面列出本篇完整R脚本。初学者可先原样运行,再在副本中改变一个参数观察影响。保留原始输入,不通过改组别、补造临床字段或删除不合预期的样本来解决报错。遇到缺少文件,首先检查工作目录和前序依赖;遇到数值差异,先核查版本与输入,再解释科学含义。
source("scripts/common.R")
o<-start(13)
# 全部数据为随机模拟:100样本、1000特征、标签与特征独立
rank_features<-function(x,y){a<-x[y==1,,drop=FALSE];b<-x[y==0,,drop=FALSE];score<-abs(colMeans(a)-colMeans(b))/sqrt(apply(a,2,var)/nrow(a)+apply(b,2,var)/nrow(b));order(score,decreasing=TRUE)[1:10]}
results<-list()
for(rep_id in 1:20){x<-matrix(rnorm(100*1000),100,1000);y<-rep(0:1,each=50);fold<-integer(100);for(g in 0:1)fold[y==g]<-sample(rep(1:5,each=10));leaked<-rank_features(x,y);pred_bad<-pred_good<-integer(100)
 for(k in 1:5){tr<-fold!=k;te<-!tr;inside<-rank_features(x[tr,],y[tr]);pred_bad[te]<-as.integer(as.character(predict(MASS::lda(x[tr,leaked],factor(y[tr])),x[te,leaked])$class));pred_good[te]<-as.integer(as.character(predict(MASS::lda(x[tr,inside],factor(y[tr])),x[te,inside])$class))}
 results[[rep_id]]<-data.frame(repetition=rep_id,leaked_accuracy=mean(pred_bad==y),nested_filter_accuracy=mean(pred_good==y))}
z<-do.call(rbind,results);tab(z,paste0(o,"/null_leakage_experiment.csv"))
fig(paste0(o,"/fig1.png"),{boxplot(z[,2:3],names=c("Global selection","Within-fold selection"),col=c("#DF8A49","#277D9D"),ylim=c(0,1),ylab="Cross-validated accuracy",main="Random labels: apparent performance can leak");abline(h=.5,lty=2)})
fig(paste0(o,"/fig2.png"),{plot(z$leaked_accuracy,z$nested_filter_accuracy,xlim=c(.3,1),ylim=c(.3,1),pch=16,col="#277D9D",xlab="Global selection accuracy",ylab="Within-fold selection accuracy",main="Same folds, different information boundaries");abline(0,1,lty=2)})
fig(paste0(o,"/fig3.png"),flow(c("Split independent subjects","Fit preprocessing on training data","Select features inside each training fold","Evaluate untouched held-out predictions"),"Every learned step belongs inside training"))
运行后查看每次模拟的两种准确率,而不是只读均值。检查脚本中选特征函数的调用位置:错误流程位于折循环之外,正确流程位于每次训练折内。这个位置差异比模型名称更重要,也是返修方法描述必须能够反映的关键步骤。
怎样改写原稿和回复
教学原稿:“我们先筛选全部样本中的差异基因,再通过五折交叉验证证明模型性能。”修改稿:“特征选择在每个训练折内重新执行,测试折仅用于生成和评价未见样本预测;所有需要学习的预处理与选择步骤均按其实际范围说明。”只有真实实施后才能写第二句话。
中文回复示例:“我们用随机标签教学模拟比较了全数据筛选与训练折内筛选,展示信息泄漏可能造成的性能偏高。对应真实稿件时,需要按同样原则重建并重算完整流程;本模拟不被写成已经修复某个真实患者模型。”
英文示例:“The teaching simulation contrasts global feature selection with selection repeated inside each training fold. It illustrates performance inflation from information leakage. It is not presented as validation or correction of an actual patient model.”
提交前的一次边界检查
把测试集结局暂时设为不可见,询问当前流程能否完成全部训练和预测。如果某一步必须知道测试结局才能选基因或阈值,就需要重新安排。这个思考实验很简单,却能发现许多代码结构上的问题。真实执行时仍应保留原始数据和正式审计记录,不要破坏输入文件。
还要检查患者重复、中心分组和时间顺序,确保测试任务符合预期应用。解决泄漏之后,高AUC仍然不能回答所有问题。下一篇将把区分能力、概率准确性和简单基线放在一起,让模型评价不再只依赖一条ROC曲线。
实操练习:逐个追踪模型里的“学到的数字”
列出流程中所有需要从数据估计的数字,包括均值、标准差、缺失填补值、特征排序、系数、惩罚参数和分类阈值。为每项写出它使用了哪些样本及是否接触结局。即使某一步叫预处理,也可能改变模型,不能因为它发生在训练函数之外就忽略信息来源。
在本篇模拟代码中找到全数据筛选位置,再找到每折内部筛选位置,比较函数接收的样本下标。只看函数名称难以发现泄漏,必须检查数据范围。随后追踪预测向量,确认每个样本的交叉验证预测都来自没有使用该样本进行特征选择与拟合的训练过程。
检查是否存在重复个体或相互关联的记录。若一个患者有多个样本,普通随机分折可能把同一个体分到两侧。应根据问题使用分组划分,或在需要时采用时间与中心隔离。目标是评价未来会遇到的独立对象,而不是让模型辨认已经在训练中见过的个体特征。
如果调过很多模型,记录选择过程。最终测试集被反复查看后,即使没有直接进入拟合,也可能通过人的决策影响模型。此时应承认其角色已被部分用于开发,不能继续把最后一次性能写成完全未接触的评价。新的独立资料或合适的嵌套设计可以帮助重新建立边界。
本例仅固定算法和特征数,演示折内筛选,因此不需要内部调参循环。真实研究若要选择特征数量,应把这项选择加入训练内部验证。不要为了减少计算把测试集结果用于决定特征数,再把最终模型称为严格交叉验证。计算成本可以优化,信息边界不能通过省略步骤改变。
把原稿中关于特征选择和验证的两段文字连起来读,检查时间顺序是否与代码一致。很多方法段分别看都合理,组合起来却显示先用全数据选择再验证。返修应同时修改流程、结果和文字,不能只把“训练集”三个字补进原方法而不重新运行。
最后保留逐样本未见预测、分折标识和全部重复结果。它们能够支持指标复算和错误排查,也能防止只报告幸运分割。模拟中的性能变化用于解释原理;迁移到实际数据后,仍需重新核查数据来源、变量可获得性和目标应用范围。
代码、数据与继续阅读
下载完整返修复现包:20篇R脚本、整理输入、起始结果、运行说明与版本记录。包含公共观测数据、明确标注的模拟与教学模板;不包含新实施的功能干预实验。解压后先阅读README。
承接第12讲:拟时序和通讯怎样改写?避免把推断写成机制。
下一篇第14讲:只有ROC不够:校准、误差与简单基线一起评价。
数据与方法来源
数据与方法核查日期:2026年11月16日。本文为教学二次分析;具体适用范围见正文。
需要把方法用到自己的数据中?
如果你需要把审稿意见转成具体分析任务,可以准备去标识的意见摘要、数据类型、当前脚本和主要证据缺口,沟通适合的核查范围与交付材料。 联系云生信,说明当前研究任务。