生信论文返修实战20讲 · 第16讲 · 审查模型与功能证据
系列目录:生信论文返修实战20讲(当前第16讲)
- 第01讲:收到返修意见后怎么办?把审稿问题拆成可执行任务
- 第02讲:返修前先冻结分析:输入、版本与结果怎样重放
- 第03讲:样本量为什么对不上?核查纳入、排除与重复测量
- 第04讲:样本太少怎样回应?报告效应、区间与真实限制
- 第05讲:差异分析被质疑:模型、方向和多重检验逐项核查
- 第06讲:要求校正年龄和批次?先判断资料是否支持
- 第07讲:换个阈值还成立吗?做有边界的敏感性分析
- 第08讲:独立验证不一致怎么办?保留全部候选与证据
- 第09讲:富集结果怎样返修?检查背景、方向和贡献成员
- 第10讲:单细胞显著性可靠吗?先认清细胞、文库与供体
- 第11讲:细胞注释与比例被质疑:标记依据和分母怎样交代
- 第12讲:拟时序和通讯怎样改写?避免把推断写成机制
- 第13讲:模型性能过高先查什么?用随机标签识别数据泄漏
- 第14讲:只有ROC不够:校准、误差与简单基线一起评价
- 第15讲:生存分析怎样返修?事件、截点与模型假设核查
- 第16讲:审稿人要求补实验:公共数据能支持到哪一层(本篇)
- 第17讲:图形与图注怎样修改?展示样本、效应与不确定性
- 第18讲:方法写到哪里才够?参数、版本与数据代码可用性
- 第19讲:逐条回复怎么写?把动作、证据和修改位置对应起来
- 第20讲:提交返修前最后一查:正文、回复与附件保持一致
点击目录按篇次顺序学习;文末复现包包含全系列代码与起始数据。
审稿人要求补实验,公共数据能补到哪一层
返修中最难的一类意见,是要求补充功能实验。作者可能希望用更多数据库结果回应,但不同证据回答的问题并不相同。本篇将前面已经完成的组织表达、独立研究和单细胞描述放入证据表,区分可以补强的部分与仍然没有完成的实验,帮助形成诚实而具体的修改方案。
教学审稿意见:当前分析主要为相关性,请提供功能实验支持候选基因在疾病过程中的作用。
这条教学意见不能简单翻译成“再做一个富集”。若论文核心结论是候选基因导致某种表型,那么观察性表达关联通常无法独立完成证明。公共数据可以检查重复性、表达来源和候选可行性,却不能把未实施的干预变成已经获得的机制证据。
将证据拆成五层
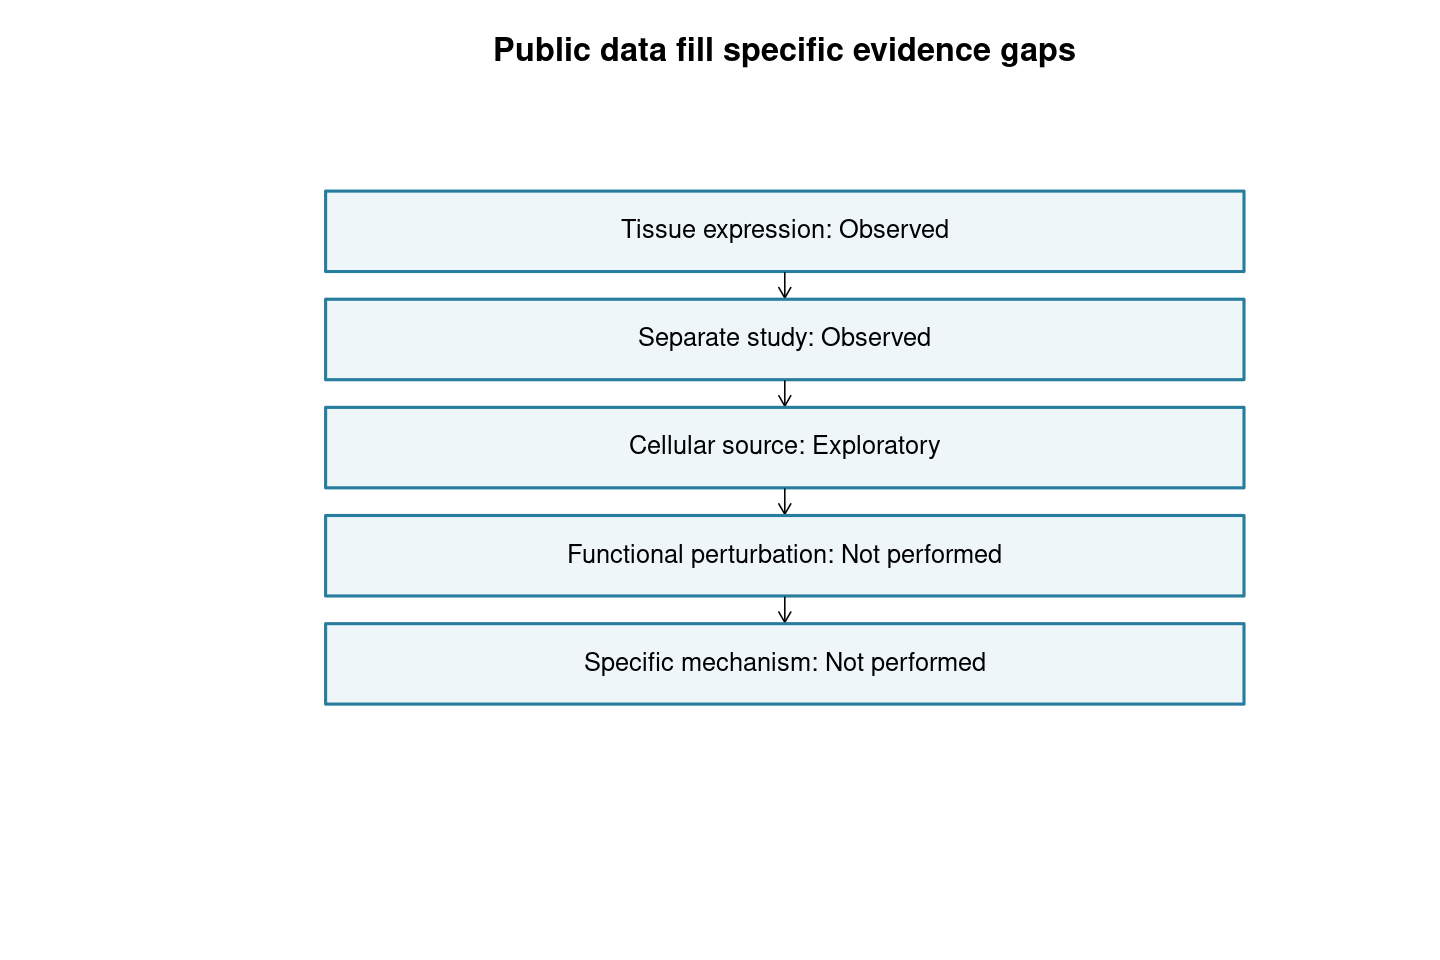
第一层是组织表达关联,第二层是另一研究中的相容性,第三层是细胞或状态定位,第四层是改变候选后是否影响目标表型,第五层是作用过程和特异性证据。层级不是机械评分表,不同问题需要的证据组合不同;它帮助判断当前主张依赖哪一环。
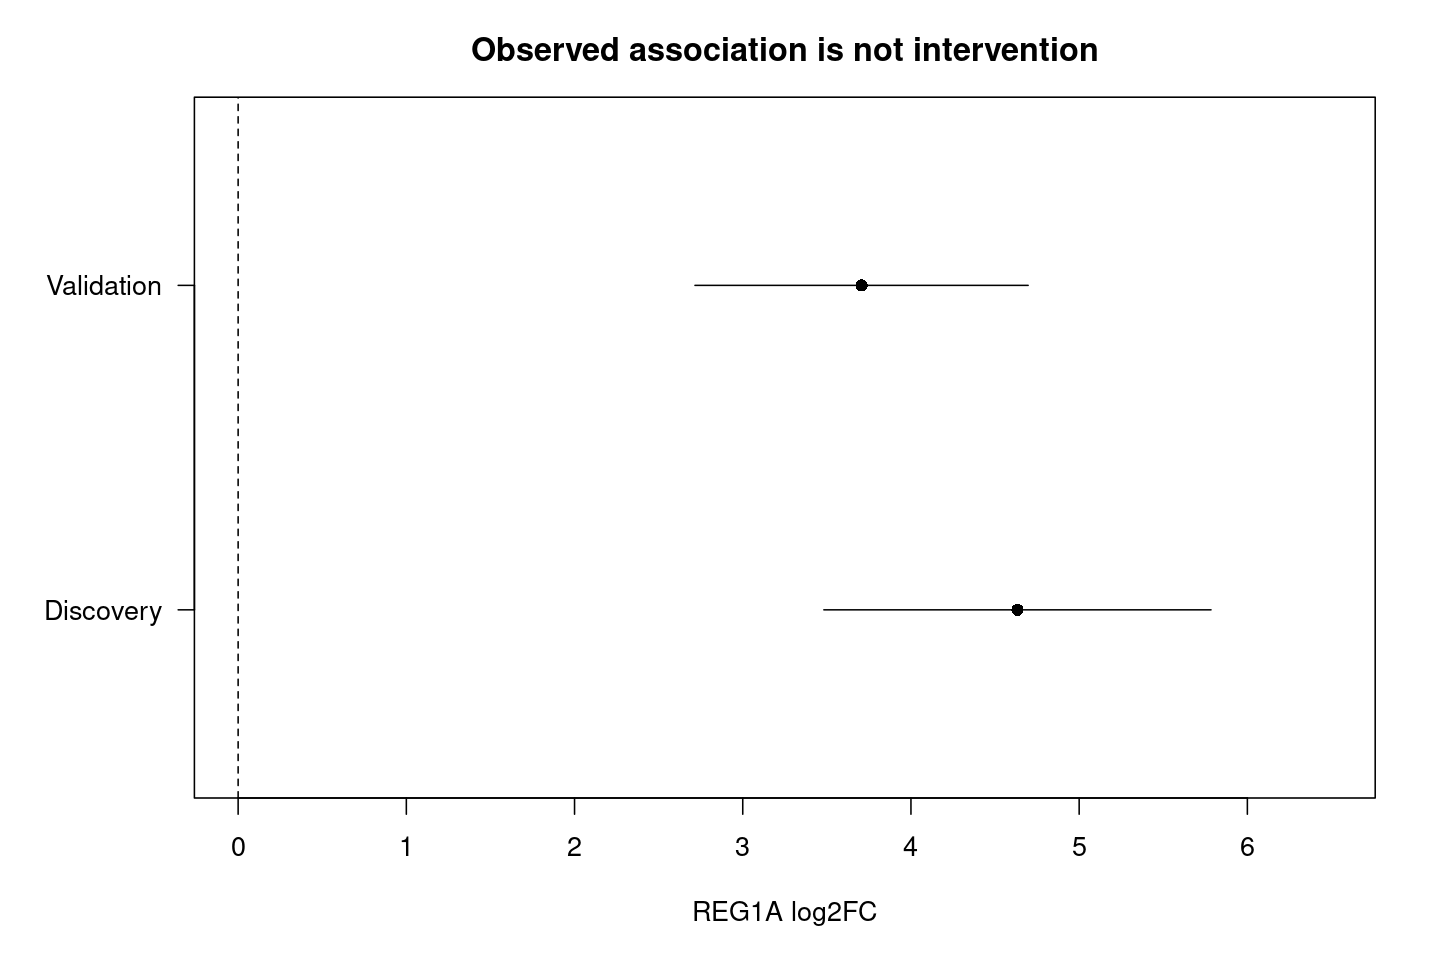
本系列实际观察到REG1A在两项组织研究中的分组关联,提供了固定面板的完整验证表。单细胞部分仅做上皮教学子集的文库状态描述,供体与原始计数限制仍然存在。功能干预、救援和特异机制没有实施,证据表明确标为未完成,不因文章需要完整故事而填上想象结果。
把这张表放在团队讨论中,能够避免不同合作者对“验证”一词理解不同。生信人员说的验证可能是另一队列同向,实验人员理解的可能是干预表型,审稿人要求的又可能是作用特异性。先统一问题,再安排工作,比直接承诺补一套实验更容易形成可执行方案。
| 证据层次 | 本系列状态 | 能够支持的判断 | 仍不能替代的内容 |
|---|---|---|---|
| 组织表达 | 已观察 | 分组关联 | 因果作用 |
| 另一研究 | 已检查 | 表达方向相容性 | 共同混杂排除 |
| 细胞定位 | 探索性 | 可能的状态来源 | 完整供体级验证 |
| 功能干预 | 未实施 | 只能提出计划 | 真实表型结果 |
| 机制与特异性 | 未实施 | 只能列出缺口 | 救援与作用过程证据 |
公共数据怎样有效补充
如果审稿人怀疑候选只在一个数据集出现,另一研究可以直接回应重复性;如果怀疑候选在相关细胞中根本不表达,细胞资料可帮助核查可行性;如果担心解释忽略替代机制,可以用现有信息整理竞争性假说。这些补充都有价值,但应明确对应的问题。
本例REG1A在两项研究中的效应方向相容,可以支持继续关注该候选。它也可能与损伤反应、补偿过程或细胞组成有关。仅靠当前表达资料无法区分这些解释。返修讨论应保留替代可能,而不是把方向一致自动转写为“促病作用已经确证”。
公共数据的背景与自己的实验背景也可能不同。组织、疾病阶段、处理条件和测量平台都影响可比性。引用另一个研究中的干预结果时,应准确说明该研究做了什么,不能把别人的实验写成自己的新增实验,也不能将不同模型中的结果无条件外推到当前结论。
如果决定补实验,先定义主要读数
实验计划需要明确研究对象、干预方式、对照、独立重复和主要结局。目标不应只是“看有没有变化”,而应说明怎样的结果支持或削弱假说。主要读数应与论文主张对应:表达改变、细胞功能和组织表型不是相同层次,不能用更容易测量的指标替代核心问题而不解释。
在实施前还应确认候选在所选模型中可测量、干预有效且基础条件适合。若干预没有成功,后续表型无变化不能直接解释为基因没有作用。若干预影响细胞总体存活,某个功能读数变化也可能来自非特异效应。计划阶段识别这些分支,有助于避免得到难以解释的结果。
本篇不提供具体实验操作参数或假想测量值。代码只生成证据缺口表和决策示意,真实实验需要适合研究模型的设计、伦理与质量控制。未执行的分组应写成计划,图中也不能画成带误差线的“结果柱状图”,否则容易造成证据状态混淆。
无法完成实验时如何回应
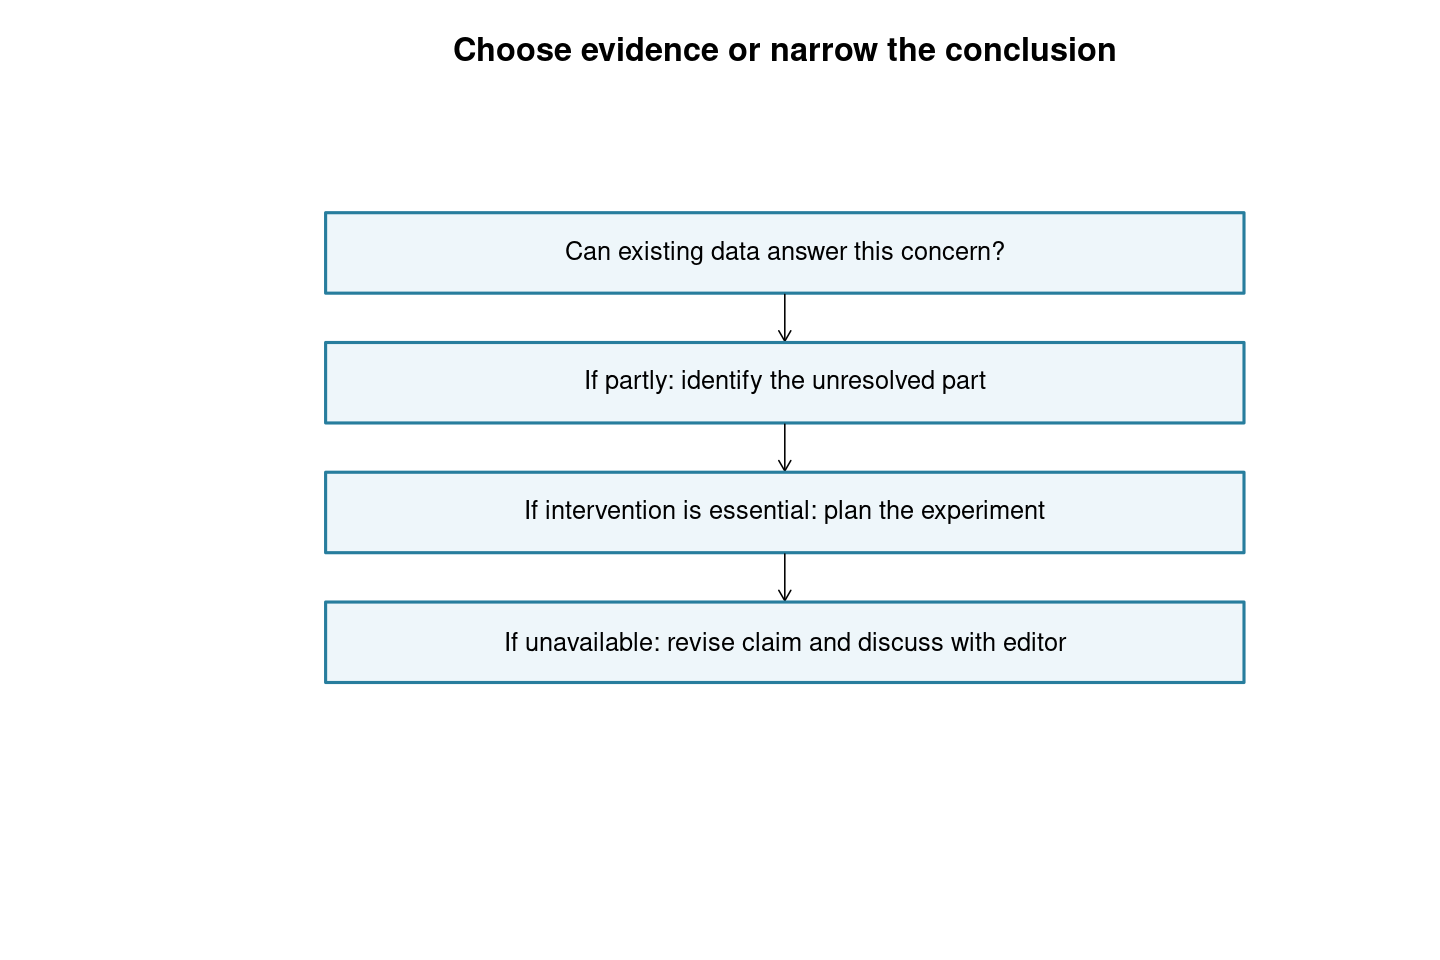
先判断实验是否支撑论文最核心的主张。如果主张本身需要功能证据,而当前确实无法获得,最实质的修改可能是降低结论层级、调整题目与摘要,并向编辑解释研究定位。单纯强调时间不足,通常没有回答证据缺口对结论的影响。
可以说明已经完成的替代核查、它解决了哪些担忧,以及哪些仍未解决。不要说“公共数据已经替代实验”,而应具体说“增加了表达重复性证据,但未验证功能作用”。若拟补实验需要更长周期,应提出明确可行的范围与时间安排供编辑判断,而不是承诺无法兑现的完整机制链。
运行方法与交付文件
下载文末完整复现包,先解压并保留目录结构,将R的工作目录切换到workbook目录。输入位于data,公共函数位于scripts/common.R,分篇结果位于results。附件保留前序输出,便于单篇学习;如果改变输入、模型或前序参数,应顺序重跑所有受影响步骤,避免新数据与旧结果混用。
Rscript scripts/16.R
本篇脚本会生成三张图和对应表格。先检查日志是否正常结束,再核对实际输出的样本、字段、尺度与正文,不要仅凭文件存在判断运行成功。环境记录来自实际验证,包版本不是自动锁定;安装时需保持R与依赖相容。完整顺序运行入口和原始公开数据整理方法见包内说明,模拟与公开观测数据分别标注。
下面列出本篇完整R脚本。初学者可先原样运行,再在副本中改变一个参数观察影响。保留原始输入,不通过改组别、补造临床字段或删除不合预期的样本来解决报错。遇到缺少文件,首先检查工作目录和前序依赖;遇到数值差异,先核查版本与输入,再解释科学含义。
source("scripts/common.R")
o<-start(16);v<-read.csv("results/08/external_panel.csv");reg<-v[v$gene=="REG1A",]
# 仅已完成的公共数据关联记为Observed,实验保持Not performed
ledger<-data.frame(question=c("Tissue expression","Separate study","Cellular source","Functional perturbation","Specific mechanism"),status=c("Observed","Observed","Exploratory","Not performed","Not performed"),needed=c("Report effect/limits","Report all candidates","Better donor-aware validation","Suitable model and controls","Targeted intervention and rescue"));tab(ledger,paste0(o,"/evidence_gap.csv"))
fig(paste0(o,"/fig1.png"),flow(paste(ledger$question,ledger$status,sep=": "),"Public data fill specific evidence gaps"))
fig(paste0(o,"/fig2.png"),{plot(c(reg$logFC_D,reg$logFC_V),1:2,xlim=c(0,6.5),ylim=c(.5,2.5),yaxt="n",pch=16,xlab="REG1A log2FC",ylab="",main="Observed association is not intervention");axis(2,1:2,c("Discovery","Validation"));segments(c(reg$CI.L_D,reg$CI.L_V),1:2,c(reg$CI.R_D,reg$CI.R_V),1:2);abline(v=0,lty=2)})
fig(paste0(o,"/fig3.png"),flow(c("Can existing data answer this concern?","If partly: identify the unresolved part","If intervention is essential: plan the experiment","If unavailable: revise claim and discuss with editor"),"Choose evidence or narrow the conclusion"))
运行脚本后检查证据表的状态列,特别关注未完成项是否在任何图注或回复中被写成完成。本篇把观察、探索和未实施分别保存。读者可以替换成自己的证据文件,但状态改变必须有实际结果支持,不能因为计划已经讨论过就自动升级。
修改稿和回复的不同层次
教学原稿:“综合生信分析证明REG1A通过特定机制促进疾病。”修改稿:“公共组织资料支持REG1A与疾病状态相关,单细胞教学分析提供表达来源线索。候选的功能作用及特异机制尚未验证,当前结果用于提出可检验假说。”
中文回复示例:“我们同意当前资料不能建立功能因果关系。新增的独立研究检查补充了表达关联证据,但没有替代干预实验。我们已收窄机制表述,并在证据表中明确功能与特异性验证尚未完成。”这段回复承认限制,同时说明实质修改,不把未完成工作隐藏在礼貌措辞后面。
英文示例:“We agree that the current data do not establish a functional causal relationship. The separate-study analysis adds expression-association evidence but does not replace intervention experiments. We narrowed the mechanistic claims and explicitly identify the untested functional steps.”
让补证据方案能够被审阅
把每项拟补工作写成“问题—测量—判断—限制”四列。若两个实验回答同一层问题,而最关键的缺口仍然空着,就需要重新安排优先级。对于无法完成的部分,给出对应的措辞修改,而不是只留一句“未来研究进一步探索”。
返修的目标是让证据与结论匹配。可能的结果是增加关键实验,也可能是发现原来的机制主张需要收窄。下一篇把已经稳定的结果整理成图与图注,确保读者看到的不是更漂亮的包装,而是能够核查样本、效应和不确定性的完整表达。
实操练习:把补实验要求变成可审阅的证据方案
先用一句话写出论文最强的主张,然后标出其中需要干预才能支持的部分。例如“表达较高”与“促进疾病”之间,缺少的是作用方向和功能证据,而不是另一张同样的箱线图。把这个缺口写清楚,才能判断新增公共数据、补充实验或收窄结论分别能够解决哪一部分。
为每项现有证据填写来源、测量对象、比较和限制。组织表达提供的是组织层面关联,单细胞描述提供可能来源,另一个研究提供相容性。它们可以互相支持研究可行性,却不能简单相加成为因果证明。若引用已有文献中的实验,应注明原研究对象和条件,不把它归为本次新增工作。
接着列出最小可解释实验需要的条件:模型中候选确实可测,干预有效,有适当对照,主要读数与主张对应,并保留独立重复。这里不需要预先画出显著柱图,而应写出可能结果的不同解释。干预无效、总体毒性或测量失败都可能使结果无法支持原问题,应在计划中考虑。
如果实验不可行,分别说明是时间、资料、模型还是资源限制,并解释它对论文定位的影响。仅说“条件有限”太笼统;更有用的是指出哪一层结论因此不能保留,以及已如何修改摘要和讨论。若核心主张无法获得必要证据,应与编辑沟通范围,而不是用不相关分析填满补充材料。
将每项计划与实际完成状态分开保存。计划已讨论、试验已启动和结果已通过质量检查,是三个不同阶段。回复中的完成时只能对应后者。尤其不能根据文献预期编写“结果显示”,或在示意图中放置像真实测量一样的误差线与显著性标记。
最后写一份两段式说明:第一段说明公共数据补充了什么,第二段说明仍缺什么及结论怎样改变。两段都应具体到当前研究问题。这样的回应既体现已经完成的工作,也让审稿人能够判断未完成部分是否仍影响论文可接受性,而不是被迫从模糊措辞中猜测。
当新增实验真正完成后,再回到证据表更新状态,并重新检查是否支持原假说。结果不符合预期同样需要进入讨论,不能只记录成功分支。证据方案的价值在于帮助研究者作出可检验判断,而不是确保返修故事按照最初设想发展。
代码、数据与继续阅读
下载完整返修复现包:20篇R脚本、整理输入、起始结果、运行说明与版本记录。包含公共观测数据、明确标注的模拟与教学模板;不包含新实施的功能干预实验。解压后先阅读README。
承接第15讲:生存分析怎样返修?事件、截点与模型假设核查。
下一篇第17讲:图形与图注怎样修改?展示样本、效应与不确定性。
数据与方法来源
- PLOS Biology:返修与逐条回复要求
- 发现资料GSE75214
- 验证资料GSE87466
- limma官方文档
- 上皮单细胞GSE116222
- 原研究单细胞处理代码
- Seurat官方:伪重复与样本层级
数据与方法核查日期:2026年11月16日。本文为教学二次分析;具体适用范围见正文。
需要把方法用到自己的数据中?
如果你需要把审稿意见转成具体分析任务,可以准备去标识的意见摘要、数据类型、当前脚本和主要证据缺口,沟通适合的核查范围与交付材料。 联系云生信,说明当前研究任务。