
给两版注释做验收时,常见做法是先看 BUSCO 完整度。假如两版都是百分之百,其中一版却比另一版多出三条蛋白,你能从报告里找到是哪三条吗?我们下载了大肠杆菌 K-12 MG1655 的公开蛋白集,先跑原样数据,再人为复制三条,最后移除另一条。三次使用同一套细菌标记,差别既能在汇总行中看到,也能沿着标记编号一直追到具体蛋白。NCBI 参考组装及蛋白数据
看见完整度前,先确认在数什么
BUSCO 为所选谱系准备了一组预期在大多数成员中出现、通常为单拷贝的直系同源标记。蛋白模式把输入蛋白与标记模型相比较,根据得分、匹配长度等条件决定能否找到足够完整的代表。表里每个标记只有一个分类。如果一个标记找到两个足够完整的代表,会归到完整且重复。把它和完整单拷贝相加,仍然只给总完整标记数贡献一项。看见完整度很高,只能说这组标记大多找到了,无法由此数出整份注释里有多少条蛋白重复。BUSCO 用户指南
这一点决定了对照怎么设计。单纯向文件尾部加几条任意序列,数字可能完全不动。要看重复会怎样归类,应先跑原始蛋白集,从详细表选出确实属于完整单拷贝、且只命中一个标记的蛋白。复制时只改记录名,氨基酸序列逐字保留。如此一来,若总完整度没有变化,便能区分是新记录没有命中,还是命中了但从单拷贝转成了重复。
实跑经验|三次使用同一套 124 个细菌标记
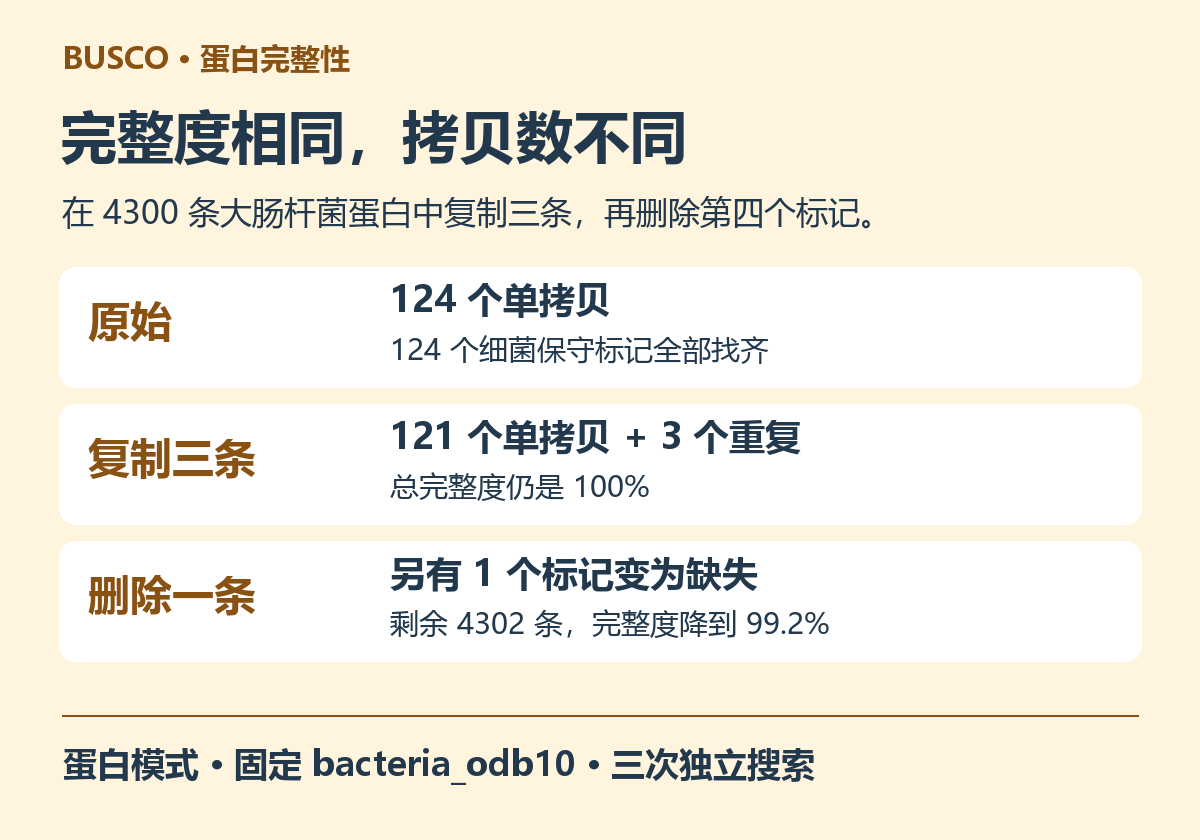
这次安装的是 BUSCO 5.5.0,使用日期为 2024 年 1 月 8 日的 bacteria_odb10,离线运行蛋白模式。原始 FASTA 有四千三百个不同的蛋白编号,程序在一百二十四个标记上全部找到完整单拷贝。第二次从基线详表取三条命中蛋白,各复制一份,保留原件,并给新编号加后缀。第三次在这个文件的基础上,另外删除一个先前完整单拷贝标记对应的唯一输入蛋白。三次都从头运行搜索,没有改写报告数字。BUSCO 谱系数据目录与版本记录
| 输入蛋白 | 条目数 | 完整单拷贝 | 完整重复 | 缺失 | 完整度 |
|---|---|---|---|---|---|
| 原始公开蛋白集 | 4300 | 124 | 0 | 0 | 100.0% |
| 为三个标记各添一份相同序列 | 4303 | 121 | 3 | 0 | 100.0% |
| 再删除第四个标记的蛋白 | 4302 | 120 | 3 | 1 | 99.2% |
第一眼看最后一行很容易忽略一件事,输入仍然比原始蛋白集多两条,完整度却下降了。新增的三条全部落在已有标记上,补不回另一个标记。这里的重复率约为百分之二点四,分子是三个分类为重复的标记,分母是一百二十四个预期标记。用新增的三条去除四千多条输入蛋白算另一种比例,两种数值会差很远。把分子、分母和每个标记的状态写全,读者才能重算。
从百分比找回具体蛋白
以 1009041at2 为例。原始报告把细胞分裂蛋白 FtsZ 的 NP_414637.1 记为完整,得分 260.1,命中长度栏为 218。复制后,详细表中同一标记下面有两行,分别对应原编号和带后缀的新编号,两行的得分和命中长度相同。汇总表却只多出一个重复标记。如果你把详细表每一行都当成一个不同标记计数,重复恰好会被多计一遍。按标记分组保留所有蛋白编号,再按状态汇总,两张表就能对上。
busco -i proteins.faa -m proteins -l /data/bacteria_odb10 \
  -o sample -c 4 --offline
cat sample/short_summary*.txt
awk -F '\t' '$1=="1009041at2"{print $1,$2,$3,$4,$5}' \
  sample/run_bacteria_odb10/full_table.tsv
拿到真实重复列表,先在基因注释里按蛋白编号找转录本和基因编号。若两个蛋白来自同一个基因的不同转录本,把每基因代表转录本单独导出再跑一次,并保留原始全集的分数。若分别位于不同区段,就比较基因结构、两侧邻近基因和测序深度。两段几乎相同且侧翼也成片重合,与相隔很远、侧翼不同的两个基因,需要完全不同的后续证据。重复可以来自真实复制、组装冗余或注释条目的组织方式,单凭该字母分类无法决定该删哪一条。
还有一种常见的对照,是把两版注释中状态都为完整单拷贝的条目也并排查看。一个标记在甲版命中一条长蛋白,在乙版命中另一条边界不同的蛋白,两边都可能达到最低要求。如果项目目的是改进某个基因家族的结构,就应比较氨基端、羧基端、功能结构域以及转录本证据。分类相同只说明两版都越过该标记的判断门槛,蛋白边界仍可能有值得处理的差异。
复核工作可以从一张小表开始,每行留一个有变化的标记,记录两版状态、命中的蛋白编号、对应基因、组装坐标和待补证据。把同一标记对应的多条记录放在一起,先挑能用原始转录本解释的条目,再把确实落在不同组装位置的交给组装人员核查。这样一份重复清单才能落实到具体文件和下一步实验。
缺失标记应该回到哪一层
这次人为删除的是 NP_414713.1,最后只有它对应的 1043239at2 变为缺失,底层参考组装从头到尾都没有改变。真实项目若在蛋白模式看到缺失,可先在同一份组装上检查相应基因组区段,或用合适的基因组模式做对照。如果基因组上有连续可解释的同源序列,但交付蛋白里没有,再追查预测、翻译和代表转录本筛选步骤。若对应区域本身有断点或大量未知碱基,则需要查看组装读段证据。先分清交付物是哪一层,能省掉很多无效的重新注释。
样本之间比较时,把谱系名、数据库发布日期、分类群背景、软件版本和模式随报告一起交付。不同谱系的标记总数和成员组成会变,同样少一个标记,扣掉的百分比也不同。对于品系特异基因、质粒抗性基因或本研究关心的代谢通路,另建目标清单逐项核查。即使这一百二十四项全齐,也无法回答清单外任意一个具体基因有没有提交完整。
下载本篇实验脚本与结果(12 篇合集 ZIP),解压后打开 076-busco 目录。
跨批次复核多版注释时,可以在云生信的生物信息分析服务器保留同一套谱系库和原始详表,逐个追踪变动的标记。


![两条满分侧翼,缺了哪一段。固定一条 3500 bp 模拟读段,比较两张只相差一条分支的图。完整图,一条比对穿过 1→3→4,查询覆盖 [0,3499),编辑距离为零。缺少分支,两条侧翼记录的 MAPQ 都是 60,中间 [1450,2050) 没有任何对应。计算覆盖,按查询名称合并区间,两段合计覆盖 2899 bp,离完整图差 600 bp。](https://i0.wp.com/www.biocloudservice.com/wordpress/wp-content/uploads/2026/11/graphaligner-high-mapq-split-gaf-graph-missing-allele-guide.png?fit=768%2C538&ssl=1)