
一份比对文件里有六十条已比对读段,换一个过滤条件后只剩三十条,并不一定是比对突然失败。本次实际运行 BWA-meth 后,保持输入和坐标不变,只增加一个特定方向的质量标记设置,就得到这样的结果。被标记的记录仍然具有高比对质量和有效坐标,但下游是否接纳它们取决于过滤规则。
本文安装运行 BWA-meth 0.2.10,后端为 BWA 0.7.19-r1273,并使用 Samtools 1.24 转换、排序、索引和计数。容器内 Python 为 3.14.7。输入是自行构造的参考与双端读段,本文没有执行甲基化提取或真实样本性能评估。工具定位与建议的下游衔接可查阅官方仓库。
一、先明确它主要解决的是比对问题
亚硫酸氢盐测序读段与原始参考之间可能出现大量由处理过程导致的碱基差异。如果把这些差异都当成普通测序错配,定位问题会变得不同。BWA-meth 使用相应的转换表示完成比对,再恢复输出中需要保留的读段信息。这个过程的目标是找到位置,不等于已经统计出每个胞嘧啶的甲基化比例。
因此,判断流程是否完成至少要分两层。第一层检查读段是否定位、方向与配对是否合理、原始测量序列是否保留。第二层才是根据合适的规则汇总位点状态,并考虑质量、覆盖、重叠配对及重复处理。拿到一个可以打开的 BAM 文件,只能说明获得了比对载体,不能自动说明第二层也已经完成。
BWA-meth 的官方说明将后续位点统计与其他任务交给相应工具。本文也遵守这个边界,主要验证索引、比对、序列恢复和质量标记。对于甲基化比例、转化效率或差异区域,本文没有输出结果,也不会从比对率间接推断这些指标。
二、一条参考,为什么生成两个转换版本
本例参考是一条二万四千碱基的虚构染色体。实际索引命令如下,它会根据原始参考创建转换文件与相应索引,不是只对原始参考执行普通比对索引。
bwameth.py index reference.fa
检查生成的转换参考,发现包含两条各二万四千碱基的序列。其中一条把胞嘧啶转换为胸腺嘧啶,另一条把鸟嘌呤转换为腺嘌呤。脚本不是只检查文件名存在,而是逐字符验证两条序列等于原始参考的相应转换。前一条胞嘧啶数量为零,后一条鸟嘌呤数量为零,与构造规则一致。
| 文件中的对象 | 本例长度 | 核验重点 |
|---|---|---|
| 原始参考 chrToy | 24000 | 保留原始序列与校验值 |
| 转换参考 fchrToy | 24000 | C 转为 T |
| 转换参考 rchrToy | 24000 | G 转为 A |
| 最终比对参考名称 | chrToy | 回到原始坐标命名 |
这个检查可以防止一种常见混淆,目录中有一套索引,就假设它一定对应当前参考。参考序列更新、文件被覆盖或者不同构建共用相似名称时,仅看扩展名无法判断。分析记录应绑定原始参考内容、转换文件和后端版本。重新生成索引不是为了形式完整,而是为了保证所有坐标和转换规则指向同一份序列。
本文没有比较不同后端索引的性能,也没有测试更大参考的内存需求。两条小序列能够快速完成索引,只说明演示流程成立。真实项目的成本取决于参考大小、数据量、后端选择和运行环境,不能从这个小案例外推全基因组耗时。
三、双端读段的方向,不能只靠文件名猜
我们生成三十对有效读段,其中十五对来自原始顶部链,十五对来自原始底部链。每个片段长度二百六十碱基,两端各测一百五十碱基,因此两端有四十碱基重叠。再加两对全未知碱基对照,总计三十二对、六十四条记录。
生成时先按设定转换片段中的胞嘧啶,再提取第一端与第二端的相应序列。第二端包含方向转换,不能简单复制第一端或把同一个字符串作为两端。脚本为每一对保存了两端的原始序列、预期起点和来源方向,便于比对后逐条核查。
实际输出中六十条有效读段均比对,四条全未知碱基记录未比对。六十条都具有预期坐标和完整的一百五十碱基匹配,基础运行中也都带有符合配对关系的标记。输入读名使用第一端、第二端后缀,输出归并到共同的片段名称,配对关系与生成记录一致。
这里的成功依赖于本例非常干净的输入。没有接头、插入缺失、复杂重复或真实测序质量分布,不能据此宣称软件在实际数据上具有百分之百定位准确率。小案例的合理用途,是为自己的安装和整理流程建立一个能明确检查对错的起点。
四、输出为什么仍要保留没有转换完的序列
比对时使用转换表示,并不意味着最终输出应该丢掉原始测序中的碱基信息。如果把所有胞嘧啶都永久改成胸腺嘧啶,后续就无法再区分哪些位置在原始读段里保留了胞嘧啶。转换便于定位,原始观测则是后续状态判断的依据,两者需要同时正确处理。
我们逐条比较最终比对中的序列与输入 FASTQ。对于以正方向存储的记录直接比较,对于带反向标记的记录,先按格式约定使用相应反向互补序列比较。六十条有效记录全部一致。这一步很重要,若不考虑比对方向,直接把两个字符串逐字比较,反而会把正常的格式表示误判成序列损坏。
本次输出还含有与转换方向相关的标签。它们帮助解释记录如何来自转换空间,但不能替代实际序列核验。判断恢复是否正确,最直接的依据仍然是原始 FASTQ、方向标记以及最终序列,而不是看到一个熟悉的标签就认为流程必然正确。
实际整理时应保留一小部分可回查的读名,使样本处理前后的记录能够连接。若中途重命名、删除后缀或混合文件而不留映射,出现配对异常后会很难追溯。读名整理看起来是格式工作,却可能直接影响配对识别与后续去重。
五、为什么 NM 为零,原始参考却有几十个不同碱基
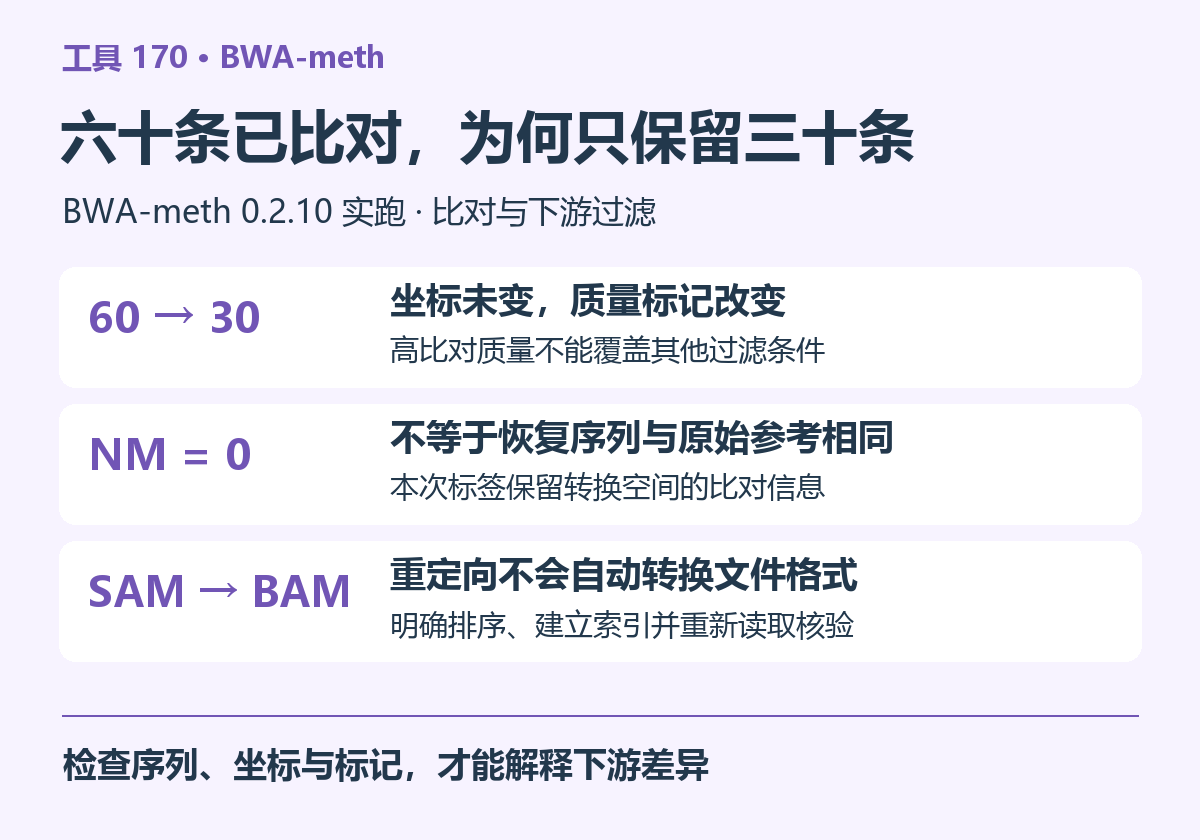
本次一个很有代表性的记录,原始输出序列与未转换参考逐位置比较有三十五处差异,记录中的 NM 标签却是零,MD 显示整段匹配。六十条有效记录的 NM 都为零,而它们与原始参考的逐字符差异范围为十九到五十处。
这表明在本次版本和运行路径中,这些标签保留了转换空间的比对信息,不能直接当作恢复后序列相对未转换参考的差异总数。上述差异是我们在生成读段时明确加入的转换结果,不是实验发现了几十个真实变异,也不是程序凭空改变了序列。
SAM 标签规范说明了标准字段的含义,但具体文件经过转换与恢复以后,仍需检查生成工具如何维护相关标签。BWA-meth 的实现代码与本次逐条核验结果可共同帮助追踪这一过程。不能拿普通测序中熟悉的解释,不加检查地套在经过特殊处理的文件上。
如果后续程序需要相对于原始参考重新计算的差异信息,应先核对它的输入要求,再决定是否派生一份重新计算的文件,并保留原始产物。直接覆盖原始标签会让后来者难以还原上游语义。更不能根据这里的差异字符串直接进行普通变异解释,因为它们包含测序处理方式带来的预期变化。
六、文件扩展名不会替你完成格式转换
BWA-meth 的本次实际输出是标准输出中的 SAM 文本。把重定向文件命名成 BAM,并不会让它自动变成压缩二进制比对文件。我们明确保存 SAM,再使用 Samtools 排序生成 BAM,最后建立索引。
bwameth.py --threads 2 --reference reference.fa \
  R1.fq R2.fq > normal.sam

samtools sort -@ 1 -o normal.bam normal.sam
samtools index normal.bam
samtools flagstat -O json normal.bam
分步骤保存的好处是每一步都可以检查退出码和产物。尤其在批量处理时,不能因为重定向创建了一个非空文件,就把该样本标成完成。需要确认文件头、参考名称、记录数以及后续读取是否成功。命令日志也应与结果分开保存,避免错误信息混进比对正文。
若将这些步骤改成管道,需要同时检查上游退出状态,不能只看最后一个程序是否退出成功。本次复现脚本采用分步执行,并检查每个返回值,所以本文数字来自完成排序后重新读取的结果,而不是根据命令形式推测它应该生成什么。
七、高比对质量为什么没有阻止记录被过滤
第二轮运行使用同一输入和索引,增加对指定来源方向设置质量失败标记的选项。本文这样做是为了演示标记的影响,不是建议一般文库启用它。
bwameth.py --threads 2 --reference reference.fa \
  --set-as-failed f R1.fq R2.fq > qc_forward.sam
结果仍有六十条有效坐标记录,所有比对质量仍为六十。但其中三十条被设置质量失败标记,同时本次实现清除了它们的正常配对标记。以第一对为例,两个旗标值由九十九、一百四十七,变成六百零九、六百五十七。位置和序列未变,变化发生在记录属性。
我们再用 Samtools 实际计数。只排除未比对记录,仍然得到六十条。再排除质量失败记录,结果为三十条。要求具有正常配对标记,也只剩三十条。这三个数字都正确,只是筛选条件不同。
| 计数条件 | 基础运行 | 指定方向标记后 |
|---|---|---|
| 已比对的主记录 | 60 | 60 |
| 已比对且通过质量标记 | 60 | 30 |
| 带正常配对标记的记录 | 60 | 30 |
高比对质量不能自动覆盖其他质量标记。比对质量、未比对状态、质量失败状态和配对关系是不同维度,下游程序可能同时使用其中几个。遇到“上游六十条、下游三十条”时,先比较筛选规则,比重新调整比对参数更有针对性。Samtools 计数文档也明确区分质量通过与失败的类别。
下面两条是本例实际执行过的过滤计数。第二条的排除值包含未比对与质量失败两种标记。本例没有次要或补充比对,因此结果可直接对应上表,真实数据若存在这些记录,还需要另行明确是否只统计主比对。
samtools view -c -F 4 qc_forward.bam
samtools view -c -F 516 qc_forward.bam
八、能读取 BAM,不等于具备下游所需信息
本次 BWA-meth 输出没有 Bismark 使用的甲基化调用字符串标签。因此,不能因为两个工具都输出 BAM,就假设它们的甲基化提取程序可以直接互换。BAM 是数据容器,工具还可能要求特定标签、排序方式、参考信息或配对组织。
本例的两端有四十碱基重叠,也提示后续位点统计需要处理同一片段重复覆盖的问题。读段层面有六十条记录,并不意味着每个覆盖位置都获得六十个独立分子的证据。本文没有实际进行位点汇总,所以不会把这段重叠转成一个未经运行的甲基化计数结论。
BWA-meth 的优势是能够利用成熟的比对后端,并输出便于常规比对工具检查的格式。它的局限是后续甲基化解释仍需相应流程,特殊转换标签与质量标记也需要被下游正确理解。判断一个分析组合是否适合自己,应检查这些接口要求,而不是只确认文件扩展名能够衔接。
九、这次实跑最值得保留的检查
本次环境曾出现依赖包在当前 Python 版本下的语法警告,但索引、比对、排序和逐条核验均完成。我们保留原始警告,没有为了让日志看起来干净而屏蔽全部标准错误。是否成功应由返回值、文件可读性和数值核验共同判断,不能仅凭日志里有没有提示文字。
下载本组完整脚本与实跑记录,在本篇目录执行下面命令,可以重新生成参考与三十二对读段。脚本固定镜像摘要,限制每个容器两核、四 GiB 内存,保存原始输入、转换参考检查、逐条坐标和序列比较、两轮质量标记结果以及过滤计数,建议每次使用新目录。
python3 run.py output
把这套检查迁移到真实项目时,优先保留参考内容校验、读名关系、转换与恢复的一致性、下游过滤条件四项。它们能回答很多比单独一个比对率更关键的问题,也能让后续甲基化分析建立在清楚的输入含义上。
当任务扩展到多批全基因组读段,需要统一保存索引、比对和过滤记录时,可通过云生信生物分析服务器服务开展可复现的批量处理。


