
做基因组质量评估时,完整度和污染度往往最受关注,但它们前面还有序列读取、基因预测和特征计算。输入中的未知碱基、片段边界与翻译表,会改变进入后续分析的蛋白和数值。遇到看起来异常的质量结果,回到这些中间证据,通常比反复修改筛选门槛更容易找到原因。
本文固定 CheckM2 1.1.0 的官方源码,并部署原版基因预测阶段需要的依赖,用同一段参考序列制作六组输入,实际运行原版前处理方法。实验记录覆盖基因预测、序列统计及蛋白核对。完整度和污染度的机器学习预测,需要继续使用匹配的功能数据库与模型流程,本文的实测数值均来自前处理阶段。
先看清报告前面的数据流
CheckM2 通过基因组特征预测完整度和污染度,工作流程包含蛋白预测、功能匹配和模型计算。官方说明也提供了蛋白输入方式,以及用于检查安装和数据库配置的测试命令。因此,正式比较样本前,应先明确输入究竟是核苷酸序列还是已经预测好的蛋白,并记录软件与数据库版本。CheckM2 官方说明
本文将注意力放在核苷酸输入到蛋白特征这一步。这里可以直接观察每个输入有多少碱基、多少片段、产生多少蛋白,以及编码区域覆盖了多大比例。它们对诊断输入问题很有帮助,同时各自也存在适用边界。
例如,新增未知碱基可能让序列长度和连续性指标增加,却没有带来可确定的新碱基信息。切开已有序列会增加片段边界,部分基因预测可能因此改变。若只看一个汇总数字,很难区分这些情况,保存原始序列和预测蛋白能提供进一步检查的依据。
用同一段参考序列构造六组条件
实验使用大肠杆菌参考序列 NC_000913.3 的前十二万碱基,对应从一开始计数的第一位到第十二万位。选择固定区间,是为了让每个人下载同一条参考后,都可以生成完全一致的输入。所有对照的文件校验值和原始参考序列校验值都写入结果记录。
第一组保留原始区间。第二组只把字母转成小写。第三组在区间末尾追加十二万个未知碱基符号。第四组把同样数量的未知符号插在原区间中间。第五组把原区间切成六十条两千碱基片段。第六组保持原始序列,同时强制使用第四号翻译表,作为参数敏感性对照。
本次前处理使用 CheckM2 源码提交 f0a9eb291df899890e23542591db5c852e200c35、Prodigal 2.6.3、Python 3.12 与 NumPy 1.26.4。最终记录来自作者发布的 Prodigal Linux 可执行文件。我们也核对了本地发行包的相同版本,两种可执行文件在原始区间、小写、末尾追加未知碱基、切分片段和强制翻译表五个条件下得到相同统计结果。本次 CheckM2 前处理实现、Prodigal 版本发布页
运行脚本接收源码目录、参考序列和输出目录,随后直接调用原版方法。输入与输出分别放在独立目录,避免预测产生的中间文件与原始序列使用同一个位置。
from checkm2.prodigal import ProdigalRunner

runner = ProdigalRunner("work/original", "input/original.fna")
features = runner.run("input/original.fna")
print(features)
先看六次运行留下的数字
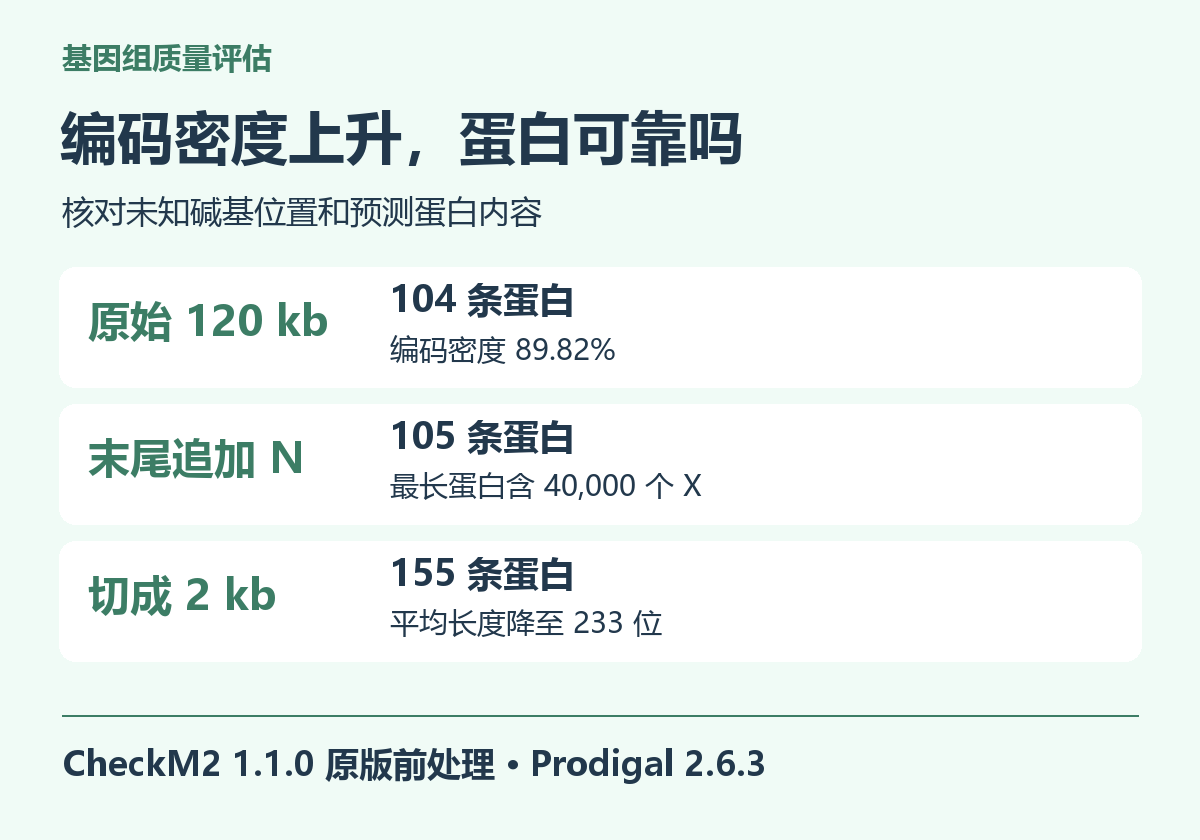
原始区间产生一百零四条预测蛋白,编码密度约为百分之八十九点八二。转为小写以后,蛋白数量、长度统计和编码密度完全相同,排序后的蛋白序列集合校验值也相同。这说明在本次版本与输入上,大小写变化没有改变预测蛋白内容。
| 输入条件 | 总碱基数 | 明确碱基数 | 预测蛋白数 | 编码密度 | N50 |
|---|---|---|---|---|---|
| 原始区间 | 120,000 | 120,000 | 104 | 89.8208% | 120,000 |
| 转成小写 | 120,000 | 120,000 | 104 | 89.8208% | 120,000 |
| 末尾追加 N | 240,000 | 120,000 | 105 | 94.8854% | 240,000 |
| 中间插入 N | 240,000 | 120,000 | 152 | 47.5658% | 240,000 |
| 切成 2 kb 片段 | 120,000 | 120,000 | 155 | 90.1692% | 2,000 |
| 强制第四号翻译表 | 120,000 | 120,000 | 102 | 90.0258% | 120,000 |
这张表中最值得继续检查的是追加未知符号的一组。它拥有更大的长度、更高的连续性指标,编码密度甚至上升了五个多百分点。仅凭这些数字,很容易产生输入改善了的印象。明确碱基数量仍为十二万,提示我们需要检查新增加的预测区域到底是什么。
追到蛋白文件,找到四万个未知氨基酸
打开末尾追加未知碱基那一组的蛋白结果,可以找到一条长达四万零二百四十位的预测蛋白,其中四万位是未知氨基酸符号。对应预测区间延伸到了输入末端,把追加区域纳入了这条预测记录。
原始组最长蛋白为一千零七十四位,蛋白中没有未知氨基酸。这个对照让异常变得具体。编码密度提高的同时,出现了一条由大量未知残基构成的极长蛋白。进入后续分析之前,应结合这条记录及其来源,重新判断密度数值所反映的具体内容。
我们把同样数量的未知碱基移到序列中间后,编码密度降到约百分之四十七点五七,最长蛋白回到一千零七十四位,预测蛋白中没有未知氨基酸。这两组拥有相同的总长度和明确碱基数,却产生明显不同的前处理结果。因此,未知区域的位置、周边序列和基因预测行为,都值得在异常样本中逐项核对。
这个实验记录的是指定版本和受控序列的实际输出。判断自己的样本是否受到类似影响,最直接的办法是统计预测蛋白中的未知残基、异常长度及对应核苷酸区域,再用本地版本重跑小型对照。完整度或污染度最终改变多少,还需要实际完成相应模型预测后才能回答。
怎样把蛋白检查加入自己的分析
可以先计算每条蛋白的长度、未知残基数和未知残基比例,再把极端值按长度或比例排序查看。这里的阈值应根据数据类型和研究对象确定。对教学例子而言,一条四万多位、几乎全部由未知残基组成的记录,已经足以定位到需要检查的输入区域。
from Bio import SeqIO

for record in SeqIO.parse("predicted.faa", "fasta"):
    protein = str(record.seq)
    unknown = protein.count("X")
    fraction = unknown / len(protein) if protein else 0
    if unknown:
        print(record.id, len(protein), unknown, fraction, sep="\t")
同时保留预测蛋白的原始标识,有助于回到相应片段和基因预测坐标。若整理时先把标识替换为连续编号,却没有保存对应表,后面就难以定位异常蛋白来自哪条输入序列。可以将原始片段标识、蛋白标识、坐标、长度和未知残基统计合并为一张检查表。
还可以从核苷酸输入端统计未知碱基比例、最长连续未知区间及其位置。位于片段中间和位于两端的未知区间可以分别记录。这样一来,蛋白端出现异常时,就能够迅速与输入端的具体区域对应起来。
对于真实组装中的未知区域,后续处理应保留坐标变换记录。修剪两端未知序列、拆开跨越长缺口的片段或重新评估组装结构,都可能改变下游基因编号和参考坐标。完成处理后,重新运行依赖这些坐标的步骤,并保存处理前后的片段映射。
片段变多,为什么预测蛋白也变多
第五组把原始区间切成六十条短片段,所有明确碱基都保留。预测蛋白从一百零四条增加到一百五十五条,平均蛋白长度从约三百四十六位降到约二百三十三位,最长蛋白也变短了。
这种变化需要结合新增边界理解。一个原本完整的编码区域被切开之后,可能在不同片段上形成多条部分预测,起止位置也可能调整。新增记录数量只能说明预测条目发生变化,功能种类是否增加,还需要继续检查序列对应关系和功能匹配。
如果要定量分析切分造成了多少基因断裂,可以把短片段坐标换算回原始区间,再与原始预测进行重叠比较。随后将变化分成原基因被拆开、边界位置调整、预测出现或消失等情况。本文记录了整体数量和长度变化,读者可以沿着保留的片段顺序继续完成这种逐基因比较。
实际分箱项目里,不同样本的组装碎片化程度往往不同。直接比较预测蛋白条数时,应同时检查总组装长度、片段长度分布、部分基因比例及重复序列。把这些因素放在同一张样本概览表中,更容易解释某个样本为什么突然产生很多短蛋白。
翻译表选择要有生物学依据
原版前处理在自动模式下比较相应翻译表的编码密度,并按实现中的条件选择结果。本次原始区间最终使用第十一号翻译表。强制第四号翻译表后,预测蛋白数变成一百零二条,蛋白序列集合也发生变化。
这一对照说明,翻译表会影响实际预测内容。对来源明确的基因组,应结合研究对象的遗传密码信息选择合适设置。对于来源不确定的组装,可以把自动选择记录作为需要复查的线索,再结合分类和基因结构证据判断。仅为了让某个汇总指标变高而改动翻译表,会让结果难以解释。
需要注意,本文的强制选择通过原版方法的参数进行,用于展示底层阶段如何响应输入。读者复现时应使用附带脚本,并检查自己调用的程序入口支持哪些参数。不同接口暴露的设置范围可能不同,底层方法参数和主命令行选项需要分别核对。
本次六组输入的 GC 比例约为百分之五十二点五三,结果全部相同。这一统计按明确的四种碱基计算,追加未知符号以后,明确碱基组成保持一致,因此比例本身也基本不受影响。只检查这个比例,就无法发现有一半输入已经变成未知碱基。将总长度、明确碱基长度和未知比例一起展示,能够补上这个缺口。
同样,N50 需要与序列内容结合解释。其常见计算方式是把片段按长度由长到短累加,到累计长度达到总长度一半时,记录相应片段长度。对只有一条片段的输入,追加未知符号也会直接提高这一数值。检查组装时,把含缺口的连续性与明确碱基覆盖情况一起记录,才能知道增加的长度提供了多少可用信息。
从单项指标走到可复查的质量评估
这次实验提供了几种可以复用的检查思路。首先,把输入明确碱基数和未知碱基数分开统计。其次,比较蛋白条数时,同时检查长度分布和未知残基。再次,保留实际选择的翻译表和软件版本,异常时回到同一输入做小规模复现。
编码密度本身也需要明确统计口径。本文数值由原版前处理按预测编码区覆盖和输入总长度计算,未知碱基位置及预测区间会影响这个比值。报告时最好同时保存分子对应的编码区域覆盖数和分母对应的总碱基数,后续就能重新检查变化来自哪里。
完整度、污染度、连续性和基因预测特征各自回答不同问题。在正式质量筛选中,可以先依据研究要求确定过滤条件,再检查处于边界附近或指标互相矛盾的样本。对这类样本,查看序列、蛋白和覆盖信息能够补充汇总表中没有呈现的细节。
本次脚本还保存了源码模块校验值、外部可执行文件校验值、输入校验值和蛋白集合校验值。升级环境后重跑同一微型对照,可以判断变化发生在文件内容、依赖版本还是具体预测结果。这样的记录能够让一次异常排查成为后续批次可继续使用的检查方法。下载实跑脚本与本次结果
如果需要把多批基因组的环境、数据库和中间结果统一管理,并保留可复查的分析记录,可了解云生信的生物信息学分析计算服务。


