
两张密度图的傅里叶壳相关很高,通常会让人对结果更有信心。但相关性回答的是两个输入在某个频率范围内有多相似,并不会自动辨别共同部分究竟是真实信号还是重复噪声。如果两个输入缺少必要的独立性,一条漂亮曲线也可能支持不了预期结论。
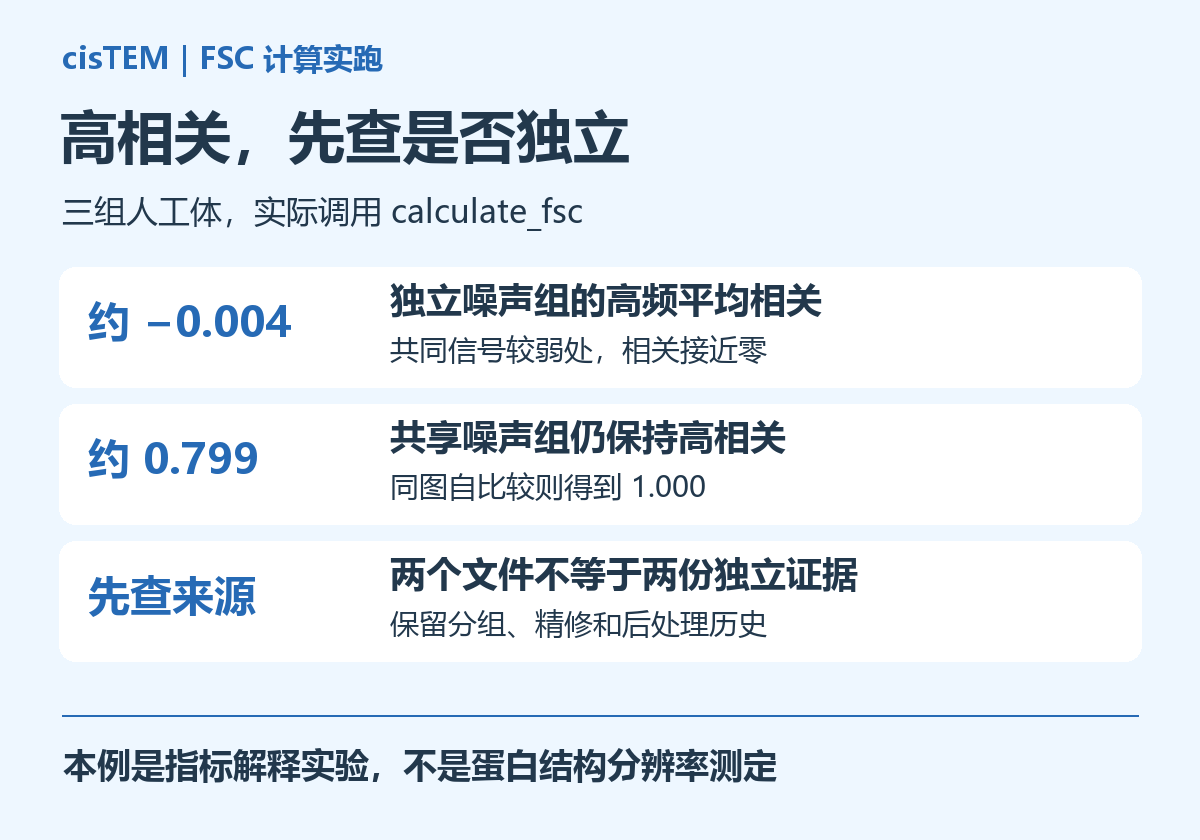
这次我们安装 cisTEM 的官方预编译程序,实际调用其中的 calculate_fsc,比较独立噪声、共享部分噪声和同图自比较三种情况。三组都能正常生成统计表,高频相关却分别接近零、零点八和一。下面把输入构造、实际命令和读表方法连起来,说明为什么计算完成之后,还要核查两张图是怎样产生的。
本文实跑的范围是什么
cisTEM 将单颗粒图像处理中的多项步骤组织在同一体系内,包括运动处理、成像参数估计、颗粒处理、分类与三维精修。整体使用方式可从官方文档了解。本文只运行它提供的相关性计算程序,不创建图形界面项目,也没有完成从真实电影帧到三维结构的全流程。
这个范围需要写清楚,因为拿到两个体文件并计算相关,并不意味着它们已通过前面的所有验证。数据可能来自其他处理链,也可能只是人工数组。相关性程序能够检查一部分输入要求并计算数值,但不会替使用者证明颗粒分组、重建或精修过程符合独立性要求。
本次输入全部由作者生成,没有实验样品、原子模型和真实显微镜噪声。我们故意使用可以控制相关结构的随机数组,让一个错误条件产生清晰结果。它是一项关于指标解释的计算实验,不是蛋白结构分辨率测定,也不是某篇论文的数据复现。
固定程序来源,核对实际交互格式
本次从官方发布页获取 Linux 预编译包,包名为一点零测试版。程序日志自报 CalculateFSC 一点零零,编译日期为二零一七年十二月二日。这些信息与压缩包摘要一起记录,不把下载日期当作软件编译日期,也不把源码仓库当前分支等同于下载包。
运行平台是 Ubuntu 22.04.5。生成与读取体文件使用 Python 3.10.22、NumPy 2.2.6 和 mrcfile 1.5.4,实际调用为 CPU 路径。这个小任务运行很快,但我们不把它当作整套图像处理的速度基准,尤其不能用一次相关计算外推大规模三维精修耗时。
tar -xzf cistem-1.0.0-beta-intel-linux.tar.gz
export PATH="$PWD/cistem-1.0.0-beta:$PATH"
python run.py work260
一个实际遇到的小问题是,这个程序不接受常见的长帮助选项。它提供的是依次回答问题的命令行交互,重定向输入时会进入脚本模式。因此,复现时不能只保存可执行文件名,还要保留每个回答的顺序与含义。别的版本如果改变问题顺序,应重新核对日志,不能盲目沿用旧输入文件。
怎样构造可检查的共享噪声
我们先生成一个六十四立方的随机体,在傅里叶域做平滑,再归一化为标准差约一的信号。这里称它为信号,只表示它是三组对照共同使用的受控部分,并不赋予它任何生物学含义。随后独立生成两份标准正态噪声,使用固定随机种子保留可复核性。
第一张输入由信号加第一份噪声组成。独立组的第二张图使用相同信号加第二份噪声。共享组则在第二张图中加入零点八倍第一份噪声和零点六倍第二份噪声。最后一组直接把第一张图同时作为两个输入,用来展示完全重复时会发生什么。
half_a = signal + noise_a
half_b = signal + noise_b
shared_b = signal + 0.8 * noise_a + 0.6 * noise_b
零点八与零点六的平方和为一,所以在独立、方差为一的噪声假设下,共享组第二张图的噪声方差仍为一。改变的重点是两张图之间的噪声相关,而不是简单把一张图变得更干净。这个设计有助于把“噪声更少”和“噪声更相似”两个概念区分开。
每张体图都写成浮点 MRC,像素尺寸设为二埃。信号的频率滤波尺度、随机种子、文件摘要和生成代码都保留在附件中。由于使用随机数实现和浮点运算,不同环境可能出现很小数值差异,但三组相关关系应当能够复核,不能只凭文件名相同就判断输入相同。
三组程序调用保持相同处理条件
三组均使用零内半径、四十五埃外半径的球形处理设置,输入的像素尺寸为二埃。程序还询问分子质量,本例填一百千道尔顿以完成参数输入,但它并不代表随机体具有真实分子量。下文只比较统计表中的原始相关列,不把涉及质量假设的其他派生列当作生物学结果。
虽然交互过程要求填写一个三维掩膜文件名,我们将使用三维掩膜选项设为否。脚本提供的全一掩膜文件只是使输入顺序完整,并没有把它作为实际掩膜使用。这一点在日志里可以核对,避免读者看到文件存在,就推断它一定参与了运算。
calculate_fsc <<'EOF'
half_a.mrc
half_b.mrc
mask.mrc
independent.txt
2
0
45
100
No
EOF
其他两组仅替换第二张图和输出统计文件。三次程序都正常返回,每个表有三十二个频率壳记录。读者复现时应同时检查返回状态、日志中回显的输入和输出行数,不能只见到一个文本文件就认定全部步骤按照预期执行。
高频部分实际出现了什么差异
我们选择每像素四分之一到二分之一周期的范围,直接对该范围的相关数值求算术平均。对于二埃像素,它对应八埃到四埃的长度尺度。这里的平均只是本次对照的摘要指标,不是软件定义的实验分辨率,也没有按壳内系数数量做加权。
| 输入关系 | 八埃 / 四埃位置相关 | 高频段平均(约) |
|---|---|---|
| 独立噪声 | 0.02801 −0.00295 |
−0.00391 |
| 共享部分噪声 | 0.81578 0.79327 |
0.79939 |
| 同一张图与自身比较 | 1.00000 1.00000 |
1.00000 |
独立组在这个范围接近零,而共享组仍然维持很高相关。根据我们已知的生成方式,可以把这一差异解释为共同噪声的影响。这个解释依赖受控输入,并不意味着拿到任意真实曲线都能据此反推出多少比例的噪声被共享。
同图自比较尤其有教育意义。文件存在、维度一致、程序成功、曲线完美,这四件事都成立,但没有产生第二份独立证据。一个流程如果把同一个文件复制成两个名称再进行比较,甚至可能在常规文件存在性检查中毫无异常。因此,来源审计不能只看名称或路径是否不同。
曲线相似度不等于结构正确性
相关性度量的是共同变化,能够同时响应共同信号和共同误差。两张图使用了重叠颗粒、共享了某些高频信息,或者在处理过程中引入相关噪声时,都需要检查这种依赖对解释的影响。本文只通过直接构造共享噪声展示机制,没有模拟所有真实泄漏路径。
关于独立数据处理与过拟合的关系,可参考防止冷冻电镜结构过拟合的原始研究。实际项目中的独立性应沿处理历史核查,不能在最后才把一张已经共同精修的结果拆成两份,再认为补做相关曲线就完成了同样的验证。
即使两份输入在所讨论的层面保持独立,高相关也不单独证明手性、构象解释或低分辨率初始模型完全正确。不同验证问题需要不同证据。把一个指标扩展成所有结构性质的总证明,会让流程中未被检验的假设悄悄变成结论。
阈值交点要怎样读,哪些说法不能用
独立组第一个低于零点一四三的采样壳,位于约九点一四埃,对应相关值约零点一二六。这里说的是离散表中第一个满足条件的位置,没有在相邻频率之间插值。不同交点定义、插值方式或非单调曲线处理规则,都可能改变最终报告的数字。
共享组和同图组在本次采样范围内没有低于这个阈值的记录。正确表述是“在当前范围内没有交点”,而不是“获得无限分辨率”,更不是“达到了原子分辨率”。频率范围受到采样网格限制,缺少交点本身也可能是在提醒读者检查输入独立性。
零点一四三不是一个可以脱离计算条件的万能开关。不同相关对象、掩膜处理和评价目的需要相应定义。本文没有用人工体来校准阈值,也没有证明某个阈值比另一个更适合实验数据,只演示同一读表规则在不同输入关系下会给出怎样的结果。
掩膜能改变曲线,不能靠挑最高曲线解决
掩膜决定参与比较的空间范围,也可能影响频率之间的联系。真实项目为了聚焦目标区域而设置掩膜,通常有合理目的,但这不意味着越紧越好。若不断尝试掩膜并只保留让数字最好看的结果,就会把评价过程本身变成选择偏差的来源。
关于掩膜影响与高分辨率噪声替换,可参考相应方法研究。本文没有运行噪声替换校正,也没有比较不同掩膜策略,因此不把这次球形设置称为经过验证的最佳选择。需要使用相关校正时,应执行相应方法并保留其参数和输出。
实用的做法是记录掩膜的来源、尺寸、边缘处理和适用区域,同时保存未经过该处理的输入。比较不同方案时,清楚说明改变了什么,避免同时改变数据、像素尺寸和掩膜后只报告一个更好的数字。读者需要知道数字为什么变化,而不只是看到它变化了。
从文件核验走到来源核验
开始计算前,可以核对两张体图的维度、像素尺寸、轴顺序、数值范围和非有限值。随后再核对它们来自哪些颗粒、哪些精修任务和哪些后处理步骤。前一类检查帮助发现文件与几何问题,后一类检查才有机会发现两个合法文件之间不应存在的依赖。
文件摘要也有作用。如果原本期望两个不同输入,摘要却完全相同,就应检查是否复制错文件。但摘要不同并不能证明数据独立,因为改变头信息、重新保存或少量修改就能产生新摘要。它适合追踪文件身份,不适合替代实验或计算设计中的独立性判断。
得到统计表后,要按列名读取相关列,别把相邻的粒子相关或信噪比派生列当成同一种指标。本次输出的列名和数值位置都在脚本中核对,摘要仅使用原始相关列。若版本变更导致表结构变化,应更新解析方式,并重新验证,而不是默默沿用一个固定列号。
这次实跑留下的经验
cisTEM 的优势是既提供较完整的处理工作流,也保留可独立调用的程序,便于对某个环节做受控检查。使用难点则在于,输出统计必须与输入历史和参数定义一起解释。成功运行能够证明程序完成了指定计算,却不能自动证明这项计算回答了正确的科学问题。
此次最直接的经验是,先定义需要独立的证据,再计算相关性。复现时保留原始输入、回答顺序、程序版本和统计表,报告时说明使用哪一列、哪段频率以及哪种交点规则。这样,曲线既能用于交流,也能在出现争议时回到具体步骤重新检查。
下载脚本、运行说明与实际结果(ZIP)。选择 cisTEM 目录,安装固定版本后运行脚本,将生成三组人工输入并调用相关计算。工作目录须尚不存在,结果只用于本例指标解释。
当输入来源与验证方法已经明确,需要开展更大规模的分类、精修或多组对照时,可以了解云生信生物信息学分析服务器服务,按实际流程安排计算环境。


