
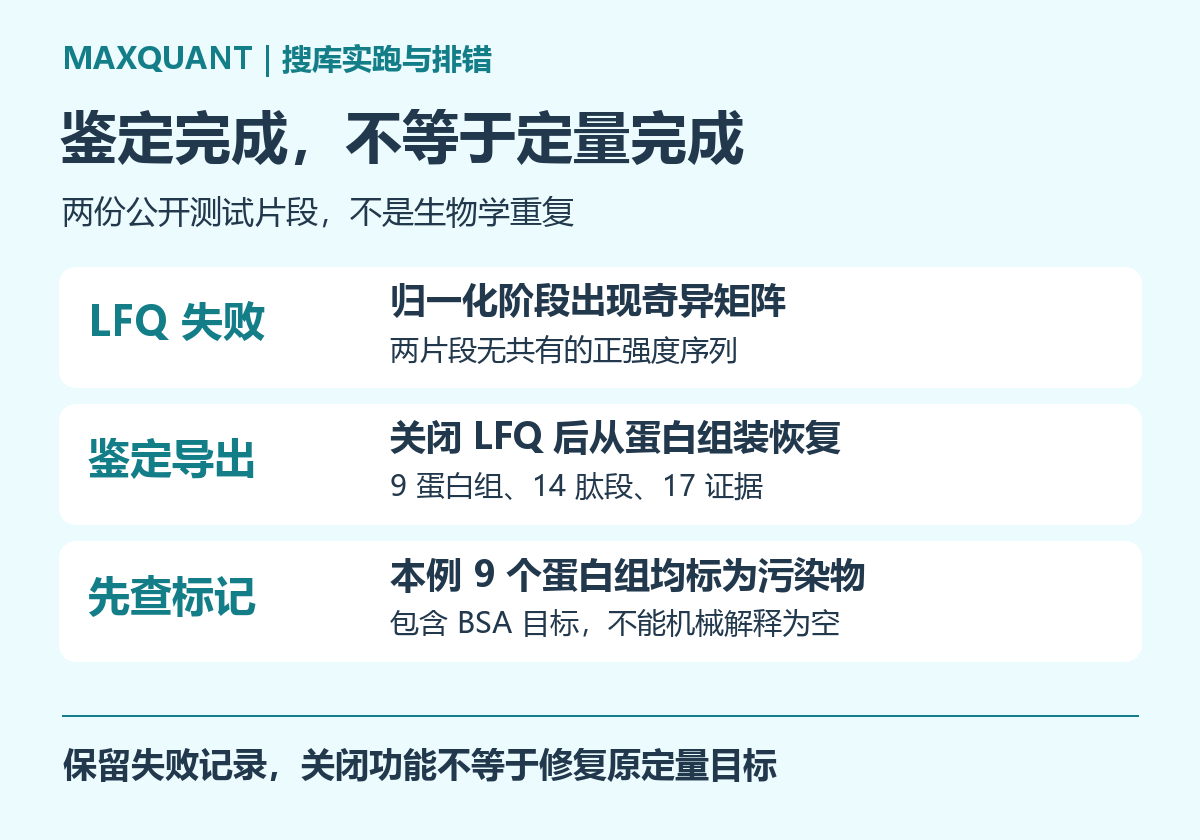
质谱文件能够读取,搜索引擎完成匹配,日志也出现了蛋白组装,是否就能说整个蛋白质组分析成功了?未必。本次安装 MaxQuant 后,真实执行了两个公开小型测试文件的分析。任务完成了前面的搜索步骤,却在跨文件无标记归一化时出现奇异矩阵错误,最终需要把鉴定导出与定量目标分开处理。
这篇文章保留失败过程,而不是只展示一条成功命令。我们会说明怎样建立匹配版本的参数文件、如何确认任务真正进入计算、怎样定位失败阶段,以及为什么关闭 LFQ 后得到结果表,仍不等于获得了可靠的样本间定量。输入是软件测试片段,不是两个生物学重复,也不支持差异蛋白结论。
先确定本次运行的软件版本
本次通过 Bioconda 安装 MaxQuant 2.0.3.0,固定到具体构建,运行于 Ubuntu 22.04.5。它是一个用于复核旧版行为的环境,并非当前最新版。官方现行下载与说明已经更新,读者建立新项目时,应根据当前安装文档选择匹配的软件与运行时,不能把下面的旧版组合直接理解为当前推荐配置。
安装包最初提供了 Mono,程序能够显示版本并生成参数模板,看起来像是已经准备好了。但真正启动分析时,它提示还需要安装另一套运行时。我们随后补齐隔离目录中的 .NET Core 3.1 SDK,以及所需兼容库,才进入实际计算。版本命令通过与完整任务能运行,检查的不是同一件事。
micromamba create -n mq203 --override-channels \
  -c conda-forge -c bioconda \
  maxquant=2.0.3.0=py310hdfd78af_1 python=3.10
本次实际使用 Mono 5.14.0.177、.NET Core SDK 3.1.426 和对应运行时 3.1.32。依赖放在独立目录,通过当前会话的环境变量指定,没有改动系统默认解释器。完整步骤与来源摘要放在附件说明中。旧运行时组合用于本次复核,不是建议新项目长期沿用旧软件。
另一个值得记录的细节是,本版帮助和版本命令打印正确内容时返回非零状态,而创建参数模板返回零。若自动化脚本把所有非零状态都解释成同一种失败,就可能误判帮助命令。反过来,正式计算的非零返回不能因为帮助命令有这种行为就被忽略,必须结合具体操作和日志判断。
小型测试文件不等于一个小型生物学实验
我们从 Galaxy 蛋白质组工具仓库获取两个固定提交下的 BSA 测试文件和配套序列库。两个文件均有一百条扫描记录,其中第一个包含十八条一级扫描和八十二条二级扫描,第二个包含十九条一级扫描和八十一条二级扫描。这些数量由输入文件实际解析得到。
文件名中的分钟片段不能被解释为独立样本。它们适合检验文件读写、参数传递和搜索链是否能运行,但没有提供完整的实验设计。读者可以从固定提交的测试目录取得相同输入,核对文件摘要后再开始复现。
| 输入文件 | 一级扫描 | 二级扫描 | 在本文中的用途 |
|---|---|---|---|
| BSA_min_21.mzXML | 18 | 82 | 公开软件测试片段 |
| BSA_min_23.mzXML | 19 | 81 | 另一公开测试片段 |
配套序列库只有一个 BSA 条目,同时本次开启了工具自带的污染物搜索设置。这样的小库与片段组合不能代表真实全蛋白组搜索空间。即使设置了常见错误控制阈值,也不能凭这个练习证明真实项目中的错误发现率得到同样校准,更不能用输出蛋白数量评价算法优劣。
让当前程序生成参数模板
我们没有拿其他版本的参数文件直接硬套,而是调用已安装程序生成模板,再修改输入路径、实验标签和必要选项。这样可以保留当前版本预期的基本结构,但并不意味着模板中的默认值自动适合任何实验。酶切、固定修饰、可变修饰和仪器参数仍需要核对。
maxquant --create mqpar.xml
maxquant --dryrun mqpar.xml
maxquant mqpar.xml
第一条生成模板,第二条列出阶段,第三条才实际执行。列出任务计划不读取全部数据并完成鉴定,因此不能把预览成功称为搜库成功。我们保存了三个操作的不同日志,实际结果由搜索、恢复和输出表共同证明,而不是只凭参数文件存在。
本例把线程数设为二,关闭跨运行匹配,保留污染物设置,并首先开启 LFQ。两个文件分别使用便于辨认的片段标签,参数组都指向同一组设置。标签只是定位来源,不能因为它们填在实验字段里,就把原本没有生物学独立性的文件变成实验重复。
修改参数时要注意几个并列数组,文件路径、实验标签、分级信息和参数组索引需要逐项对应。只新增文件路径却没有同步其他列表,可能让后续行为与预期不一致。建议把样品说明表作为唯一来源,统一生成这些字段,再抽查每个文件对应的标签。
数据库标识规则会影响后续解释
本例的序列标题以一个简短 BSA 标识开头,后面还有蛋白说明和数据库编号。我们明确设置标识解析规则,提取标题中第一个非空白字段,同时保留完整说明。读者如果希望使用另一种编号,应先检查实际标题格式,再设计规则,而不是看到某个数据库名称就默认所有文件一致。
错误解析可能造成不同条目合并为同一标识,也可能把整段描述都当作编号。这样的文件有时仍能被程序读取,却给后面的注释与结果连接留下问题。因此,正式搜索前应抽查若干解析后的标识,并检查是否重复、是否为空、是否与后续注释表一致。
污染物条目也属于搜索空间的一部分。它们不是运行失败的标志,而是帮助解释可能来自样品准备或环境的信号。对于以某种标准蛋白为测试对象的练习,目标蛋白与污染物库的关系尤其需要核对,不能先按统一规则删完再疑惑为什么标准品不见了。
真正失败的是哪个阶段
补齐运行时后,日志依次进入特征检测、去同位素、首次搜索、质量重校准、主搜索、第二肽段相关处理和蛋白组装。随后在无标记归一化阶段报错,信息包含奇异矩阵。这表明任务并不是一开始就无法读取输入,也不是还没有执行搜索。
这种定位能缩小排查范围,但不能仅凭一行报错就把原因归为某个唯一因素。矩阵奇异说明当前求解条件没有提供足够独立约束,具体项目还要检查共同肽段、有效数量、文件间联系以及设置。本例使用极短测试片段,不能预设它们具有稳定跨文件定量所需的信息。
无标记蛋白定量需要利用可比较的肽段信息并处理归一化问题。相关方法背景可查MaxLFQ 原始研究。这里引用方法是为了理解依赖条件,不是声称本文复现了该研究,也没有用两份短片段来检验论文报告的定量表现。
排查时应先保存完整日志和原参数,再记录最后完成的阶段与首个错误。不要只复制最后几行线程栈,也不要把前面已经完成的工作全部描述成失败。最后几行往往只是错误传播结果,真正的原因通常出现在更早的具体任务信息里。
关闭 LFQ 后继续,改变的是分析范围
我们先保存失败现场和原参数,再把 LFQ 模式关闭。为利用已经完成的搜索结果,重新查看当前任务列表,从蛋白组装准备阶段继续,而不是重新读取全部输入并从头搜索。本版列表中对应阶段编号为三十七,其他版本应重新查询,不应把这个数字当作通用常量。
# 修改参数并确认阶段列表后执行
maxquant --dryrun mqpar.xml
maxquant --partial-processing=37 mqpar.xml
这种恢复方式只适用于已经确认前面的输入和搜索参数没有改变的情况。若更换序列库、酶切规则、修饰或原始文件,就不能继续复用与旧设置对应的搜索中间结果。需要重新计算哪些阶段,应根据参数影响范围判断,不能为了节省时间从任意位置接上。
关闭 LFQ 后,本次目的变为导出鉴定与已有强度信息。它没有修复跨文件定量的证据基础,也没有证明原来的归一化错误可以忽略。如果研究目标必须是可靠的样本间比较,就应回到完整数据和实验设计,重新建立适合的分析,而不是把少一项输出当作已经完成原目标。
结果表需要按各自层级阅读
恢复执行正常返回后,本次得到九行蛋白组、十四行肽段、十七行证据和十九行谱图匹配记录。摘要中的扫描数量与输入解析一致,输出没有 LFQ 强度列。我们据此确认鉴定表已经导出,同时保留最初的定量失败状态,不把两次操作合并描述成一次无错误的完整运行。
| 实际核验项 | 本次结果 | 可以支持的判断 |
|---|---|---|
| 蛋白组与肽段表 | 9 行与 14 行 | 已产生对应层级输出 |
| 证据与谱图匹配表 | 17 行与 19 行 | 两者不是同一种行单位 |
| 污染物标记 | 9 个蛋白组均为加号 | 统一删去污染物会清空本例蛋白表 |
| 两片段共有正强度序列 | 0 条 | 缺少可直接对应的正强度肽段联系 |
| LFQ 强度列 | 不存在 | 不把恢复结果称为完成 LFQ |
其中包含 BSA 的组同时列出了目标序列标识和污染物条目,也被标为潜在污染物。若按常见的反向、污染物和仅位点鉴定标记统一过滤,本例最后会剩零个蛋白组。这不是读取了一个空文件,而是过滤规则与测试对象之间的关系,需要结合标准品或目标蛋白用途判断,不能据此宣布样品没有蛋白。
两份片段分别有四条和三条正强度序列,交集为空,这与跨文件归一化缺少联系的解释相符。不过,作者的序列交集检查没有重建 MaxLFQ 内部矩阵,不能冒充对所有内部求解步骤的完整诊断。尤其不能把本例的处理方案推广为所有奇异矩阵报错的固定修复办法。
MaxQuant 会产生多种结果表,它们的行数通常不相同。蛋白组表汇总上层对象,肽段表、证据表和二级谱图匹配表则反映不同层级的信息。字段含义可查官方输出表说明,不要把不同表中的行数简单解释为相互矛盾。
同一肽段可能在不同运行或特征中出现,多条谱图也可能支持同一肽段。一个蛋白组可能包含无法凭当前证据区分的多个序列条目,因此不能把用分隔符连接的标识逐个拆开后,都当成独立鉴定蛋白。先明确对象层级,再计算数量,才能避免重复累计。
对每次运行的概况,可以先看摘要中的一级与二级扫描数量、提交搜索的谱图和鉴定情况,再回到具体证据定位异常。总行不是一个额外样本,若把摘要最后的合计行一起加入比较,会再次把总体统计当作观测值。读表脚本应显式区分它们。
强度、谱图计数与 LFQ 强度也不是同义词。本次恢复时关闭了 LFQ,因此不把原始或汇总强度包装为已经归一化的样本间丰度。即使某列存在数值,也要知道它如何计算、是否经过归一化以及对应哪个层级,才能决定下一步能做什么。
从这次过程建立自己的验收标准
一次任务至少要区分环境可启动、输入可读取、搜索已完成、结果已导出和目标分析已完成几个状态。它们可以依次推进,也可能在中途停止。报告进度时把状态写清楚,才能避免一方说“跑完了”,另一方却发现所需定量根本没有得到。
对于真正的定量项目,应在运行前检查样品与文件的对应关系,并选择有代表性的小批数据验证完整流程。这里的小批应保留真实分析所需的联系,而不只是把文件裁到最小。测试文件适合验证程序接口,完整采集中的代表性样本才更适合验证统计流程能否工作。
当文件很大时,也不要只追求增加线程。先判断卡在哪个阶段、是否受到输入读取或中间文件影响,再做有记录的调整。本文没有比较不同硬件或线程数,所以不提供速度倍数。保存实际版本与阶段日志,比凭一次总耗时推断所有任务的计算需求更可靠。
MaxQuant 的优势是把多步搜索与定量组织在一个流程中,输出之间也保留了可追溯联系。使用难点是环境依赖、样品设计、数据库和统计设置都会影响结果。此次实跑最有价值的经验,是先定位失败层级,再明确恢复后的分析范围,而不是用一个成功退出覆盖原先没有完成的科学目标。
下载脚本、运行说明与实际结果(ZIP)。选择 MaxQuant 目录,按说明准备旧版及隔离依赖,再运行脚本下载并核对公开输入。它保留本例 LFQ 失败并恢复鉴定导出,工作目录须尚不存在,不把恢复结果当作已完成定量。
当原始文件、样品设计和需要交付的结果已经明确,需要部署批量质谱处理环境时,可以了解云生信生物信息学分析服务器服务,按软件版本和实际任务安排计算资源。


