
运行 ClonalFrameML 后,很多人会先看重组区域和树,却忽略两个容易改变结论的细节。一个是重建序列文件通常使用压缩的位点模式表示,不能直接按基因组坐标切片。另一个是参数表中的重组相对速率,与重组相对于突变引入多少替换,并不是同一个量。
本篇实际安装 ClonalFrameML 1.20,先执行作者提供的安装示例,再用八条五万列的设计序列完成三组对照。我们核对默认输出、不变位点重建和缺失碱基填补,最后从实际参数表计算一个代入估计。重点是帮助读者正确使用输出文件,避免把模型推断误当作新的观测证据。
输入树与序列必须描述同一组对象
ClonalFrameML 的基本输入是一棵起始树和一份序列比对。树叶名称要与 FASTA 标题对应,不能一边使用菌株简称、一边使用测序批次编号。真实项目里,重复名称、遗漏样本和标题被软件截断都可能造成映射问题,因此提交前应检查名称集合及唯一性。官方用户说明
除了名称,序列的位置关系也需要保持清楚。若比对来自参考映射,应保留参考坐标与缺失状态。若来自多个片段拼接,应保存片段顺序、边界和原始坐标映射。没有这些信息,输出区域即使看起来很精确,也难以可靠地回到基因和读段证据上。
起始树同样不是一个可随意替换的装饰文件。模型在给定分析条件下估计重组参数并调整相应分支长度,结果需要放在这棵树的背景中解释。输入树存在明显问题时,不能期待一组漂亮的输出数字自动修复所有系统发育假设。
本次设计了怎样的数据
八条设计序列具有相同的五万列长度。脚本先根据一个预设的分组关系设置两百个背景变异位点,再在 S1 与 S2 共同的一个短区间设置一百八十个替换。起始树包含这八个名称,分支长度明确写入文件,全部运行使用相同树和相同参数条件。
第一组直接使用完整设计数据,执行默认重建设置。第二组保持树和数据不变,只开启不变位点重建。第三组沿用第二组设置,但将 S3 的一基坐标 20001–20100 改为一百个 N,观察程序如何填补缺失。这一段在设计数据中没有变异,因此其他序列为重建提供了十分简单的背景。
这些序列不是按完整的生物进化过程模拟出来的,也不是实际菌株。它们用于检查文件语义和参数计算过程。我们没有据此估计任何真实物种的重组水平,也没有把新增的一百八十个替换直接定义成真实发生的重组事件。
安装完成以后,运行三组明确的对照
本次固定镜像实际返回版本 1.20。先运行官方仓库中的安装测试,确认程序可执行,再开展本文对照。安装测试很小,只能说明基本调用成功,不能替代项目验证,更不能拿它的耗时推算大规模数据的运行时间。
IMAGE=quay.io/biocontainers/clonalframeml:1.20--hc52dbad_0
docker pull "$IMAGE"
docker run --rm "$IMAGE" ClonalFrameML -version

docker run --rm --cpus 2 --memory 4g \
  -u "$(id -u):$(id -g)" -w /work -v "$(pwd):/work" "$IMAGE" \
  ClonalFrameML tree.nwk default.fasta default -kappa 2

docker run --rm --cpus 2 --memory 4g \
  -u "$(id -u):$(id -g)" -w /work -v "$(pwd):/work" "$IMAGE" \
  ClonalFrameML tree.nwk reconstruct_invariant.fasta reconstruct_invariant \
  -kappa 2 -reconstruct_invariant_sites true
这里的替换模型参数设为二,是教学实验的明确设置,不是从真实数据估计得到的最优值。实际研究应根据相应模型和上游分析确定并记录参数来源。本文也没有启动用于评估参数不确定性的模拟重复,因此下面的代入计算不带有经过实测支持的置信区间。
五万列输入为何只剩 55 列
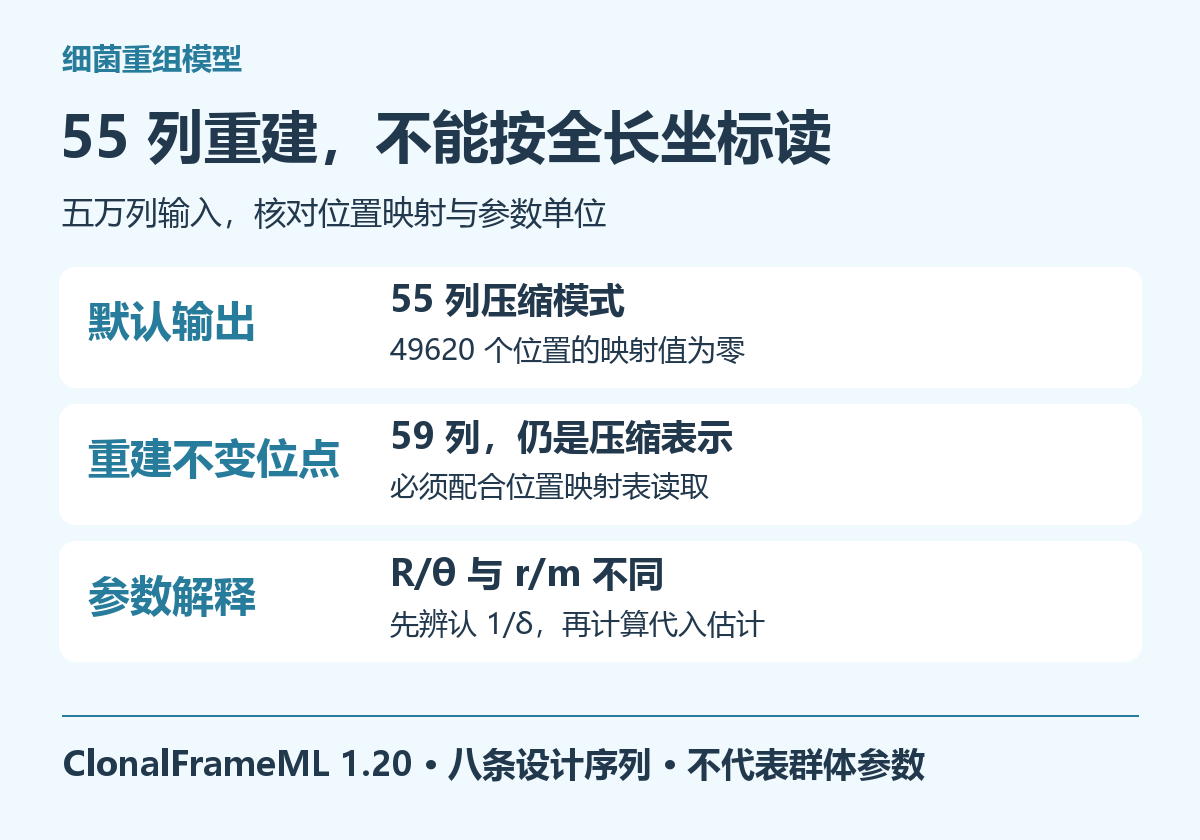
默认运行的重建 FASTA 中,每条序列只有五十五列,文件同时包含八个叶节点和七个内部节点。对应位置映射表却有五万个条目,其中四万九千六百二十个为零。这恰好对应本次没有进入默认重建表示的不变位置。
剩余三百八十个多态位置也不是逐列全部存入重建 FASTA。具有相同模式的位置可以共享一个压缩位置,因此重建文件中的五十五列与输入的三百八十个多态列仍不是一一对应关系。只看输出长度,既不能推断输入只剩五十五个碱基,也不能判断程序错误删除了大部分数据。
| 设置 | 输入列 | 重建列 | 零映射数 | 缺失段恢复 |
|---|---|---|---|---|
| 默认 | 50000 | 55 | 49620 | 此段未重建 |
| 重建不变位点 | 50000 | 59 | 0 | 原有 100 位均对应 |
| S3 遮盖 100 位后重建 | 50000 | 63 | 0 | 100 位与设计真值一致 |
开启不变位点重建后,输出每条序列增加到五十九列,而不是五万列。程序增加了需要表示的不变模式,仍然使用压缩存储。若分析脚本把这个文件当作普通全长比对,按第一万位直接索引,要么越界,要么在其他数据规模下悄悄读取错误位置。
因此,应将重建 FASTA 与位置映射文件视为一套不可分离的结果。只保留前者、丢弃后者,会失去从输入位置定位到重建状态的依据。交付给后续分析人员时,最好在文件清单里直接写明“压缩模式表示,需要配合位置映射读取”。
正确读取映射,并处理零值
对于输入中的某一个一基坐标,先读取映射向量对应的条目。若条目大于零,再将它作为重建 FASTA 中的一基位置读取。若条目为零,则该输入位置在当前重建输出中没有相应状态,不能直接减一后索引。
下面代码展示一个单位置读取方法。零值返回缺失,而不是悄悄使用最后一个碱基。这个细节尤其重要,因为 Python 的负一索引是合法的,会返回序列末尾,程序可能正常结束,却给出完全无关的重建结果。
def reconstructed_base(original_position, mapping, compressed_sequence):
    if not 1 <= original_position <= len(mapping):
        raise ValueError("position outside input alignment")
    mapped = mapping[original_position - 1]
    if mapped == 0:
        return None
    if not 1 <= mapped <= len(compressed_sequence):
        raise ValueError("invalid cross-reference")
    return compressed_sequence[mapped - 1]
读取前还应确认向量长度等于输入比对长度,所有非零映射不超过重建序列长度,并检查目标节点名称确实存在。这些核对直接对应文件间的约束关系,比只判断文件是否存在更有意义。若需要导出全长表示,应显式规定未重建位置如何处理,并保留原始文件。
对于叶节点,可以另外保留原始观测序列。对于祖先节点,不能为了填满全长输出而从某个参考随意补碱基。这样做会把人为填入的内容混进模型结果,随后讨论祖先状态或基因变化时很难再区分证据来源。
缺失的 100 位被填回,并不等于获得了新读段
第三组把 S3 的一百个位点替换为 N 后,重建文件增加到六十三列。通过映射逐位展开,这一百个位置全部与遮盖前的设计真值一致。这个结果来自本次简单对照,其中遮盖段没有多态性,其他序列在这些位置提供一致背景。
不能把这个百分之百直接写成缺失重建准确率。真实数据中的缺失可能集中在重复区域、高差异片段或复杂重组区域,条件与本次完全不同。我们没有对这些场景开展验证,也没有设计独立的评测数据集。
更重要的是,重建状态依然是模型推断,不会变成测序证据。假如原样本某段覆盖不足,填补以后可以用于某些明确接受推断状态的分析,但不应回填到质控报告里,声称这个样本已经测得完整序列。应保留原始缺失掩码,让后续结论能够区分观察到与推断得到的位置。
这一点与变异调用中的参考填补问题相通。数据整理时越是追求一张没有空格的完整矩阵,越需要记录空缺是怎样消失的。缺失被重建、缺失被参考代替以及缺失位置被删除,都会影响解释,却不是同一种处理。
参数表里的倒数不能当成片段长度
本次默认运行的参数表中,R/θ 对应数值为 0.0108106,1/δ 为 0.00067736,ν 为 0.0898737。这一版本表头明确写的是 Posterior Mean 等字段,因此保存结果时应保留原始列名,而不是把所有数字统称为直接测量值。
第二个参数表示长度尺度的倒数。若直接把 0.00067736 写成平均导入片段长度,单位和数量级都会错。将这个报告值取倒数,可得到约 1476.32 个碱基的代入长度尺度。它是基于输出参数作的转换,不是把所有检测区间长度简单求平均。
还要注意一个统计细节。倒数的均值一般不等于均值的倒数。因此本文明确把这一计算称为代入估计,不声称它就是完整后验分布下 δ 的均值。对不确定性有正式要求时,应使用适当的重复结果或分布信息作转换,不能只对摘要表的一行作四则运算后附上新的统计含义。
R/θ 与 r/m 回答的是不同问题
相对速率关注重组事件过程与突变过程的相对程度,而相对效应还要考虑一次导入影响多长片段、其中有多少位置不同。原始方法论文给出的关系为 r/m = (R/θ) × δ × ν。方法论文
把本次报告值代入后,得到约 1.4344。这个值远大于 R/θ 的 0.0108106,并不矛盾,因为单次导入可以影响多个位置。不能看到相对事件速率较低,就直接断言重组对替换的影响可以忽略。
同样,r/m 不是有多少百分比的基因组发生过重组,也不是检测到的区域数量,更不是某个样本存在重组的概率。把它写进项目结论时,要说明比较的是模型中的替换贡献,并交代数据范围和参数估计条件。本次设计数据只用于演示计算关系,不用于赋予某个真实群体这样的比值。
对参数不确定性的处理也要保持这一逻辑。不能把三个参数各自区间的端点随意相乘,就把得到的范围称为 r/m 的正式区间,因为参数之间可能存在相关性。本文未运行相应重复估计,因此只报告代入值,并保留这一限制。
区域边界、模型长度与树节点要分开读
三组运行都报告一个区域,位于 10009–11990,关联节点为 NODE_9。这个候选区间的长度,与前面约一千四百七十六的代入长度尺度不是同一个量。前者是本次推断区间的具体边界,后者是模型参数经转换得到的尺度,不能要求它们逐条相等。
节点名称也需要回到带标签的输出树解释。不能只把 NODE_9 复制到图注,让读者猜测涉及哪些样本。在本次固定树背景中,它对应含 S1、S2 的相关分支。更换树或输入顺序后,应重新核对节点关系,而不是沿用上一次分析的内部编号。
真实项目中,如果研究重点落在某个区间,应进一步核对原始比对、覆盖和注释坐标。输出的边界数字提供了复核入口,却没有自动证明区域内所有差异都来自同一个机制。将候选区域、原始证据和模型条件同时呈现,结论会更容易审核。
本次经验怎样用于已有项目
ClonalFrameML 的优势是同时提供参数、分支和区域层面的输出,便于把总体过程与具体位置联系起来。局限是结果受比对、起始树和模型条件影响,压缩表示还要求下游脚本正确处理坐标。软件名称中有最大似然,并不意味着所有输出都可脱离这些条件解释。
建议检查已有分析时先做三件事。核对重建文件与位置映射是否配套,核对参数表是否把倒数误写成长短,核对补齐的缺失是否仍保留原始掩码。这些检查不需要重新跑整个项目,却能发现直接影响解释的错误。发现问题后再决定是否需要重新估计或补充验证。
下载实跑脚本和三组结果。复现包会生成设计序列及固定树,运行三组条件,并保存参数表、区域表、压缩重建和映射。读者可先复核五十五、五十九、六十三列的变化,再按映射检查遮盖段,最后重新计算代入的长度尺度与相对效应。
在明确比对坐标、树输入与参数解释后,如需开展更大样本集合的批量推断,可了解云生信生物分析与计算服务。


