
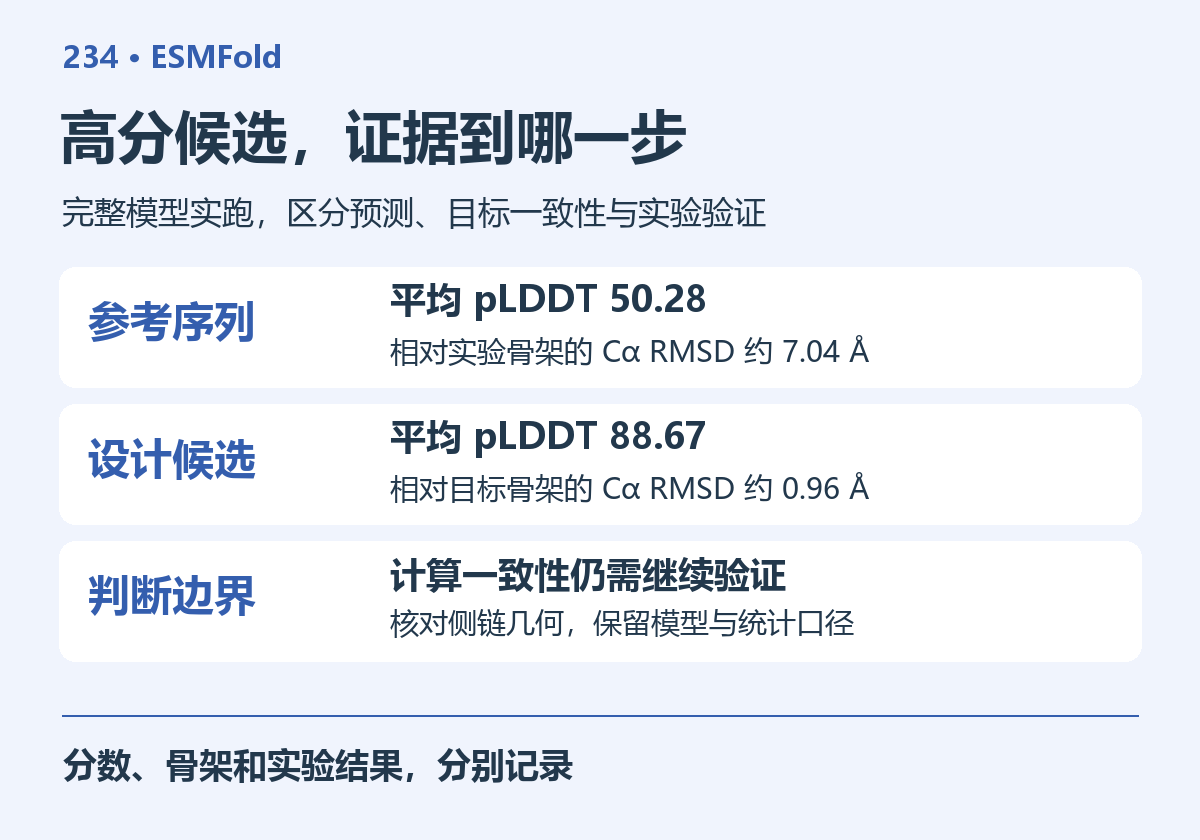
一条设计序列的预测分数比参考序列更高,预测骨架也更接近目标,可以直接宣布设计成功吗?我们把同一骨架的参考序列和一条 ProteinMPNN 候选交给 ESMFold,确实得到了这种结果。候选的平均 pLDDT 约为 88.67,与目标骨架叠合后的 Cα RMSD 约为 0.96 Å,但它仍然没有实验结构、表达或功能验证。
这个例子适合练习三种证据的边界。模型对自己输出的判断是一种证据,预测与目标骨架的一致性是另一种证据,而真实分子是否形成该结构并执行预期功能,需要独立验证。把它们放在同一张候选表中很有用,但不能把它们写成同一个结论。
本文实际安装并加载官方 ESMFold v1 权重,完成三次完整的 CPU 结构推断。输入是公开结构 1CRN 的四十六位参考序列,以及前一篇 ProteinMPNN 实跑中预先选定的第一条固定位置候选。没有运行多序列比对检索,没有重新训练模型,也没有对输出进行能量最小化。
ESMFold 在这条分析链中负责什么
ESMFold 使用蛋白质语言模型表示来支持结构预测,可以直接从单条序列生成结构,不需要为每条查询先建立传统的多序列比对。它的便利在于减少了一部分前处理环节,适合做序列到结构的计算检查。其方法背景见官方项目说明,本文只报告当前小例子的实际表现。
这种便利不意味着任意序列都能被可靠预测。模型需要根据已学到的信息推断结构,遇到某类序列时可能表现较好,遇到另一些序列时则可能给出低置信度或错误构象。序列短、文件格式正确、程序正常退出,都不能单独作为预测质量的保证。
本次参考来自 1CRN 公开条目。候选则来自ProteinMPNN 固定位点实跑,保留了六个半胱氨酸。候选是在运行 ESMFold 之前按该批次第一条记录选定的,本次没有先预测大量序列再只展示最高分的一条,但这仍然只是一个案例,不构成设计成功率评估。
两条序列长度相同,位置可以按顺序对应,便于做骨架比较。对于含插入、删除或不同构建体的真实项目,必须先建立残基映射,不能因为两个文件都有一条 A 链,就直接按原子行号叠合。错误对应也能产生一个数值,只是它回答的已经不是预定问题。
安装经验,能够导入模块不等于权重能够加载
本次使用 fair-esm 2.0.0、Python 3.10.12、PyTorch 2.5.1+cpu 和 NumPy 1.26.4。起初把它与 OpenFold 2.2.0 直接组合,模块可以导入,但完整加载 ESMFold 权重时报错,四个点投影层的参数名称无法匹配。因此,这一次尝试没有完成预测,不能算部署成功。
随后按 ESM 官方说明固定 OpenFold Python 源码到 4b41059694619831a7db195b7e0988fc4ff3a307。旧代码还会导入训练辅助模块,本次补齐了 DLLogger,并把 PyTorch Lightning 固定为兼容其导入方式的 1.9.5。没有通过忽略缺失参数或随机初始化对应层来绕过权重检查。
CPU 构建还有一层区别。本次保留 OpenFold 2.2.0 构建出的 CPU 扩展壳,但实际模型的 Python 代码明确来自上述兼容提交。这个扩展壳不提供 CUDA 计算能力,本次成功推断使用 CPU 路径。安装脚本把这两层分别写清,运行结果也同时记录安装包版本和实际源码校验值,不能只凭一个版本列表推断真正执行了哪份模型代码。
下载安装步骤、推断驱动、三份结构和结果复核脚本。这里提供的是本次验证过的 CPU 组合,不是对所有设备的通用安装承诺。需要其他部署方式时,应参考该版本的包说明及官方依赖要求,重新验证完整权重加载与推断。
# 在新的工作目录解压附件后执行,需要 Python 3.10 和 C++ 编译工具。
bash 234-esmfold/install_cpu.sh
source esm-cpu-env/bin/activate
python 234-esmfold/run.py \
  --openfold-source ./openfold-esm \
  --cache ./esm-cache --pdb ./1CRN.pdb --out ./esm-check
驱动会加载官方权重,使用两条计算线程,把语言模型转换为 CPU 所用的单精度,并将注意力分块大小设为三十二。两份主要权重合计约八点四五吉字节,下载大小与运行内存不是同一个量。本次记录了加载时间和推断时间,但只运行了短序列、未做重复性能测量,因此这些记录不能当成通用速度或容量指标。
先看参考序列,结果没有达到预期
参考序列使用循环参数一时,程序报告的平均 pLDDT 为 50.28,pTM 约为 0.292。我们按四十六个对应 Cα 原子做一次整体刚体叠合,得到与实验结构约 7.04 Å 的 RMSD。这说明本次预测与参考骨架存在明显差异,不能因为它成功生成了结构文件就继续当作可靠模型使用。
把循环参数改为三后,平均 pLDDT 为 48.63,叠合后的 RMSD 约为 7.86 Å,并没有在这次对照中改善。我们保留了这组不理想结果,而不是只展示设计候选的高分。低分参考也提醒我们,不能把一条已知存在实验结构的序列,当成模型必定能预测好的正对照。
这个小例子没有定位预测较差的具体原因。没有进一步实验证据,就不应把问题简单归因于某个残基、蛋白长度或运行设备。当前能够支持的结论是,在记录的版本、输入和参数下,这两次参考序列预测没有很好地恢复所用实验骨架。
| 本次输入与设置 | 平均 pLDDT | 对 1CRN 的 Cα RMSD |
|---|---|---|
| 参考序列,循环参数 1 | 50.28 | 7.04 Å |
| 参考序列,循环参数 3 | 48.63 | 7.86 Å |
| 设计候选,循环参数 1 | 88.67 | 0.96 Å |
表格中前两行与对应序列的实验结构比较,第三行与设计时使用的目标骨架比较。两类 RMSD 的计算方法相同,但证据含义不同。第三行只能说明预测形状接近设计目标,不能称为候选相对实验结构的预测误差,因为我们没有这条候选的实验结构。
同一个结果,为什么有人读到 88.67,有人读到 92.77
候选的程序平均 pLDDT 为 88.67,但只对每个残基的 Cα 值取平均,结果约为 92.77。两者都可以从同一输出得到,差别在于统计对象。当前实现使用有效原子掩码,对输出中的原子级值求平均,不能直接把它当成每个残基等权平均。
我们读取完整置信度数组和原子掩码,重新算出了程序平均值。同时读取写出的 PDB 文件,对其原子记录中的对应列求平均,得到约 88.6741,与程序结果在文件小数精度范围内一致。这样能确认差异来自统计口径,而不是笼统归因于软件显示错误。
不同氨基酸具有不同的原子数量,原子等权与残基等权会赋予不同权重。候选输出含三百四十七条原子记录,参考序列预测输出含三百二十六条。比较不同序列时,应该固定使用的平均方式,同时保留逐位置结果,避免一个总体均值掩盖局部差异。
还要注意文件来源。在本次 ESMFold 输出中,PDB 的温度因子字段承载预测置信度,不能把它按实验晶体结构的温度因子来解释。反过来,原始 1CRN 文件中的同名列也不能直接当作 pLDDT。列的位置相同,不代表物理含义相同,数据说明必须与文件来源一起保存。
循环次数增加,不保证每个目标都单调变好
循环利用前一轮信息,是模型内部的一种计算过程。对于当前安装包,显式传入的循环参数还会加上一次初始前向过程,所以参数一对应两轮,参数三对应四轮。使用默认值又涉及配置中的上限,记录时不能只写“用了几次”,却不说明具体参数和版本。
本次对照只改变参考序列的循环参数,其他运行条件保持一致。结果表明,增加计算轮次没有在这个案例中提高置信度或改善相对实验结构的 RMSD。这不证明增加循环普遍无用,但足以说明它不是一个对所有输入都必然有效的修复按钮。
实际分析时,可以把循环次数作为受控比较的一部分,保存每次结构及指标,观察关键区域是否稳定。若只保留最后一轮或最高分模型,容易失去判断敏感性的材料。也不宜为了把分数推高不断改参数,最后却没有解释为什么选择这一组结果。
候选高分且接近目标,能支持多强的结论
这条 ProteinMPNN 候选的平均 pLDDT 为 88.67,pTM 约为 0.757,非对角 PAE 的中位数约为 1.79 Å。所有 Cα 的 pLDDT 都高于八十五,与目标骨架整体叠合后的 Cα RMSD 约为 0.96 Å。这些指标共同支持它在当前计算流程中表现出较好的结构一致性。
但不能把这几个数字当作相互独立的实验验证。置信度和预测坐标都来自同一个结构模型,候选又是依据目标骨架设计的。它们适合用来决定哪些候选值得继续检查,却不能证明真实样品一定采取同样构象,更不能直接推出表达、稳定性或功能优于参考序列。
尤其不应写成“候选分数比参考高,所以候选在自然界更稳定”。参考序列已有实验结构,本次预测没有恢复好它,说明模型在这一输入上的局限。候选较符合模型预期,与参考分子是否真实稳定,是两个不同问题。把模型分数当作自然界的最终裁判,会忽略已有实验证据。
对于后续筛选,更稳妥的做法是把这一结果记为“通过本次目标骨架一致性检查”,并继续保留其余候选。再根据研究目的检查关键侧链、表面性质或实验可行性,并选择合适的独立验证。本文只测试一条设计序列,不能估计整批候选的通过率。
侧链距离提醒我们,骨架指标不能包办所有几何检查
原始 1CRN 文件标注了三对半胱氨酸连接。我们直接测量对应硫原子之间的距离,实验结构约为 2.00、2.03 和 2.05 Å。设计候选预测中的对应距离约为 2.27、2.17 和 2.22 Å。这是对已有坐标的几何检查,不能仅凭距离就证明溶液中形成了预期化学连接。
参考序列的循环参数三预测更值得警惕,其中第一对硫原子间距只有约 0.84 Å,另外两对约为 3.40 和 6.05 Å。它们明显偏离参考几何,说明除了整体骨架误差,还应检查局部原子关系。此处没有做结构松弛,因此报告的就是模型直接输出的坐标。
即使某个候选的 Cα RMSD 很低,仍然需要检查侧链、原子碰撞和目标位点。骨架叠合只利用了选定原子,无法自动验收其余原子的合理性。局部几何修正也不能替代全局结构判断,不应把一个严重偏离目标的预测经过局部优化后,就视为已经恢复正确折叠。
附件中的坐标复核脚本只需 NumPy,不必重新加载模型。它会检查结构文件校验值,独立重算 Cα 叠合误差,并输出三对硫原子距离。读者可以先复核这些结果,再决定是否完整重跑推断。
pip install numpy
# 复核附件已有结果时,目录中使用附件提供的 expected.json
cp 234-esmfold/expected.json 234-esmfold/实跑结果.json
python 234-esmfold/coordinate_review.py \
  --reference ./1CRN.pdb --results ./234-esmfold
怎样把一次预测变成可用的筛选记录
每个候选至少保存输入序列、模型与依赖版本、参数、结构文件、逐位置置信度和与目标比较的原子集合。对于有实验参考的对象,写清参考来源与残基映射。对于没有实验结构的设计候选,则明确标记目标骨架一致性,避免在汇总表中把它写成实验准确度。
筛选阈值应服务于具体任务,并在看完整批次结果前尽量明确。若某条候选未达到预期,要记录它在哪一项失败,而不是不断更换统计口径直到通过。对于分数接近的候选,查看关键区域和多种条件下的稳定性,往往比比较很小的平均分差异更有意义。
ESMFold 的优势是能够提供直接的序列到结构计算检查,局限是预测质量依赖输入,模型置信度也不能代替实验。本次实跑还说明了依赖固定的重要性,以及多循环、高分和低骨架误差各自的解释范围。把这些边界写进结果记录,才能让下一步验证建立在清楚的证据上。
当这套候选复核流程需要扩展到多批序列时,可以向云生信的生物信息学分析服务器服务提供模型版本、序列长度和批次数量,先确认运行环境与资源配置。


