
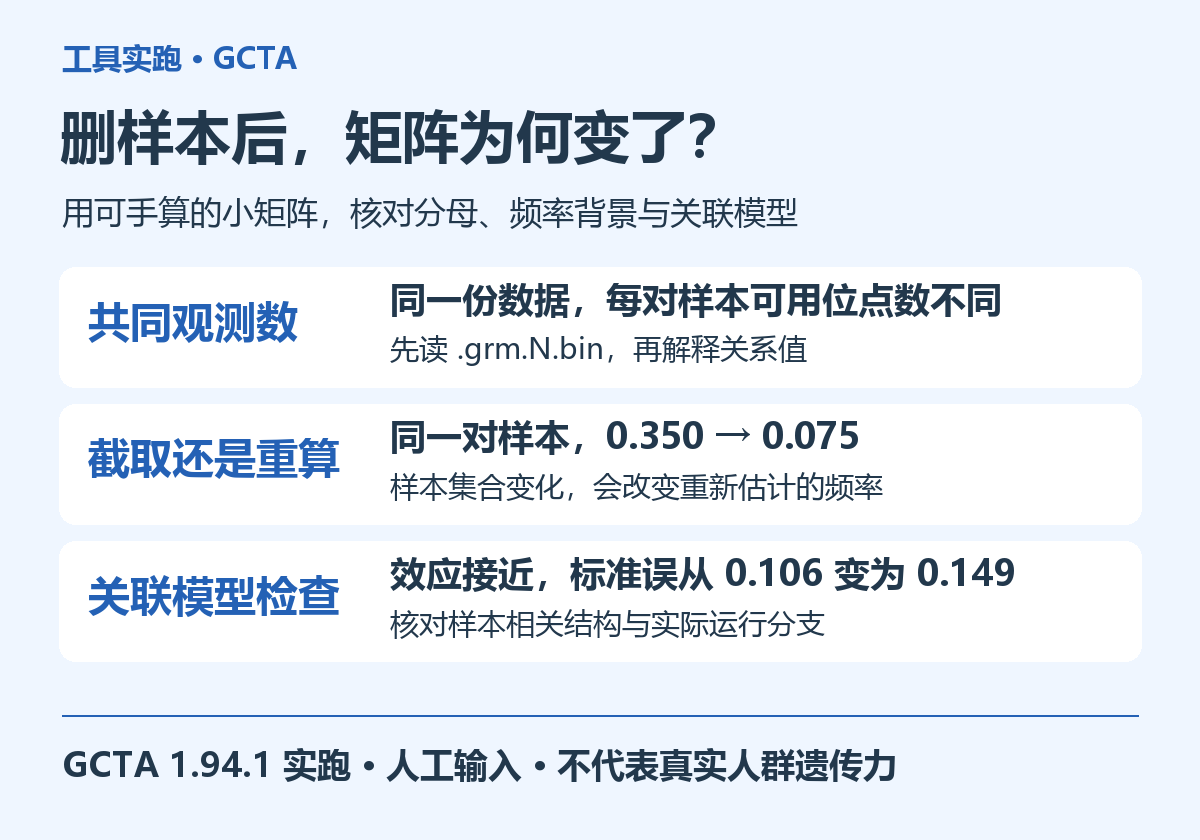
做混合模型分析时,关系矩阵经常被当成一份已经准备好的附件。样本筛掉几个,就把对应行列删掉。更换表型后,再把原矩阵接上。这样做有时符合研究设计,但它与“在新样本集合中重新估计关系”并不是同一个操作。本次实跑中,仅保留前四个样本后,同一对样本的关系值,一个流程得到零点三五,另一个流程得到零点零七五。
本文从这个差异切入,实际运行 GCTA 的矩阵构建、矩阵截取、分块计算和 fastGWA 关联分析。目标是让读者能够检查三个关键问题——矩阵中的数值依据什么样本计算,每对样本实际共同观测了多少个位点,关联分析究竟采用了什么模型。掌握这些问题,比只记住一行运行命令更有用。
一、本次运行范围与复现方法
实测使用 GCTA 1.94.1 的固定容器镜像,运行日期为二〇二六年十一月十七日,环境为 Linux,每次容器限制两个逻辑处理器和四吉字节内存。这里固定的是可追溯的测试版本,不把它称为最新版。工具覆盖的分析范围及当前代码可在官方项目仓库核对,参数含义参照官方文档。
实验分成两层。第一层只有六个样本和四个位点,故意加入两处基因型缺失,用于手算矩阵。第二层包含六百个人工样本和两千个位点,其中三百对样本拥有相同的基因型,以便清楚观察亲缘结构进入模型前后的变化。所有数据由脚本生成,不含真实受试者,也没有疾病风险或真实群体遗传力结论。
下载本组脚本与实测结果,解压后运行下面的命令。脚本生成输入文件、启动软件、读取二进制矩阵,并检查手算值及不同对照的关系。需要能够运行 Linux 容器的 Docker 环境,首次运行会获取固定镜像。
python3 186-gcta/run.py output-gcta
这里设置的资源限制只用于控制教学任务,没有比较不同硬件的速度。真实分析的耗时还受到样本量、位点数、矩阵表示、模型分支和输入读取方式影响,不能从这个很小的例子推算大型队列的完成时间。
二、先把矩阵的三个配套文件放在一起看
运行下面的命令后,输出前缀对应三个文件。关系数值保存在 tiny.grm.bin,每对样本参与计算的位点数保存在 tiny.grm.N.bin,行列对应的家系编号及个体编号保存在 tiny.grm.id。这三者共同描述矩阵,单独复制一个数值文件会丢失解释它所需的信息。
gcta64 --bfile tiny --make-grm --thread-num 2 --out tiny
本例六个样本形成六乘六的对称矩阵,但磁盘里只保存包含对角线的下三角,共二十一个元素。每个元素使用四字节表示,所以两个二进制文件各八十四字节。这个尺寸可以直接检查,若读取成八字节浮点数,得到的元素数量和数值都会错。
另一个常见问题是把编号文件独立排序。二进制文件里没有给每个数值重复写上样本名字,名字依靠行序与数值对应。仅仅把编号改成字母顺序,会把原来的关系值分配给其他样本。正确做法是通过软件或明确的矩阵索引同时调整行列,并保存调整前后的编号映射。
本次脚本按照第一行一个元素、第二行两个元素的顺序读取,再逐项检查共同观测数量。这个核查过程可以迁移到自己的结果上,至少确认编号数量、三角形元素数量、文件大小和对角线位置是否互相一致。格式核查通过之后,才有必要讨论统计含义。
三、缺失会改变每对样本的计算分母
四个位点中,第三个样本在第四个位点缺失,第五个样本在第二个位点缺失。因此,第一与第二个样本可以共同使用四个位点,第一与第三个样本只能使用三个,第三与第五个样本只能使用两个。全数据共有四个位点,并不意味着每一对关系值都以四为分母。
| 样本对 | 共同可用位点数 | 本次关系值 |
|---|---|---|
| 第一与第二个样本 | 4 | 0.350000 |
| 第一与第三个样本 | 3 | −1.444444 |
| 第三与第五个样本 | 2 | 0.714286 |
对于这里检查的非对角线元素,脚本先用全部已观测基因型计算每个位点的等位基因频率,再对两个人都不缺失的位点求标准化乘积的平均。手算与实际输出的差异小于百万分之一,符合四字节浮点存储的精度范围。
每个位点的贡献 =
  (个体一的剂量 − 2p) × (个体二的剂量 − 2p) / [2p(1−p)]

两人关系值 =
  共同观测位点的贡献之和 / 共同观测位点数
不能把这里的负值简单判成程序错误。关系值是相对于估计频率所定义的标准化结果,小样本、少位点和缺失都会让数值波动很大。本例甚至出现绝对值超过一的非对角线元素,它的用途是说明计算过程,不适合拿来制定现实样本的亲缘判定阈值。
同时,不能看到第二个二进制文件里某个元素是四,就认定整份文件都代表四个位点。若输入包含缺失,应该检查全体样本对的计数分布。某些样本对只靠很少的共同位点形成关系估计,即使数值看起来很高,也需要返回基因型质量和缺失模式核查。
四、截取原矩阵与重新构建,为什么都能运行却数值不同?
我们只保留前四个样本,分别执行两种操作。第一种从已经计算好的矩阵中提取子矩阵,第二种回到基因型文件,在保留样本后重新构建。两种操作都成功结束,输出也都包含四个样本,但它们对应的参考频率不同。
gcta64 --grm tiny --keep keep.id --make-grm --out subset
gcta64 --bfile tiny --keep keep.id --make-grm --out recomputed
截取矩阵保留原先由六个样本得到的频率背景,所以第一与第二个样本的关系值保持零点三五。重新构建时,参与估计频率的样本变成四个,关系值变为零点零七五。程序并没有把两种操作视为等价,这个差别来自输入定义,而不是某个结果随机出错。
这给实际分析一个明确选择。若研究方案规定使用固定参考群体形成的关系背景,就应当维护该背景,并通过明确的编号截取使用。若问题要求在当前分析群体中重新定义频率和关系结构,就应当重新构建并记录新版本。关键是把选择写清楚,而不是默认“删掉几个人不影响矩阵”。
更换性状时也需要区分缺失筛选与矩阵定义。不同性状可能有不同的有效样本集合,矩阵本身仍可来自一个预先确定的基因型群体。此时要说明背景群体与实际拟合群体分别是谁,并核对软件匹配后留下的人数。两组人数不同并不自动意味着错误,但缺少说明会让结果难以复核。
五、分块计算应当分清切的是行,还是位点
本次还将六个样本的矩阵分为两部分计算。第一部分包含前四行,第二部分包含最后两行。由于下三角中每行包含的元素数量不同,两部分分别包含十个和十一个元素,样本行数不相等并不代表任务划分错误。
gcta64 --bfile tiny --make-grm-part 2 1 --out parts
gcta64 --bfile tiny --make-grm-part 2 2 --out parts
按第一部分、第二部分的顺序连接各自的数值、位点计数和编号文件后,本次结果与一次性计算逐字节相同。这个对照验证的是按矩阵行分块的结果拼接。它不表示把不同染色体计算出的矩阵文件直接连接,也能得到全基因组关系矩阵。
两者的区别在于,按行分块时,每部分仍使用同一套位点和频率规则,只保存不同的矩阵行。按染色体分开计算时,每部分描述的是同一批样本在不同位点集合上的关系。后者涉及矩阵合并及权重问题,不能用文件连接替代统计合并。
正式分块前,应先统一样本顺序、位点筛选、输入版本和分块总数,并用一个小样本集合检查合并结果。输出文件排序也要使用明确的分块编号,不能假定任意文本排序都符合数值顺序。完成一批任务后,再检查元素总数与编号总数是否满足三角形关系。
六、稀疏矩阵保留了什么信息?
在六百样本的人工队列中,完整下三角有十八万零三百个元素。随后用零点一阈值生成稀疏矩阵,结果包含九百条记录,其中六百条是对角线,三百条对应预设的相同基因型样本对。这里用较清晰的人工结构展示保留效果,阈值不是对所有项目的推荐值。
gcta64 --bfile cohort --make-grm --out dense
gcta64 --grm dense --make-bK-sparse 0.1 --out sparse
稀疏结果中的样本索引从零开始,零对应编号文件的第一个样本。它与前面手算表格采用的从一开始编号不同。把索引起点理解错,会让所有对应关系发生偏移。读表时必须一起核对格式说明和编号文件,而不能根据自己的习惯直接补一或减一。
稀疏化改变的是模型中保留的关系结构。未保留的小关系值不代表现实中的两个人完全没有共同遗传背景,也不意味着群体分层可以忽略。实际应用仍需根据研究设计处理祖源结构、协变量和质控,不能指望一个关系阈值替代全部混杂控制。
七、效应接近,显著性却差很多,应当怎样解释?
关联阶段分别运行线性回归和使用稀疏矩阵的精确混合模型检验。表型中有一个样本缺失,年龄协变量中另有一个样本缺失,文件匹配后实际纳入五百九十八人。两种分析都输出两千个位点,因此差异不能用“其中一个流程少检验了很多位点”解释。
gcta64 --bfile cohort --pheno phen.txt --qcovar age.txt \
  --fastGWA-lr --out lr

gcta64 --bfile cohort --pheno phen.txt --qcovar age.txt \
  --grm-sparse sparse --fastGWA-mlm-exact --out mlm
预设信号位点在线性回归中的效应约一点零二四,标准误约零点一零六,概率约为四点四三乘十的负二十二次方。混合模型中的效应约一点零二八,标准误约零点一四九,概率约为五点六七乘十的负十二次方。效应估计接近,但对不确定性的估计明显变化。
由于这里人为复制了大量基因型,不能把六百行数据简单视为六百个完全独立的遗传观察。这组对照说明,同样的效应方向和相近的效应大小,可以因为相关结构处理不同而产生不同显著性。它并不证明某个方法在所有真实人群里更准确,也不能按概率更小来选模型。
我们还将带编号的表型文件完全倒序,年龄文件也使用倒序输入。混合模型输出保持一致,说明这次匹配依靠样本编号。这个行为只适用于本次输入格式和分析分支,不能推及其他软件中只有数字、没有编号的表型文件。
八、版本核验与正式分析前的判断
一个需要特别保留的失败对照,是只写混合模型参数却不给稀疏矩阵。在实测的这个版本中,程序返回错误并退出,没有自动生成可用关联结果。因此,不宜只凭网页上的简要描述推断实际分支,应该读取本机版本的日志,确认它是否真正进入预期的模型。
本次混合模型日志还给出了方差组分和遗传力样式的输出,但输入是为了教学而设计的重复基因型与人工表型,这些数字不具有人群解释。真实遗传力分析需要合适的抽样、祖源、位点选择和模型假设,不能把程序打印的一个比例直接写成性状有多少由遗传决定。
GCTA 的优势在于矩阵构建、处理和关联分析能够形成连贯流程,也便于用文件和编号逐步核对。相应的局限是,矩阵与样本集合、频率背景和模型假设联系很紧。正式扩大分析之前,先保存一个可手算的小例子,核对分母、样本匹配、分块拼接和模型日志,通常比事后解释异常结果更有效。
当关系矩阵和样本匹配规则已经核清,需要把分析扩展到更大队列或更多性状时,可了解云生信生物信息学分析环境与算力服务,按实际输入规模安排运行环境。


