
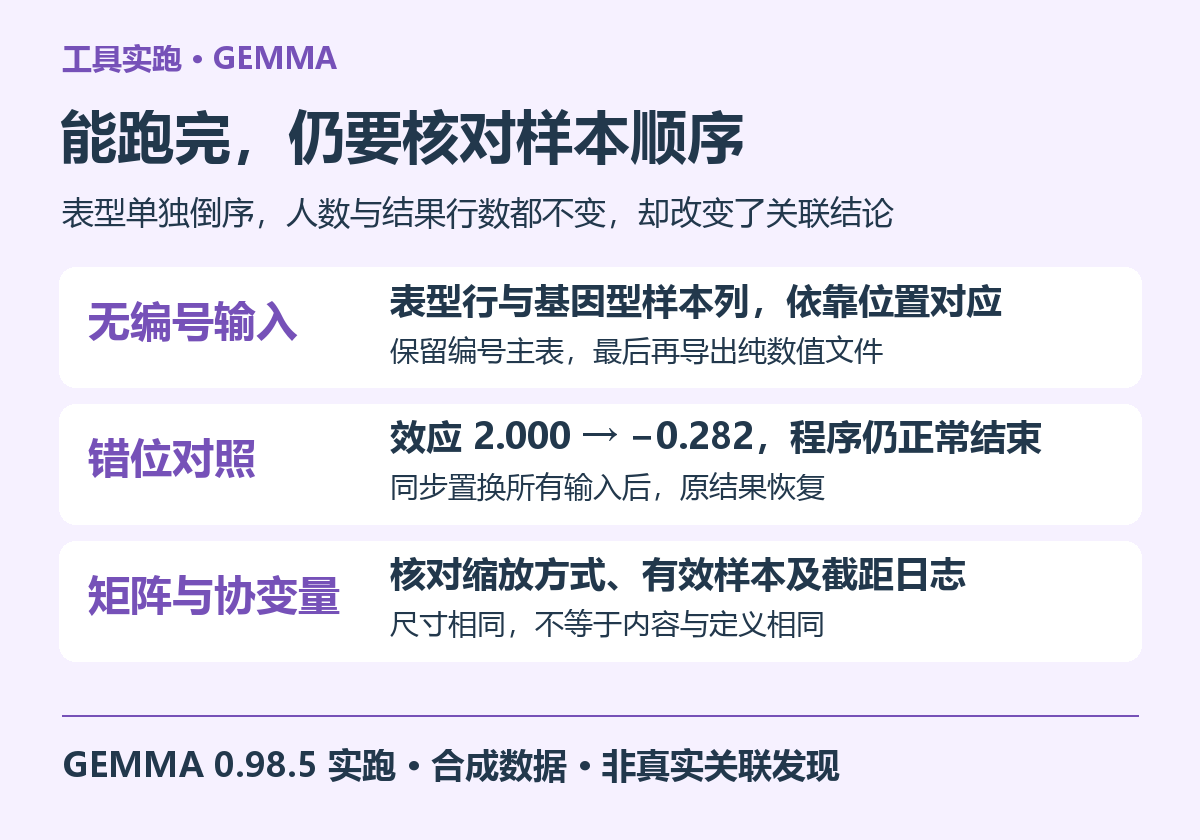
同样一份基因型,同样大小的关系矩阵,分析人数也相同,为什么一个明确设置的信号突然不见了?本次实跑只把表型文件的行顺序倒过来,GEMMA 仍正常输出六百条关联结果,但预设位点的效应从约二变成负零点二八,显著性也随之消失。
原因在于,本例使用的表型文件没有样本编号,程序按位置对应个体。行数相等只能保证文件在结构上匹配,不能保证每个数值属于正确的人。本文用实际运行结果讲清楚这种错误怎样发生,并进一步检查关系矩阵的定义、缺失样本、截距项和三种检验结果。
一、固定版本,并准备两层人工数据
本次在二〇二六年十一月十七日运行 GEMMA 0.98.5,使用固定摘要的 Linux 容器,每次限制两个逻辑处理器和四吉字节内存,并设置数值库线程数。软件功能、安装方式及许可可在官方仓库核对,输入格式依据官方手册。后文会明确指出手册描述与本次版本实际行为的一处差异。
第一层数据为六个样本和四个位点,用来手算两类关系矩阵。第二层有二百四十个样本、六百个常见变异,另加入一个单态位点和一个较高缺失率位点。我们还复制了三十组基因型,并生成两个不同的连续性状。所有数据都是教学构造,强信号是提前写进生成规则的,不是真实关联发现。
下载本组脚本与实测输出,解压后在可运行 Linux 容器的环境中执行下面的命令。脚本会自行生成输入,运行矩阵计算与多个关联对照,保存完整日志和结果,并检查同时置换全部相关输入是否保留原结果。
python3 187-gemma/run.py output-gemma
小例子只用于理解文件和模型的行为。它没有测量真实群体中的误报率,没有比较大型队列性能,也没有运行贝叶斯稀疏混合模型或多性状联合模型。选择第二个表型列分别拟合,仍然属于单性状分析,这与把两个性状放入一个联合模型应当区分。
二、只有数字的文件,如何对应到具体样本?
本例采用 BIMBAM 平均基因型格式。一行代表一个位点,前面是位点名和两个等位基因,后面依次排列每个样本的剂量。表型文件则一行代表一个样本,各列表示不同性状。协变量文件也按相同样本顺序排列,不额外附加家系号或个体号。
下面是结构示意,真正运行所需的完整数据由脚本生成。最容易误解的地方是,基因型中的样本沿列排列,表型和协变量中的样本沿行排列,两边的对应依据是位置。不能把其中一个文件单独按年龄、性状大小或样本名称排序。
基因型一行
v1,G,A,0,1,2,0,1,2

表型多列
第一列性状值  第二列性状值
每一行对应基因型中的一个样本位置
在自己的项目中,应该先在带有明确编号的主表中完成合并、去重和缺失标记,再按最终确定的样本顺序导出纯数值文件。编号清单需要作为单独的审计文件保存。删除编号列应当发生在导出的最后一步,而不是收到数据后立即丢掉名字,再依赖文件恰好排成同样顺序。
主表还应当检查一对一关系。一个样本在表型表中出现两次,可能使合并后的行数增加。某些样本缺少协变量,可能在不经意间被内连接删除。导出前同时核对总行数、唯一编号数和未匹配编号,比仅检查文件能否被软件读入更可靠。
三、矩阵尺寸正确,并不意味着样本顺序正确
默认的密集关系矩阵是一个方阵,行和列都对应样本。它同样依赖与基因型一致的顺序。本例矩阵有二百四十行、二百四十列,关联拟合实际使用二百三十八人,两者并不矛盾。矩阵保留全部样本的位置,分析时再按照所选表型和协变量的缺失情况确定有效样本。
第一性状缺失的是最后一个样本,第二性状缺失的是倒数第二个样本,年龄协变量又缺失另一个样本。所以两次分析都纳入二百三十八人,但这两百三十八人的身份并不完全相同。这是一个很实用的提醒——有效人数相等,不能替代有效样本清单相等。
如果准备复用矩阵特征分解结果,更需要维护有效样本集合和顺序。矩阵分解、表型筛选、协变量变更涉及的对象可能不同,不能因为输出文件里有相同数量的数字,就把一个性状的中间文件直接用于另一个性状。是否能复用,应按工具的输入约定及具体样本集合判断。
本次对照把所有相关对象一起倒序,包括基因型样本列、表型行、协变量行,以及关系矩阵的行和列。这样得到的全部关联结果与基准结果一致。正确的整体置换不会改变问题本身,而只改变其中一个文件,会把原本属于不同个体的信息拼到一起。
四、两种关系矩阵,改变的是位点权重
小数据分别运行中心化矩阵和标准化矩阵计算。第一种对每个位点减去平均剂量,计算样本间乘积后在位点间求平均。第二种进一步按照每个位点的基因型方差缩放,因此不同频率和变异程度的位点会获得不同权重。
gemma -g tiny.geno -p tiny.pheno -gk 1 -o tiny1
gemma -g tiny.geno -p tiny.pheno -gk 2 -o tiny2
六样本、四位点的手算中,中心化结果与软件输出的最大差异约为三点三乘十的负十一次方。用每个位点六个样本、分母为六的方差计算标准化结果时,最大差异约为三点五乘十的负十次方。这里把具体方差分母也写出来,是为了让读者能够重复核对,避免不同统计函数默认分母不同造成看似矛盾的结果。
| 样本对 | 中心化矩阵 | 标准化矩阵 |
|---|---|---|
| 第一与第二个样本 | 0.104167 | 0.202941 |
| 第一与第四个样本 | 0.020833 | −0.022059 |
| 第一个样本的对角线 | 0.812500 | 1.495588 |
可以看到,两种结果并不只是所有元素统一乘以一个常数,第二行甚至改变了符号。因为缩放发生在单个位点层面,多个位点的贡献重新加权后,总和也会改变。因此,不能把不同方法产生的矩阵仅按文件后缀改名,就认为它们表达同一套遗传背景。
实际选择需要结合研究群体和预先确定的效应假设,再检查结果的敏感性。不要在看到哪种矩阵给出更小的概率后才决定采用哪一种。对不同群体进行比较时,也应记录频率估计、缺失填补、位点过滤和缩放方式,否则相同的“关系矩阵”名称可能隐藏不同定义。
这也说明,跨软件替换矩阵必须核对公式。一个工具使用观测基因型方差,另一个流程可能依据等位基因频率构造标准化分母。数值不同并不自动表示其中一个软件计算有误。最好的起点是用少量完整基因型手算一个非对角线元素,再扩展到完整矩阵。
五、关联分析正常完成后,先核对人数和位点数
本例的六百零二个输入位点中,一个位点所有样本基因型相同,另一个位点前二十四个样本缺失。按此次默认过滤设置,最终分析六百个位点。输出行数因此少于原始位点数,这种减少可以从预先设置的对照和软件日志解释。
gemma -g toy.geno -a toy.anno -p pheno.txt -c cov.txt \
  -n 1 -gk 1 -o kinship

gemma -g toy.geno -a toy.anno -p pheno.txt -c cov.txt \
  -n 1 -k output/kinship.cXX.txt -lmm 4 -o base
单态位点没有可用于关联比较的基因型变异。高缺失位点则需要结合分析样本集合计算缺失比例,不能只看全体输入样本的一个总体数字。特别是在多个性状分别分析时,有效样本的变化可能让同一位点在不同分析中通过或未通过过滤。
结果中的缺失计数字段也要按含义理解。预设信号位点的 n_miss 为零,表示该结果记录的基因型缺失计数为零,并不是实际样本数为零,更不是所有数据文件都没有缺失。实际拟合人数需要从日志中的纳入信息核对,本例为二百三十八人。
本次三十组重复基因型还带来了接近零的矩阵特征值警告。程序在这些对照中完成了拟合,但不能因此把所有此类警告都当成无关信息。真实项目遇到类似提示,应检查重复个体、克隆材料、矩阵秩和构建过程,确认它是否对应已知的数据结构。
六、把表型单独倒序,会得到什么结果?
基准分析中,预设位点的效应约为二点零零零一,标准误约零点一三二三,瓦尔德检验概率约为一点六六乘十的负三十六次方。这个信号来自人工设定,作用是给流程提供一个方向和量级明确的检查点。
只将表型文件倒序后,软件仍成功结束,仍使用二百三十八个样本并输出六百个位点。但同一个位点的效应变为负零点二八二四,标准误约零点一九六七,瓦尔德检验概率约零点一五二。人数、位点数和退出状态都没有直接揭示错位。
| 输入操作 | 信号位点效应 | 瓦尔德检验概率 |
|---|---|---|
| 基准输入 | 2.000113 | 约 1.66×10^-36 |
| 只倒序表型 | −0.282409 | 约 0.152 |
| 所有样本索引同步倒序 | 2.000113 | 约 1.66×10^-36 |
这组结果不能用于估计错位后会出现多大偏差,因为不同数据的结果可能完全不同。它证明的是一种结构性风险——无编号文件的错位可以无声地通过格式检查。真实项目也不一定会出现明显信号消失,有时可能产生难以察觉的偏差,甚至产生人为关联。
因此,不能把显著位点“看起来合理”作为顺序正确的唯一证据。应在导出时留下编号顺序、文件校验值和样本匹配报告,必要时抽查几个样本的原始数值。先证明对应关系正确,再讨论生物学意义,才能避免把数据整理错误写成性状机制。
七、截距项要结合实际版本检查
官方手册提醒,在提供协变量文件时应显式加入全一列。我们按照这一方式建立基准输入,又专门运行只有年龄、没有全一列的对照。在本次版本中,日志明确提示自动添加了一列截距,最终结果与基准输出完全一致。
这意味着,不能把手册中的旧描述直接当成所有版本的实际行为,也不能反过来推断以后任何输入都能依赖自动修正。稳妥做法仍是明确设计矩阵,知道自己要调整哪些变量、截距如何表示,并在日志中核对协变量数量和自动处理信息。
协变量设计还涉及连续变量、分类变量编码以及是否存在完全共线。本例只用年龄解释输入规则,没有替读者验证祖源主成分、批次、亲缘结构及其他混杂因素该如何组合。自动补截距解决的是一个具体格式问题,不等于整个统计模型已经适合研究问题。
八、三种概率列不是让人挑最显著的一列
本次指定同时计算瓦尔德、似然比和得分检验。预设信号的前两种概率约处于十的负三十六次方量级,得分检验约处于十的负二十二次方量级。这些差异在同一运行中真实存在,不能把其中一列缺少更多零解释成程序漏算。
不同检验构造统计量的方式不同,在有限样本、强信号或特定模型条件下,不必得到完全相同的概率。应根据预定分析方案选择主要检验,并把其他结果用作敏感性检查。事后逐个位点挑最小的一列,会改变分析规则,也使多重检验解释变得困难。
GEMMA 的优点是输入格式相对清楚,矩阵和模型步骤容易拆开核查,并提供多种模型与检验。它对用户提出的要求也很明确——维护样本顺序、理解矩阵定义、核对有效样本和模型日志。本例最后恢复原结果的方法,是让全部输入重新对应到同一批个体,而不是放宽阈值或追逐更小的概率。
当样本顺序、矩阵定义和协变量设计已经验证,需要批量分析多个性状时,可了解云生信生物信息学分析环境与算力服务,在保留完整输入记录的基础上扩展计算。


